测量 · ·
Defuddle、Readability 与 MarkSnip 对比:测了什么,结果如何
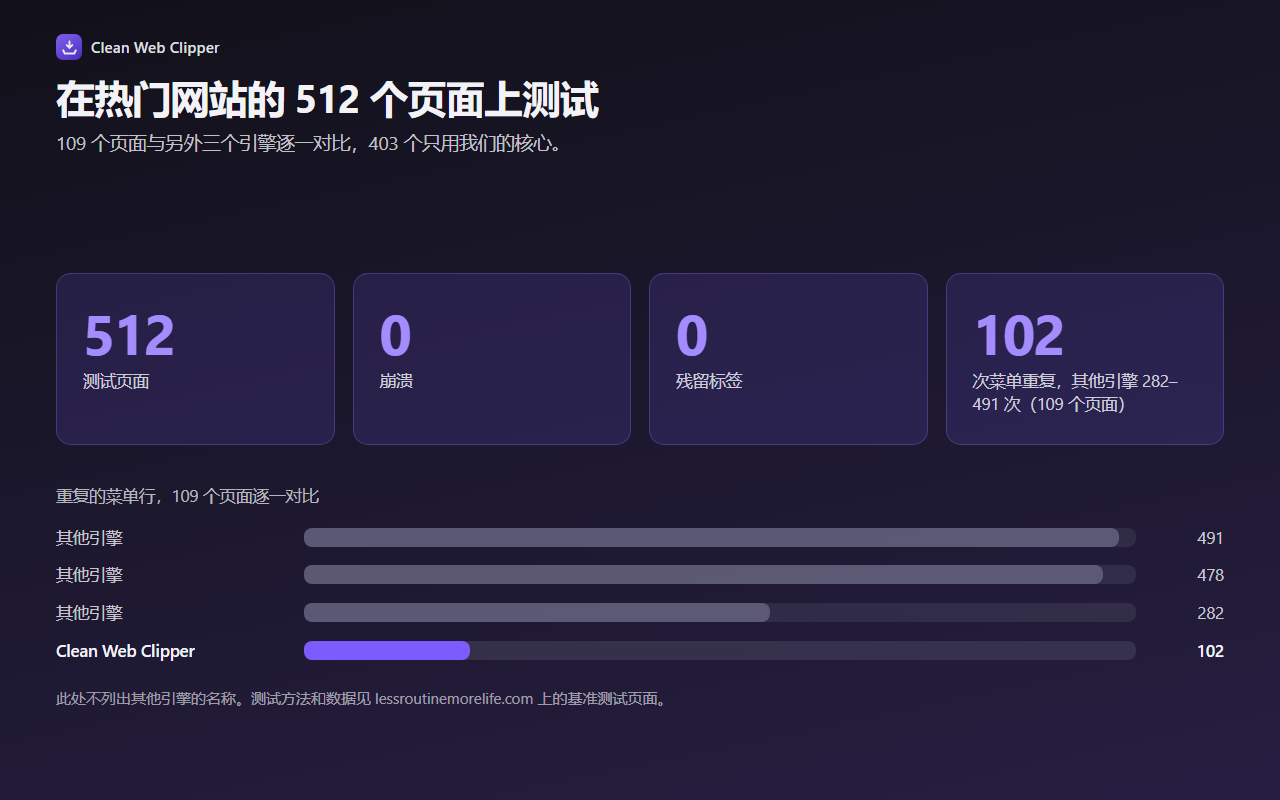
Clean Web Clipper 于 2026 年 8 月底在 512 个页面上接受测试:109 个与另外三个引擎逐一对比,403 个只用我们的核心处理。没有崩溃,提取的文章中没有残留 HTML 标签。语料和脚本将随下一轮测试公布;在那之前,本基准测试页面就是完整记录。
四个引擎如何在同样 109 个页面上对比?
在同样 109 个页面上,Clean Web Clipper 留下的重复菜单行最少:102 行,其他三个引擎为 282–491 行,而且没有崩溃。语料来自全球和俄罗斯访问量最高的各一百个网站。非内容类域名(即时通讯、网上银行、流媒体、政府门户)事先已排除。页面用真实浏览器抓取,只要首页上有内容链接,就顺着它打开一个内容页面。
四个引擎处理同样的 109 个抓取页面:Defuddle 0.19.3 加 Turndown 7.2.4(官方 Obsidian Web Clipper 的核心)、Mozilla Readability 0.6.0 加同一个 Turndown(MarkDownload 的核心)、MarkSnip 5.2.0(它实际发布的代码,从 Chrome 应用商店的安装包中解压得到),以及 Clean Web Clipper 0.1.0。
| 指标 | Defuddle 0.19.3 | Mozilla Readability 0.6.0 | MarkSnip 5.2.0 | Clean Web Clipper 0.1.0 |
|---|---|---|---|---|
| 页面 | 109 | 107 | 107 | 109 |
| 崩溃 | 0 | 2 | 2 | 0 |
| 残留 HTML | 532 | 718 | 2 | 0 |
| 重复的菜单行 | 491 | 282 | 478 | 102 |
| 短行比例 | 0.278 | 0.262 | 0.263 | 0.221 |
| 识别出的作者 | 23 | 27 | 28 | 28 |
| 识别出的发布日期 | 28 | 13 | 13 | 24 |
| 提取出的表格(共 56 个) | 3 | 8 | 11 | 5 |
| 有用文本占比 | 0.878 | 0.931 | 0.934 | 0.890 |
Defuddle 0.19.3 是官方 Obsidian Web Clipper 的核心,见 github.com/kepano/defuddle;Mozilla Readability 0.6.0 是 MarkDownload 的核心,见 github.com/mozilla/readability;两者都搭配 Turndown 7.2.4 完成 Markdown 转换。MarkSnip 5.2.0 运行的是它 Chrome 应用商店安装包中的真实代码,解压后用桩代码替代浏览器 API 运行。第一个语料是 Similarweb 的全球前 100 名(2026 年 5 月),以及 Similarweb、Semrush 和 Mediascope 的俄罗斯互联网前 100 名(2026 年);第二个语料是十二个欧洲国家各自排名前五十的网站。
查看 Clean Web Clipper 落后的地方
- 表格:5 个,MarkSnip 是 11 个。 56 个源表格中有 41 个在同一个页面上,而且是排版用的表格而不是内容,任何引擎都不应该提取它们;真正的差距在少数几个页面上,我们的根节点选择选中的区块太窄。
- 有用文本占比:0.890,对方 0.934。 一部分是有意为之(它会拒绝其他引擎照样返回的信息流页面),另一部分同样是根节点选得太窄。
- 发布日期:24 个,Defuddle 是 28 个。
- 作者:与最好的持平,28 个,MarkSnip 也是 28 个,这是重做作者提取之后的结果。这个语料第一次评分时是 20 个。
查看核心在十二种欧洲语言 403 个页面上的结果
十二个国家各自排名前五十的网站,抓取时浏览器语言设为该国语言,否则其中一半会返回英文页面,测到的就是别的东西了。
403 个页面中有 152 个得到的回答是“没有文章”:商店首页、门户首页和信息流,这些页面上没有可提取的文章。这个回答是有意为之的,这也是这些页面被计为“已测试”而不是“已剪藏”的原因。如果你需要的文章被拒绝了,那就是 bug:这里说明如何报告这个页面。
| 语言 | 页面 | 崩溃 | 残留 HTML | 链接占比 |
|---|---|---|---|---|
| 德语 | 40 | 0 | 0 | 0.058 |
| 法语 | 39 | 0 | 0 | 0.050 |
| 西班牙语 | 40 | 0 | 0 | 0.060 |
| 意大利语 | 40 | 0 | 0 | 0.036 |
| 波兰语 | 30 | 0 | 0 | 0.064 |
| 葡萄牙语 | 36 | 0 | 0 | 0.060 |
| 荷兰语 | 37 | 0 | 0 | 0.049 |
| 土耳其语 | 31 | 0 | 0 | 0.042 |
| 乌克兰语 | 13 | 0 | 0 | 0.054 |
| 捷克语 | 28 | 0 | 0 | 0.039 |
| 瑞典语 | 28 | 0 | 0 | 0.036 |
| 罗马尼亚语 | 41 | 0 | 0 | 0.039 |
每个页面 4 分 38 秒是怎样计算的?
lessroutinemorelife.com 上的计数器为你对其做过操作(复制、保存、打印或发送到 AI 聊天)的每个页面按 4 分 38 秒计算,每个页面每天只计一次。打开窗口不算节省,计为零。这个时间由所有者手动计时得出(2026 年,1,000 多个不同的内容页面):复制文本、粘贴、清理、加上标题和来源,再检查有没有残留的 HTML 标记。平均值和中位数都计算过。
因此,计数器显示的是这类页面的数量乘以这个时间,而不是每次操作用秒表计时的总和。它并不测量某一个页面原本会花掉你多少时间。
了解这些指标的含义
- 崩溃:引擎在页面上抛出错误,什么也没有返回。没有崩溃的一轮测试,结果里仍可能满是菜单;那正是其他几行要测量的。
- 残留的 HTML 标签:有多少原始标记被带进了 Markdown。只要大于零就是缺陷。
- 重复的菜单行:长度超过十二个字符、出现不止一次的行。这就是在每个版块重复出现的导航。
- 短行比例:短于二十五个字符的行所占的比例。比例高说明剪下来的是链接列表,而不是正文。
- 链接占比:位于链接文字中的字符所占的比例。比例高说明菜单被一起带进来了。
- “没有文章”:页面上没有文章正文,所以扩展程序直说,而不是返回链接。它既不算崩溃,也不算一次剪藏。
了解这次测量的局限
- 乌克兰语样本是 13 个页面,而不是 40 个:从抓取地点访问时,大部分语料没有响应。这一行只能作为参考。
- 土耳其和捷克的前五十名网站以商店和时刻表居多,这些页面根本不带发布日期。这是语料的特点,而不是提取的问题。
- 竞争引擎只在第一个语料上运行过。欧洲那一轮只测量了 Clean Web Clipper。
- 所有引擎返回的内容都少于 500 个字符的页面被排除在外:那是验证码或访问拦截,与提取质量无关。
- 两轮测试都是 2026 年 8 月底对在线网站拍下的快照。以后用同样的脚本再跑,随着这些网站的变化,数字会有所不同。
复现这次基准测试
第一轮于 2026 年 8 月 30 日抓取并评分,第二轮于 2026 年 8 月 31 日,环境为 Node 24、jsdom 29.1.1 和 Playwright 1.62.1(Chromium)。版本:Defuddle 0.19.3、Mozilla Readability 0.6.0、MarkSnip 5.2.0、Turndown 7.2.4 加 turndown-plugin-gfm 1.0.2、Clean Web Clipper 0.1.0。第一轮依次运行三个脚本:capture-top.mjs、run-engines.mjs、score-top.mjs;第二轮是 capture-eu.mjs 之后运行 score-eu.mjs。这些脚本尚未公开:它们将随下一轮测试以代码仓库形式发布,不包含抓取下来的第三方页面。汇总结果已经可以下载:benchmark.json。