Medición · ·
Defuddle vs Readability vs MarkSnip: qué se midió y qué salió
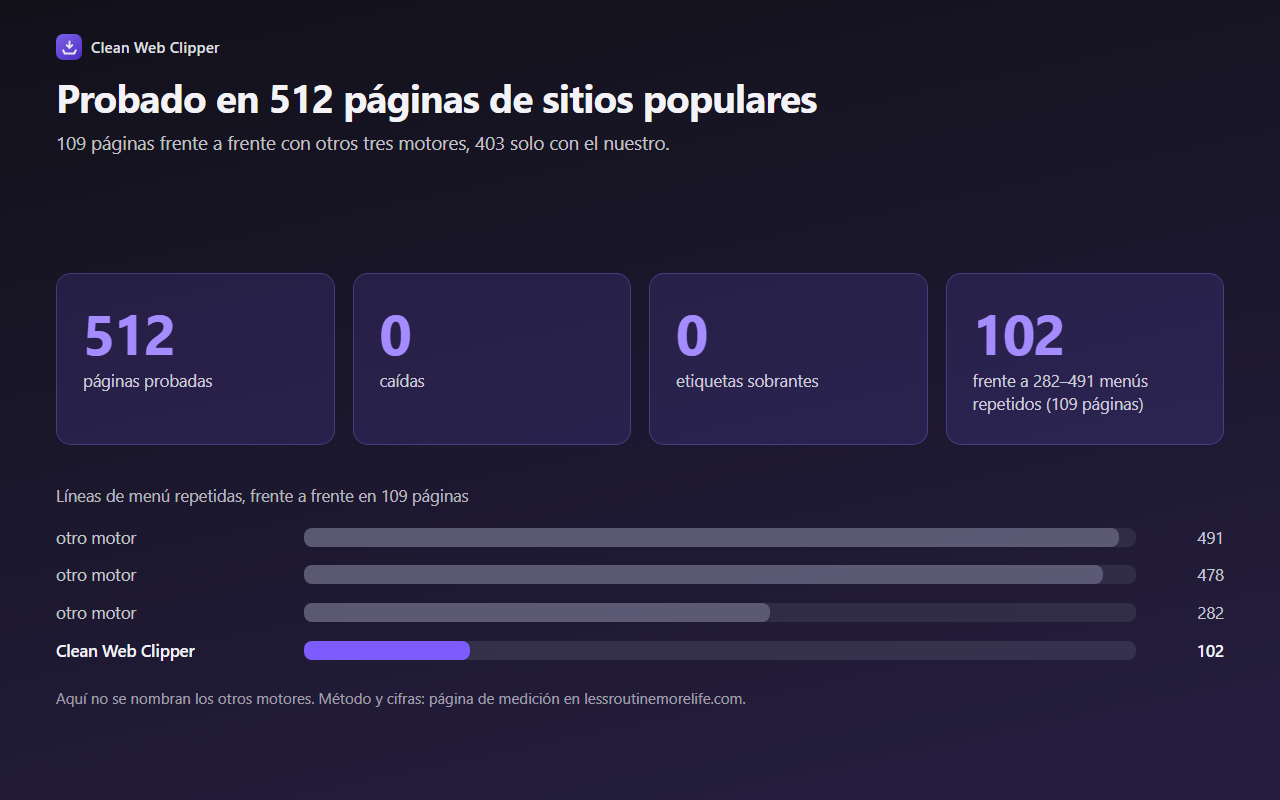
Clean Web Clipper se probó en 512 páginas a finales de agosto de 2026: 109 frente a frente con otros tres motores y 403 solo con nuestro núcleo. Ninguna caída y ninguna etiqueta HTML sobrante en ningún artículo extraído. El corpus y los scripts se publicarán con la próxima pasada; hasta entonces, esta página es el registro completo.
¿Cómo se compararon cuatro motores sobre las mismas 109 páginas?
Sobre las mismas 109 páginas, Clean Web Clipper dejó menos líneas de menú duplicadas que ningún otro motor: 102, frente a 282–491 de los otros tres, y sin caídas. El corpus son los cien sitios más visitados del mundo y los cien más visitados de Rusia, sin los dominios sin contenido (mensajería, banca, streaming, portales de la administración). Las páginas se capturaron con un navegador real, siguiendo desde cada portada un enlace a contenido.
Cuatro motores recorrieron las mismas 109 páginas capturadas: Defuddle 0.19.3 con Turndown 7.2.4 (el núcleo del Obsidian Web Clipper oficial), Mozilla Readability 0.6.0 con el mismo Turndown (el núcleo de MarkDownload), MarkSnip 5.2.0 – su código real, desempaquetado de su compilación para Chrome Web Store – y Clean Web Clipper 0.1.0.
| Métrica | Defuddle 0.19.3 | Mozilla Readability 0.6.0 | MarkSnip 5.2.0 | Clean Web Clipper 0.1.0 |
|---|---|---|---|---|
| Páginas | 109 | 107 | 107 | 109 |
| Caídas | 0 | 2 | 2 | 0 |
| HTML sobrante | 532 | 718 | 2 | 0 |
| Líneas de menú duplicadas | 491 | 282 | 478 | 102 |
| Proporción de líneas cortas | 0.278 | 0.262 | 0.263 | 0.221 |
| Autores encontrados | 23 | 27 | 28 | 28 |
| Fechas de publicación encontradas | 28 | 13 | 13 | 24 |
| Tablas extraídas (de 56) | 3 | 8 | 11 | 5 |
| Proporción de texto útil | 0.878 | 0.931 | 0.934 | 0.890 |
Cada motor de la comparación se puede comprobar en su origen. Defuddle 0.19.3, el núcleo del Obsidian Web Clipper oficial, está en github.com/kepano/defuddle; Mozilla Readability 0.6.0, el núcleo de MarkDownload, está en github.com/mozilla/readability; los dos se ejecutaron con Turndown 7.2.4 para el paso a Markdown. MarkSnip 5.2.0 se ejecutó como el código real de su compilación de Chrome Web Store, desempaquetado y con sustitutos en lugar de la API del navegador. El primer corpus es el top 100 mundial de Similarweb (mayo de 2026) y el top 100 de Runet según Similarweb, Semrush y Mediascope (2026); el segundo, los cincuenta sitios más visitados de cada uno de doce países europeos.
Mira dónde va por detrás Clean Web Clipper
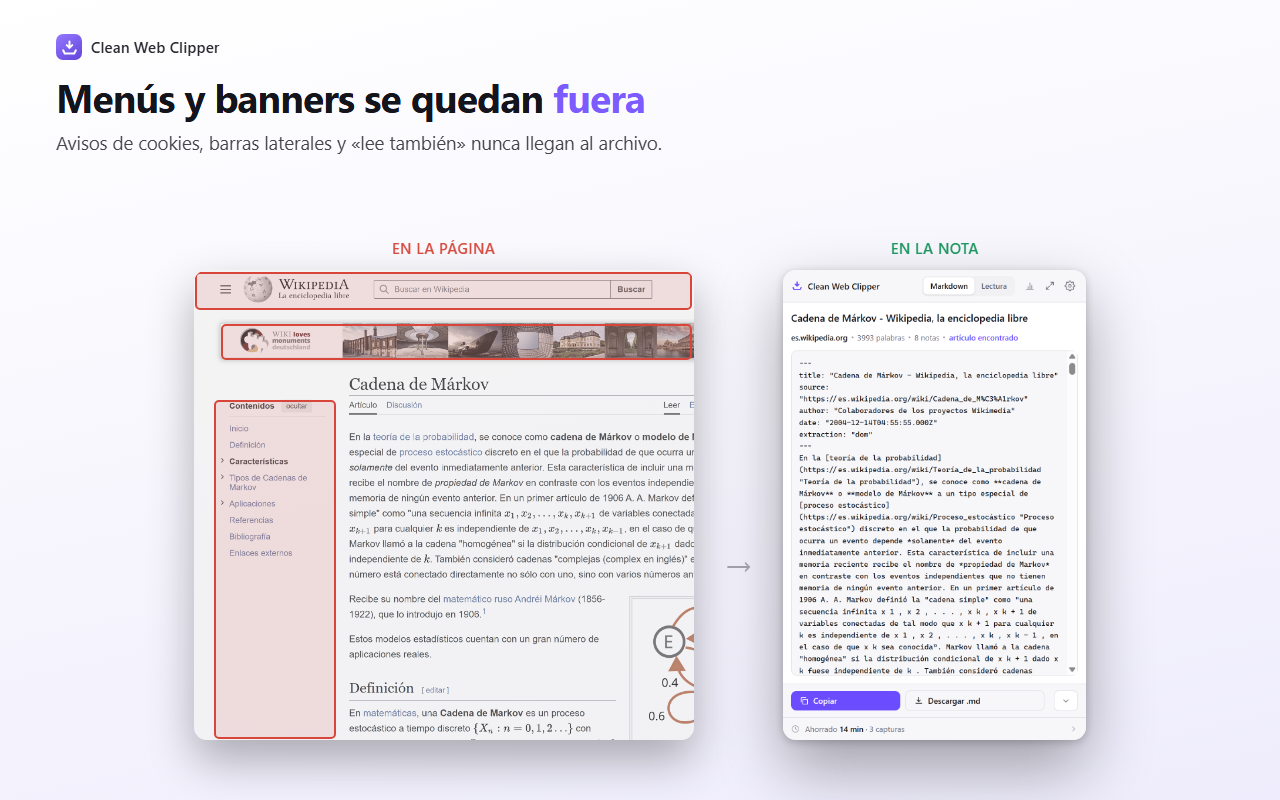
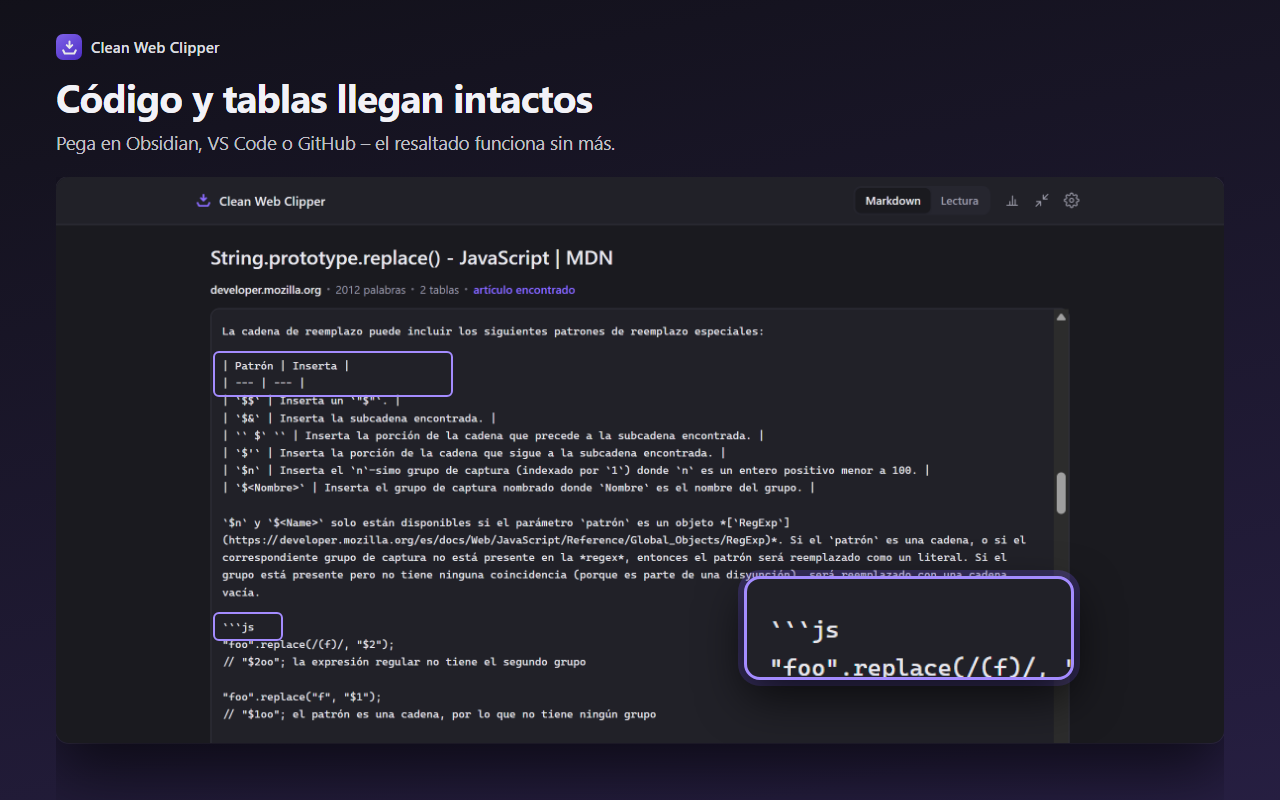
- Tablas: 5 frente a 11 de MarkSnip. 41 de las 56 tablas de origen están en una sola página y son de maquetación, no de contenido, y ningún motor debería extraerlas; la diferencia real es un puñado de páginas en las que nuestra selección de raíz elige un bloque demasiado estrecho.
- Proporción de texto útil: 0.890 frente a 0.934. Una parte es deliberada – rechaza páginas de tablón que otros motores devuelven – y otra parte es esa misma raíz demasiado estrecha.
- Fechas de publicación: 24 frente a 28 de Defuddle.
- Autores: a la par con el mejor, 28 frente a 28 de MarkSnip, después de rehacer la extracción de autores. En la primera puntuación de este corpus eran 20.
Consulta el resultado del núcleo en 403 páginas de doce idiomas europeos
Los cincuenta sitios más visitados de cada uno de doce países, capturados con el navegador puesto en el idioma de ese país, porque si no la mitad sirven una página en inglés y lo que se mide es otra cosa.
152 de las 403 páginas respondieron «sin artículo»: escaparates de tiendas, portadas de portales y tablones, donde no hay artículo que extraer. Esa respuesta es deliberada, y por eso estas páginas cuentan como probadas y no como capturadas. En un artículo que necesitas, una negativa es un error: así se informa de la página.
| Idioma | Páginas | Caídas | HTML sobrante | Proporción de enlaces |
|---|---|---|---|---|
| Alemán | 40 | 0 | 0 | 0.058 |
| Francés | 39 | 0 | 0 | 0.050 |
| Español | 40 | 0 | 0 | 0.060 |
| Italiano | 40 | 0 | 0 | 0.036 |
| Polaco | 30 | 0 | 0 | 0.064 |
| Portugués | 36 | 0 | 0 | 0.060 |
| Neerlandés | 37 | 0 | 0 | 0.049 |
| Turco | 31 | 0 | 0 | 0.042 |
| Ucraniano | 13 | 0 | 0 | 0.054 |
| Checo | 28 | 0 | 0 | 0.039 |
| Sueco | 28 | 0 | 0 | 0.036 |
| Rumano | 41 | 0 | 0 | 0.039 |
¿Cómo se cuenta el tiempo por página de 4 min 38 s?
El contador de lessroutinemorelife.com cuenta 4 min 38 s por cada página con la que hiciste algo – copiarla, guardarla, imprimirla o mandarla a un chat de IA –, una vez al día por página. Abrir la ventana no es un ahorro y no cuenta. Ese tiempo lo cronometró a mano el propietario (2026, más de 1000 páginas de contenido variado): copiar el texto, pegarlo, limpiarlo, añadir el título y el origen, y revisar si quedaba marcado HTML.
Se calcularon la media y la mediana. Por tanto, el contador es el número de esas páginas multiplicado por ese tiempo, no una suma de cronometrajes de cada una. No mide cuánto te habría llevado a ti una página concreta.
Entiende qué significan las métricas
- Caídas – el motor lanzó un error en la página y no devolvió nada. Una pasada sin caídas puede seguir llena de menús; eso es lo que miden las otras filas.
- Etiquetas HTML sobrantes – cuánto marcado en bruto sobrevivió dentro del Markdown. Cualquier cifra por encima de cero es un defecto.
- Líneas de menú duplicadas – líneas de más de doce caracteres que aparecen más de una vez. Es la navegación repetida en cada sección.
- Proporción de líneas cortas – la parte de líneas de menos de veinticinco caracteres. Alta significa listas de enlaces capturadas en lugar de prosa.
- Proporción de enlaces – la parte de caracteres que quedan dentro de etiquetas de enlace. Alta significa que se coló un menú.
- «Sin artículo» – la página no contenía cuerpo de artículo, así que la extensión lo dijo en lugar de devolver enlaces. No es ni una caída ni una captura.
Conoce los límites de esta medición
- La muestra ucraniana son 13 páginas, no 40: la mayor parte del corpus no respondió desde el punto de captura. Esa fila es solo indicativa.
- Las listas de los cincuenta primeros sitios turcos y checos se inclinan hacia tiendas y horarios, que no llevan ninguna fecha de publicación. Es una propiedad del corpus, no de la extracción.
- Los motores competidores solo se ejecutaron sobre el primer corpus. La pasada europea mide únicamente a Clean Web Clipper.
- Se excluyeron las páginas en las que todos los motores devolvieron menos de 500 caracteres: eso es un captcha o un bloqueo, no calidad de extracción.
- Las dos pasadas son instantáneas de sitios vivos tomadas a finales de agosto de 2026. Los mismos scripts, ejecutados más adelante, darán cifras algo distintas a medida que esos sitios cambien.
Reproduce la medición
La primera pasada se capturó y puntuó el 30 de agosto de 2026 y la segunda el 31 de agosto de 2026, con Node 24, jsdom 29.1.1 y Playwright 1.62.1 (Chromium). Versiones: Defuddle 0.19.3, Mozilla Readability 0.6.0, MarkSnip 5.2.0, Turndown 7.2.4 con turndown-plugin-gfm 1.0.2 y Clean Web Clipper 0.1.0. La primera pasada son tres scripts en orden – capture-top.mjs, run-engines.mjs, score-top.mjs – y la segunda es capture-eu.mjs seguido de score-eu.mjs. Los scripts aún no son públicos: se publicarán como repositorio con la próxima pasada, sin las páginas de terceros capturadas. Los resultados agregados ya están disponibles en benchmark.json.