Estensione per Chrome ·
Salvare una pagina web in Markdown che non devi ripulire
Clean Web Clipper salva una pagina web in Markdown con un clic sull’icona: titolo, autore, data di pubblicazione e indirizzo della fonte finiscono nel frontmatter, il testo arriva senza navigazione. Tutto avviene dentro il browser: nessun account, e il testo della pagina non lo lascia mai.
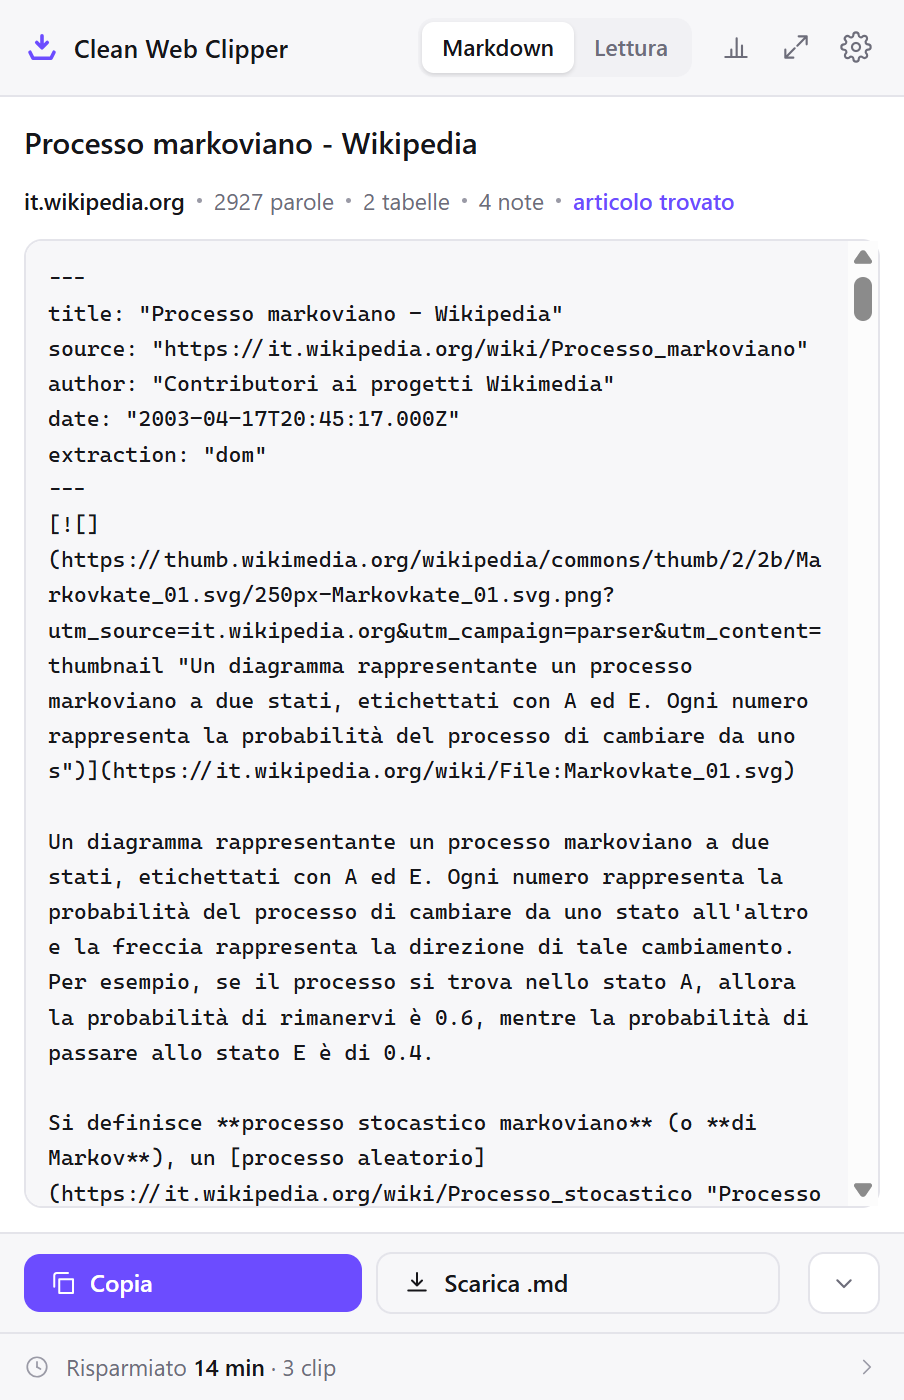
Clean Web Clipper è un’estensione gratuita per Chrome che salva una pagina web in Markdown pulito – negli appunti, in un file .md, in una cartella o direttamente in un vault di Obsidian – senza account e senza accesso. Provata su 512 pagine dei siti più visitati: nessun crash e nessun tag HTML rimasto in nessun articolo estratto.
Provato su 512 pagine dei siti più visitati al mondo
Due prove. La prima ha preso 109 pagine dai cento siti più visitati al mondo e in Russia e ha confrontato il risultato con altri tre motori di estrazione. La seconda ha preso i primi cinquanta siti di dodici paesi europei: altre 403 pagine, ognuna catturata nella lingua del paese e passata soltanto nel nostro core. Motori, versioni, date e dove resta indietro
Il problema non è mai la conversione. È tutto quello che viene dietro.
Qualsiasi clipper trasforma l’HTML in Markdown. Poi apri la nota e ci trovi la fascia dei cookie, il menu laterale, un elenco «Leggi anche» e una tabella che si è sfaldata per strada. Clean Web Clipper è costruito proprio intorno alla rimozione di tutto questo, e la rimozione è misurata, non dichiarata.
quello che tengono gli altri clipper
[Vai al contenuto](#main) [Accedi](/login) [Registrati](/registrazione)
[Home](/) [Cronaca](/cronaca) [Sport](/sport) [Cultura](/cultura) [Altro](/altro)

Usiamo cookie e tecnologie simili per migliorare la tua esperienza.
[Accetta tutti] [Gestisci preferenze]

# L’articolo per cui sei venuto

Il primo, vero paragrafo del testo.

<div class="promo-inline">

## Leggi anche
[Un altro titolo](/a) [Un altro ancora](/b) [E un terzo](/c)
quello che finisce nella nota
# L’articolo per cui sei venuto

Il primo, vero paragrafo del testo.
Che cosa rende pulito il risultato
- Il codice mantiene il linguaggio. Il blocco esce marcato
js, non nudo: l’evidenziazione funziona appena incolli. - Le tabelle restano intere. Una cella con del codice o un elenco non spezza più la riga.
- Le note funzionano davvero. I rimandi diventano
[^1]con le definizioni in fondo alla nota, non àncore morte. - La data si legge, non si indovina. JSON-LD,
article:published_time,citation_date(lo standard di arXiv, PubMed e IEEE),time[datetime], marcatori Unix. Se sulla pagina non c’è una data, il campo resta vuoto: mai la data di oggi. - Menu, banner e «leggi anche» vengono tagliati. Fasce di loghi, paginatori e navigazione ripetuta in ogni sezione non arrivano mai nella nota.
- Nemmeno un tag di troppo. Nessun
divotablepiantato in mezzo al testo.
---
title: "Catena di Markov - Wikipedia"
source: "https://it.wikipedia.org/wiki/Catena_di_Markov"
date: "2004-03-11T09:26:53.000Z"
extraction: "dom"
---

Una catena di Markov è un processo stocastico in cui la probabilità di
transizione verso uno stato del sistema dipende soltanto dallo stato
immediatamente precedente.[^1]

[^1]: Markov, A. A. (1906). Estensione della legge dei grandi numeri a
      grandezze dipendenti l’una dall’altra.
Come salvare una pagina web in Markdown in Chrome
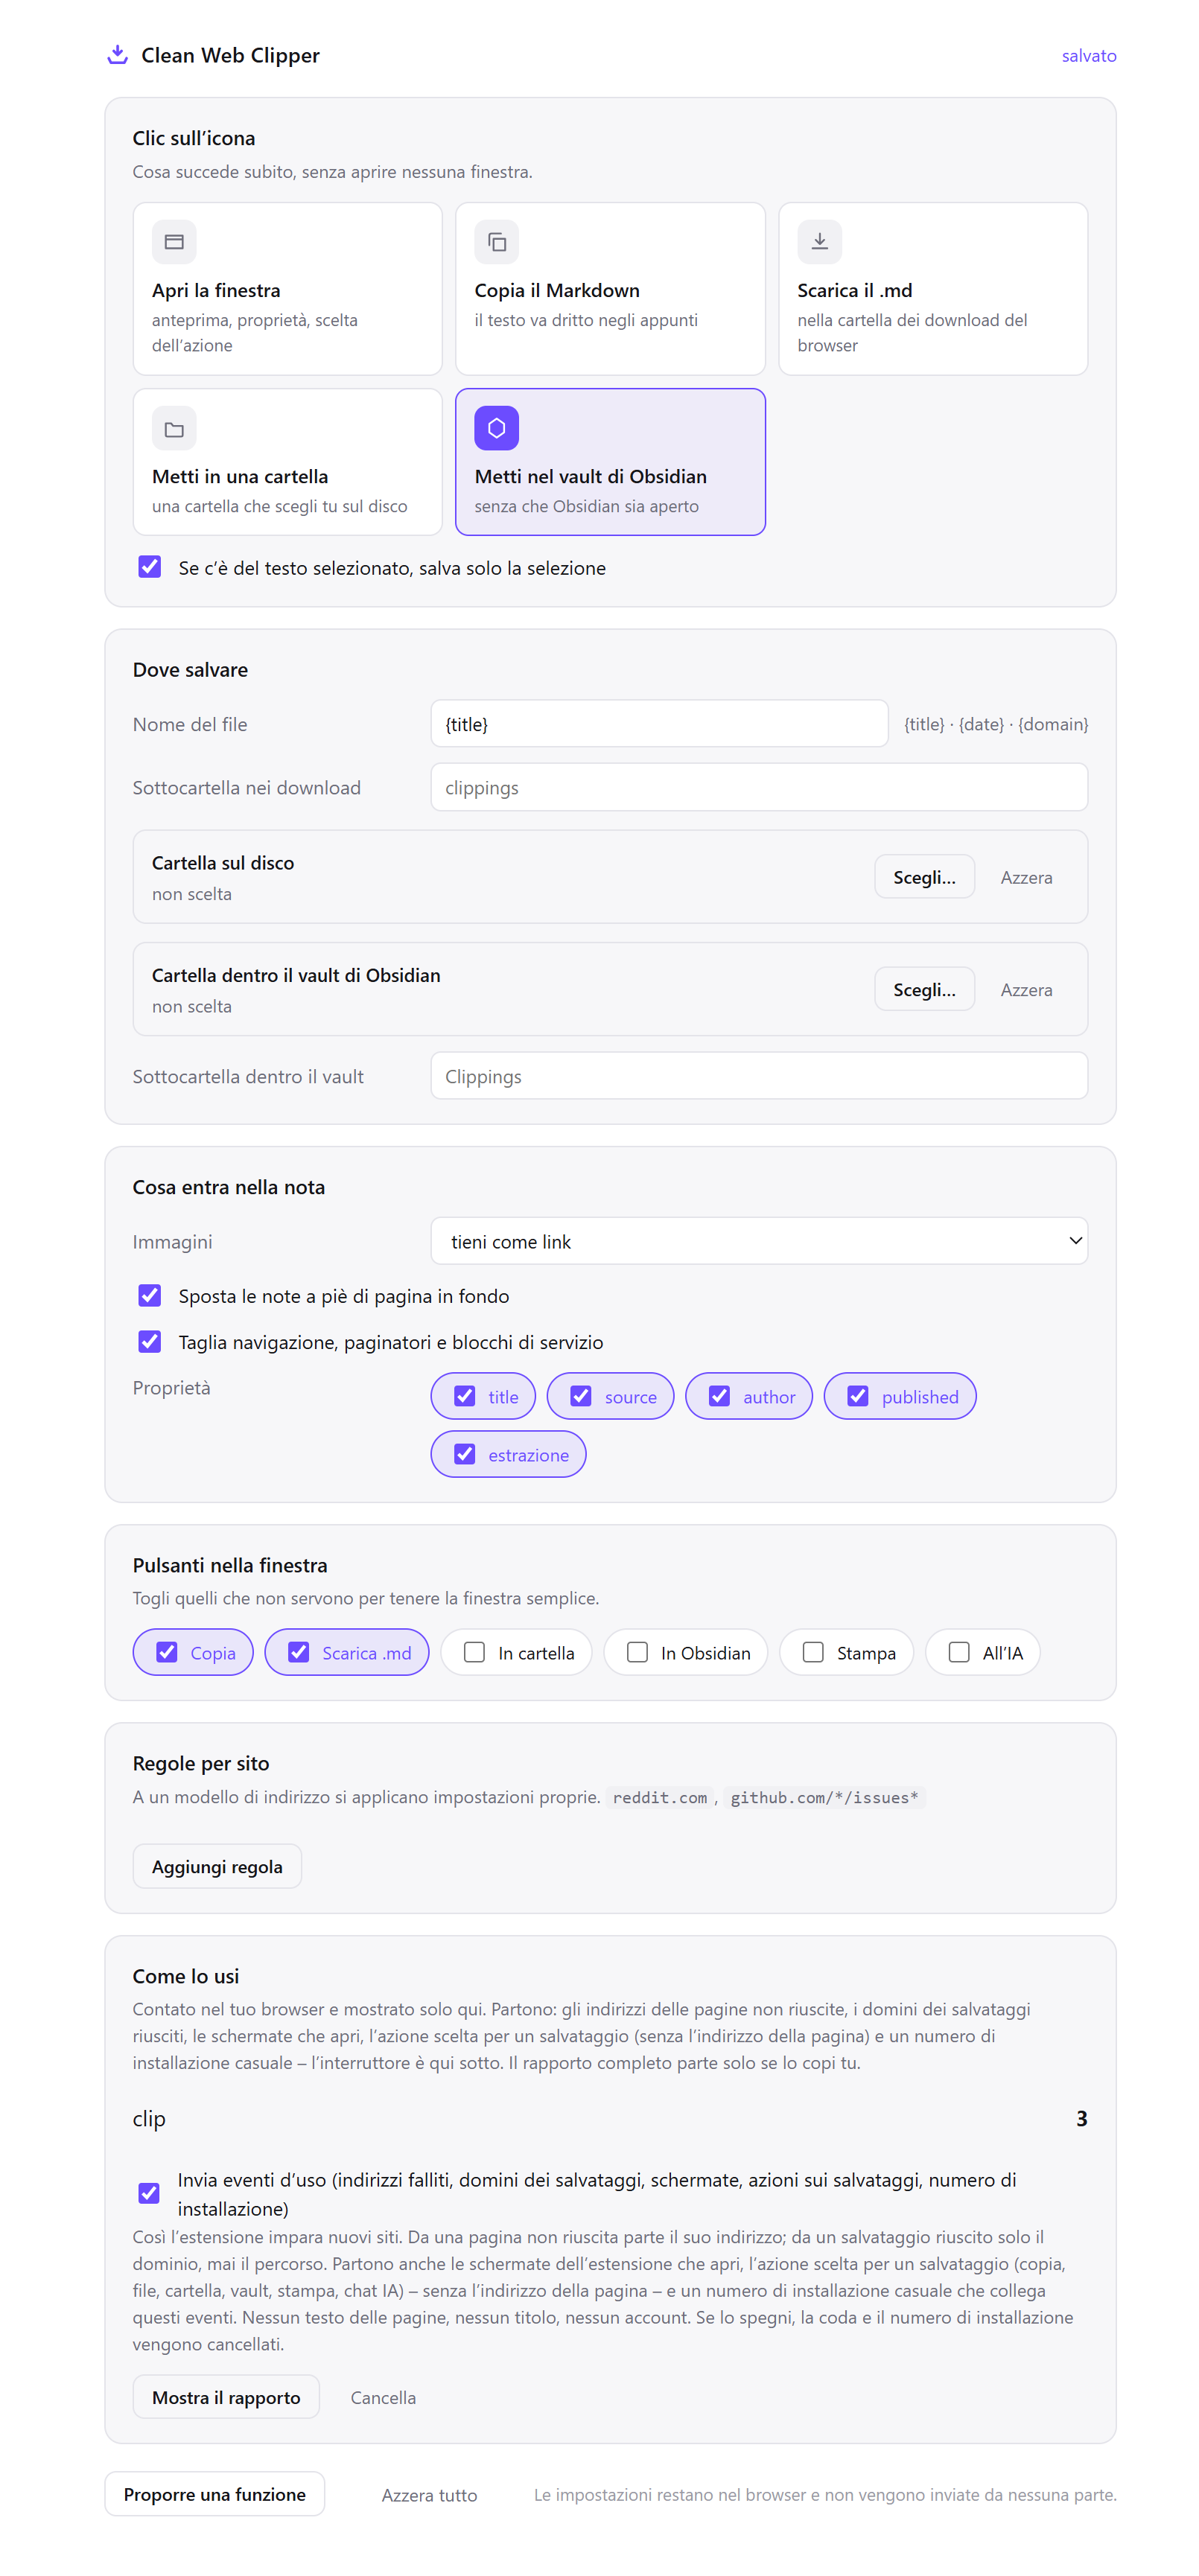
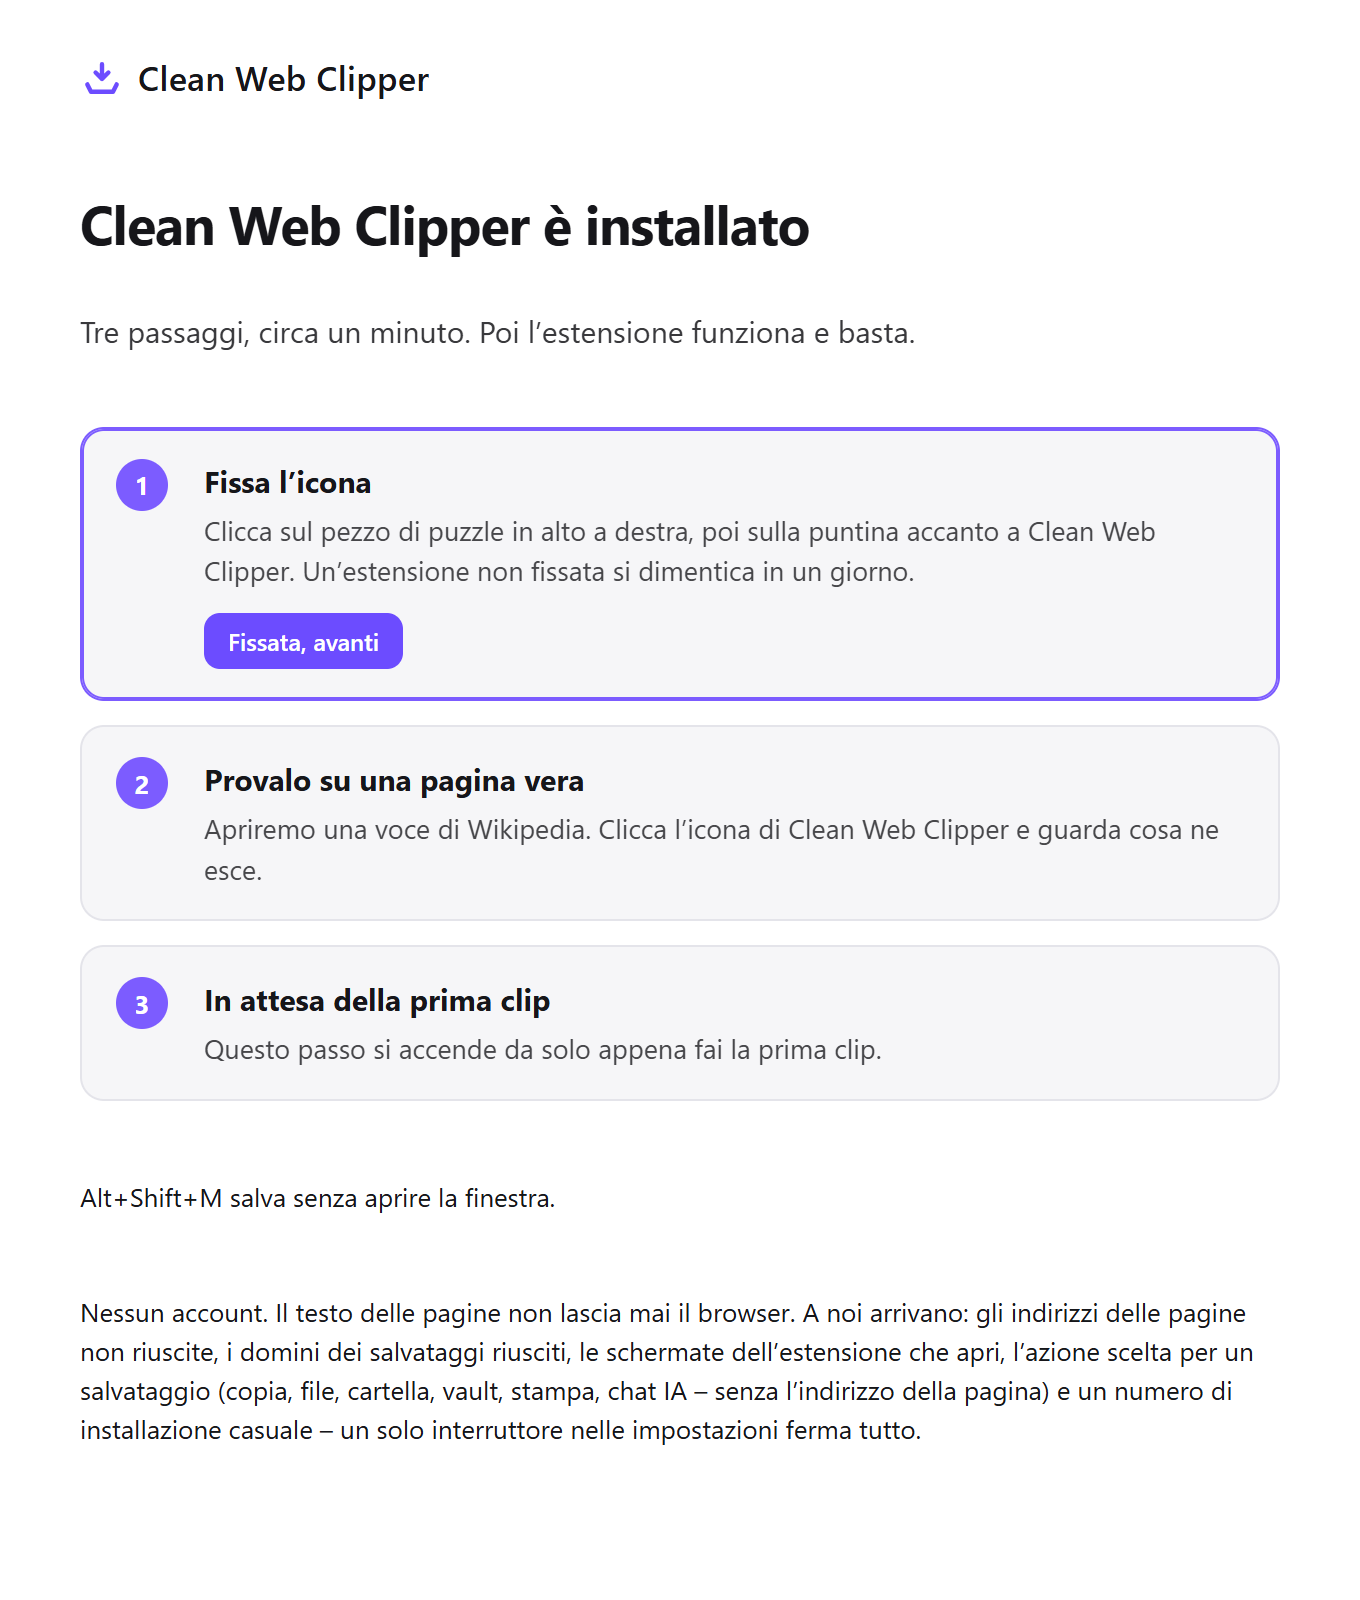
Installa l’estensione, poi tre passi. Non c’è niente da configurare prima: di base un clic apre un’anteprima con il Markdown già pronto, da copiare o salvare come file. Più avanti puoi fare in modo che un solo clic scriva la nota direttamente in una cartella o nel vault, senza anteprima.
- Fissa l’icona. Apri il menu a forma di tassello accanto alla barra degli indirizzi e fissa Clean Web Clipper nella barra degli strumenti.
- Apri l’articolo che vuoi tenere – l’articolo stesso, non una pagina di link che porta a lui.
- Clicca l’icona. Il Markdown compare nella finestra di anteprima: copialo, oppure salva il file
.md.
Dove finisce il file
- Copia il Markdown negli appunti
- Scarica il file
.md - Scrive in una cartella che scegli tu sul disco
- Scrive dritto nel vault di Obsidian – senza plugin, senza REST API locale, senza schema URI; il file semplicemente compare
Il clic sull’icona è configurabile. Puoi lasciare la finestra di anteprima, oppure fare in modo che un clic depositi la nota nel vault senza aprire niente.
Onesto sulla provenienza
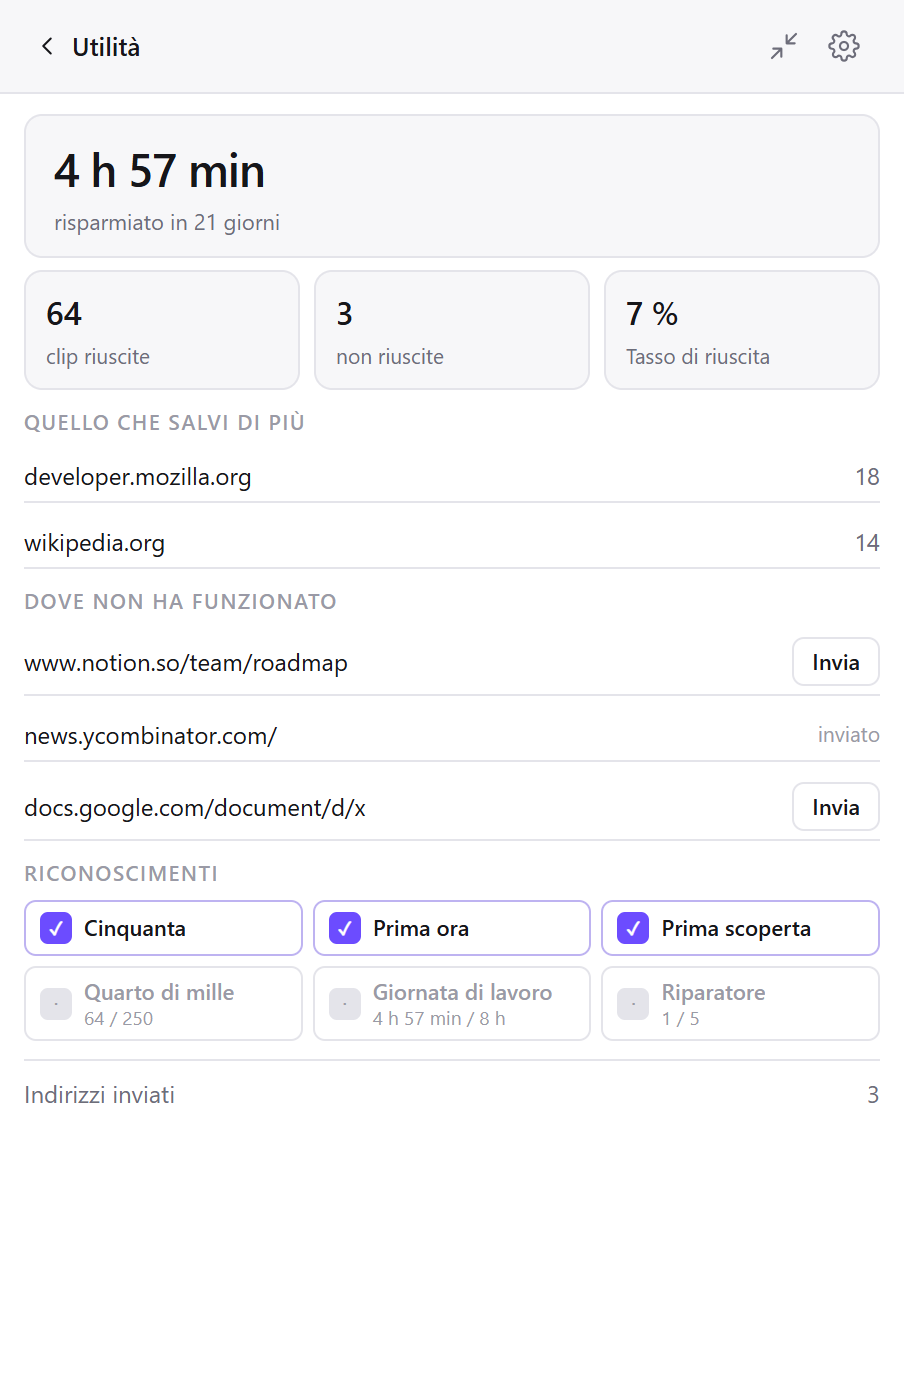
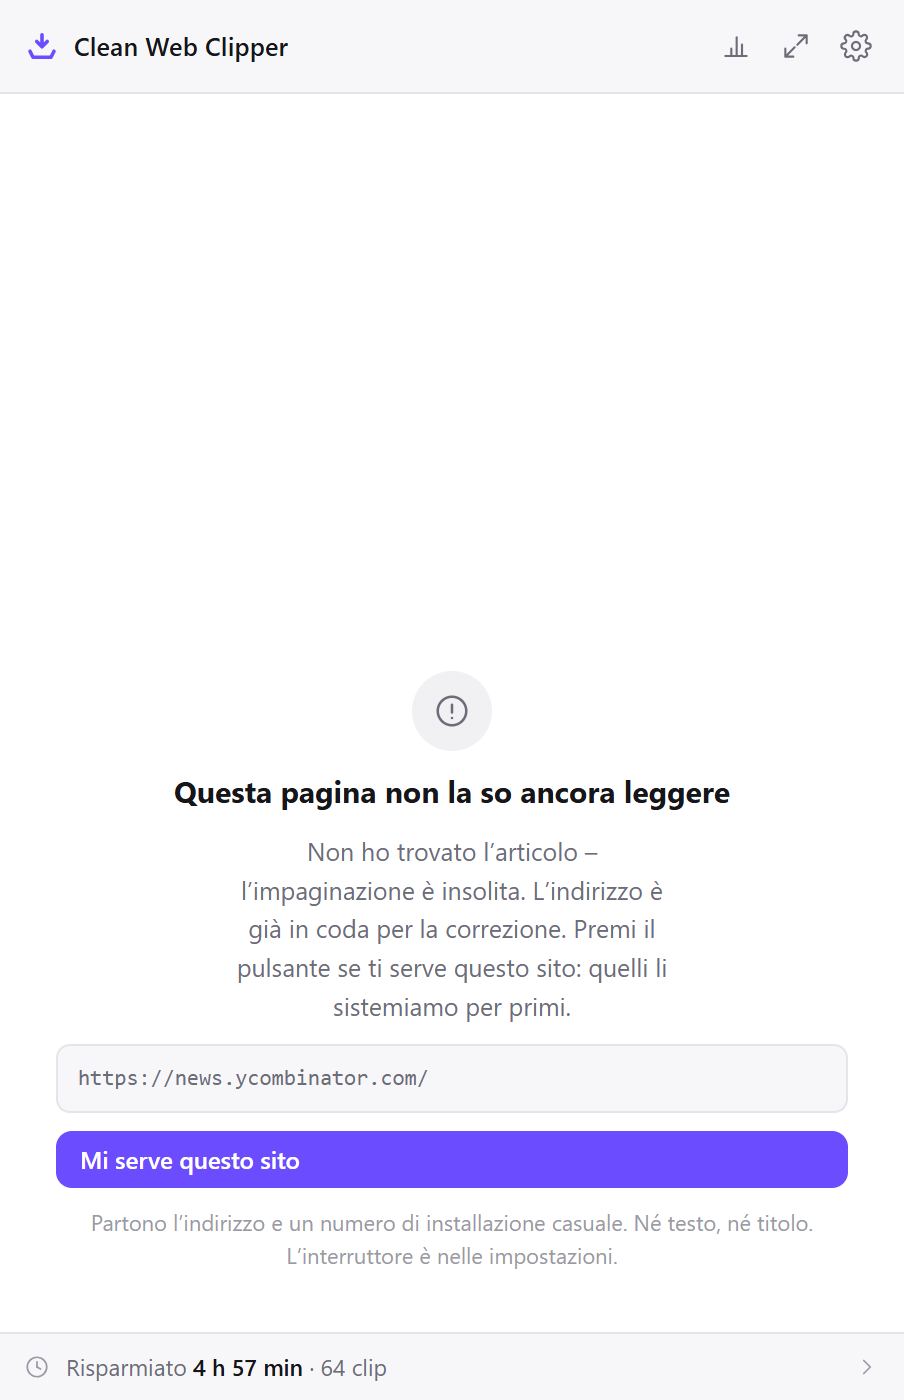
Ogni nota porta un campo extraction. dom vuol dire che il testo viene da quello che il browser ha davvero disegnato. jsonld-articlebody vuol dire che la pagina non ha finito di caricarsi e il corpo è stato letto dai suoi stessi dati strutturati. E quando sulla pagina non c’è nessun articolo – una vetrina, un feed, una pagina di risultati – l’estensione lo dice, invece di scaricarti addosso trecento link.
Che cosa non fa
- Non naviga da solo e non lavora in blocco – una pagina alla volta, quella su cui sei
- Non riassume e non riscrive – il testo viene convertito, non redatto
- Non scarica le immagini – i link alle immagini puntano al sito originale
Quindici modi di usarlo
SviluppatoriI blocchi di codice tengono la marcatura del linguaggio: l’evidenziazione funziona appena incolli.
Clean Web Clipper legge il linguaggio dalla pagina stessa – la classe del blocco, l’elemento che lo contiene, il markup lasciato dall’evidenziatore del sito – e lo scrive sulla recinzione del blocco. Su un corpus tecnico di nove pagine la marcatura è sopravvissuta in 73 blocchi su 156, contro 20 e 0 dei due motori confrontati. Il resto della pagina arriva in Markdown normale, senza la barra laterale.
- Il blocco esce come
```jse non nudo: l’evidenziazione funziona in Obsidian, VS Code e su GitHub appena incolli - Il linguaggio è letto dalla pagina – classe del blocco, elemento contenitore, markup dell’evidenziatore – mai indovinato dal codice
- Una tabella di parametri con del codice in una cella tiene le sue righe invece di schiacciarsi
Chi usa ObsidianScegli una cartella dentro il vault: un clic ci scrive la nota, e Obsidian non deve essere aperto.
L’estensione scrive il file .md da sé, dentro una cartella a cui dai accesso una volta sola. Non c’è nessun plugin della community, nessun server locale, nessun link obsidian:// da tenere in piedi. La nota è semplicemente lì la volta successiva che apri il vault.
- Nessun plugin, nessun server locale, nessun link
obsidian://da tenere in piedi - Obsidian non deve essere aperto: il file compare nella cartella e l’indice lo raccoglie dopo
- Frontmatter YAML con title, source, author, published e extraction, e i campi da tenere li scegli tu
IA e modelliLa navigazione ripetuta è contesto sprecato: viene tolta prima che il testo arrivi al modello.
Quando una pagina web finisce incollata dentro un modello, ogni riga di menu duplicata e ogni fascia viene contata come contesto e ruba attenzione al testo che ti interessa. Su un corpus di 109 pagine (prova a confronto) Clean Web Clipper ha lasciato 102 righe di navigazione ripetuta, dove gli altri tre motori ne hanno lasciate 282, 478 e 491. Il frontmatter, per giunta, consegna l’indirizzo e la data di pubblicazione.
- Quattro volte meno righe di navigazione ripetuta rispetto alla media dei motori confrontati
- Nessun tag HTML rimasto in nessun articolo estratto dalle 512 pagine provate: il modello non deve farsi strada in mezzo al markup
- Il frontmatter dà in chiaro l’indirizzo della fonte e la data di pubblicazione, invece di lasciarle indovinare
RicercaLa data si legge dai metadati, citation_date compreso: lo standard di arXiv, PubMed e IEEE.
Un articolo salvato senza la sua data di pubblicazione diventa una citazione da ricostruire più avanti. L’estensione legge la data dai metadati della pagina invece di cercarla nel testo, e lascia il campo vuoto quando la pagina non ne porta nessuna. I rimandi, dal canto loro, diventano vere note Markdown raccolte in fondo al file.
- Legge
citation_dateecitation_publication_date, i meta tag che emettono arXiv, PubMed, IRIS e IEEE - Legge anche JSON-LD
datePublished,article:published_time,time[datetime]e i marcatori Unix - Nessuna data sulla pagina vuol dire campo vuoto, mai la data di oggi
StudentiLezioni, capitoli e voci di consultazione diventano file Markdown che restano tuoi.
I materiali spariscono alla fine del semestre e i link marciscono; un file Markdown sul tuo disco no. Un salvataggio prende il testo, il suo indirizzo di partenza e la sua data, e si apre in qualsiasi editor, con o senza rete. Tutto quello che c’è in questa pagina è gratis e non chiede nessun account.
- Selezioni un passaggio e viene salvato solo quello: comodo per una definizione o per un enunciato
- Ogni nota porta il suo indirizzo di partenza, quindi citarla dopo non richiede nessuna ricerca
- I file si aprono offline, in Obsidian, Logseq, Joplin o un semplice editor di testo
AutoriOgni salvataggio tiene indirizzo, autore e data: l’attribuzione non si perde per strada.
Il materiale raccolto come schermate e segnalibri smette di servire proprio nel momento in cui va attribuito. Un file Markdown con frontmatter tiene il titolo, l’autore, la data di pubblicazione e l’indirizzo di partenza dentro il file stesso. Resta leggibile e cercabile anni dopo, senza dipendere da nessun servizio.
- Titolo, autore, data di pubblicazione e indirizzo della fonte nel frontmatter di ogni file
- L’autore è cercato nei dati strutturati e nelle firme, e i falsi positivi vengono scartati
- Il corpo dell’articolo senza navigazione e senza blocchi promozionali, pronto da citare
GiornalistiFissa la pagina come l’hai letta, con la sua data di pubblicazione e il suo indirizzo.
Le pagine vengono riscritte, corrette e tolte, spesso senza che il cambiamento venga dichiarato. Un salvataggio che porta l’indirizzo della fonte, la data di pubblicazione e il testo integrale è una traccia che puoi mostrare più avanti. Vive sul tuo disco, in Markdown, invece che dentro un servizio che può chiudere.
- Data di pubblicazione letta dai metadati della pagina, non cercata dentro il testo
- Indirizzo della fonte nel frontmatter di ogni nota, con il titolo così com’era
- Testo integrale dell’articolo, senza i blocchi di navigazione e promozione che cambiano a ogni visita
Ambito legaleIl testo come è pubblicato, con il suo indirizzo e la sua data, in un file che controlli tu.
Norme, condizioni generali e circolari cambiano senza preavviso e senza uno storico visibile. Una copia in Markdown che porta l’indirizzo da cui viene e la data che mostrava è la traccia di che cosa diceva il testo il giorno in cui l’hai letto. Niente viene riassunto né riformulato per strada.
- Testo parola per parola: l’estensione non riassume, non riscrive e non riordina
- Indirizzo della fonte e data di pubblicazione nel frontmatter, sopra il testo
- Le tabelle di aliquote, termini e soglie superano intere la conversione
AnalistiIl serializzatore di tabelle è dell’estensione: una cella con del codice non spezza più la riga.
I convertitori generici da HTML a Markdown si rompono proprio sulle tabelle che contano, quelle con un elenco, un link o un pezzo di codice dentro una cella. L’estensione scrive la tabella da sé e appiattisce il contenuto della cella invece di perdere la riga. Su un corpus di quindici tabelle ne sono passate dodici intere, contro sette per ciascun motore confrontato.
- Serializzatore di tabelle GFM proprio dell’estensione, non un plugin generico
- Dodici tabelle su quindici tenute sul corpus tecnico, contro sette per ciascun motore confrontato
- Una cella con un elenco, un link o del codice viene appiattita con ordine invece di spezzare la riga
InsegnantiSalva il materiale, tieni la fonte, stampalo o archivialo – senza il contorno del sito.
Una pagina stampata direttamente dal browser porta sulla dispensa i menu, la fascia dei cookie e la pubblicità. Un salvataggio porta il testo, e con il testo l’indirizzo della fonte, così l’attribuzione è già scritta. La stampa parte dalla finestra del salvataggio, non dalla pagina.
- Un pulsante stampa il salvataggio, non la pagina: niente menu, niente banner, niente piè di pagina
- La vista lettura mostra il risultato senza i simboli del Markdown, come lo vedrà chi legge
- L’indirizzo della fonte resta dentro la nota, quindi l’attribuzione sulla dispensa non costa fatica
TraduttoriNavigazione, banner e menu ripetuti non arrivano mai all’elenco dei segmenti.
Il testo di partenza incollato da una pagina web si porta dietro la navigazione, e ogni voce di menu diventa un segmento da saltare. Toglierla prima dell’importazione costa meno che filtrarla dopo: su un corpus di 109 pagine sono rimaste 102 righe di navigazione ripetuta, contro 282, 478 e 491 degli altri tre motori.
- Menu, paginatori e feed «leggi anche» tagliati prima dell’esportazione, non filtrati dopo
- Righe di navigazione ripetuta ridotte di circa quattro volte rispetto ai motori confrontati
- Grassetto, corsivo, link, codice ed elenchi diventano i loro equivalenti Markdown, che i CAT gestiscono come tag in linea
Product managerChangelog, documentazione e note di rilascio diventano appunti datati e cercabili.
La ricerca sui concorrenti tenuta nei segnalibri si sbriciola in un elenco di link che non si possono cercare. Salvata in Markdown diventa un corpus su cui fare grep, confronti e citazioni dentro un documento di decisione. La data di pubblicazione viene letta dalla pagina, quindi ogni voce tiene la sua collocazione nel tempo.
- Data di pubblicazione letta dalla pagina, così una voce di changelog tiene la sua collocazione nel tempo
- Le regole per sito mandano ogni concorrente nella sua cartella, con il suo frontmatter
- Le tabelle di piani, limiti e quote superano intere la conversione
Technical writerStruttura, blocchi di codice e tabelle passano; il contorno del sito no.
Migrare una documentazione di solito vuol dire convertire l’HTML e poi passare più tempo a togliere quello che il convertitore ha tenuto. Quella rimozione è la ragione per cui Clean Web Clipper esiste, ed è la parte che viene provata: nessun tag HTML rimasto negli articoli estratti dalle 512 pagine della prova, e dodici tabelle su quindici tenute intere contro sette per ciascun motore confrontato.
- Titoli, elenchi, tabelle, blocchi di codice e note diventano tutti Markdown standard
- La marcatura del linguaggio resta sui blocchi di codice: 73 blocchi su 156 sul corpus tecnico, contro 20 e 0
- Nessun tag HTML rimasto in nessun articolo estratto dalle 512 pagine provate, quindi non serve un secondo passaggio di pulizia
Archivio personaleSemplici file Markdown sul tuo disco: nessun account, nessun servizio, niente che possa chiudere.
I segnalibri puntano a pagine che cambiano o spariscono. Un salvataggio è il testo stesso, in un formato che non ha un proprietario né una scadenza, conservato dove decidi tu. Ogni nota porta l’indirizzo di partenza, la data di pubblicazione e il campo extraction, quindi resta verificabile anche fra molti anni.
- Formato aperto e duraturo: testo semplice con frontmatter YAML, leggibile da qualsiasi editor
- Nessun account: il testo delle pagine non lascia mai il browser
- Data di pubblicazione e indirizzo della fonte salvati insieme al testo, dentro il file
Leggere senza rumoreUna vista lettura che mostra il testo senza menu, senza banner e senza i simboli del Markdown.
Il contorno della pagina non è solo disordine visivo: è testo che uno screen reader deve leggere ad alta voce e che chi legge deve saltare. La finestra del salvataggio mostra l’articolo da solo, nel tema chiaro o scuro del tuo browser, e nessuno script della pagina gira lì dentro.
- La vista lettura mostra il risultato come testo normale, senza i simboli del Markdown
- Nella finestra del salvataggio non gira nessuno script della pagina, quindi niente si sposta mentre leggi
- La finestra segue l’impostazione chiara o scura del browser, senza un interruttore in più da gestire