Chrome-tillägg ·
Spara en webbsida som Markdown du slipper städa efteråt
Clean Web Clipper sparar en webbsida som Markdown med ett klick: titel, författare, publiceringsdatum och källa hamnar i frontmatter, brödtexten kommer utan navigering. Allt sker inne i din webbläsare – inget konto, och sidans text lämnar aldrig webbläsaren.
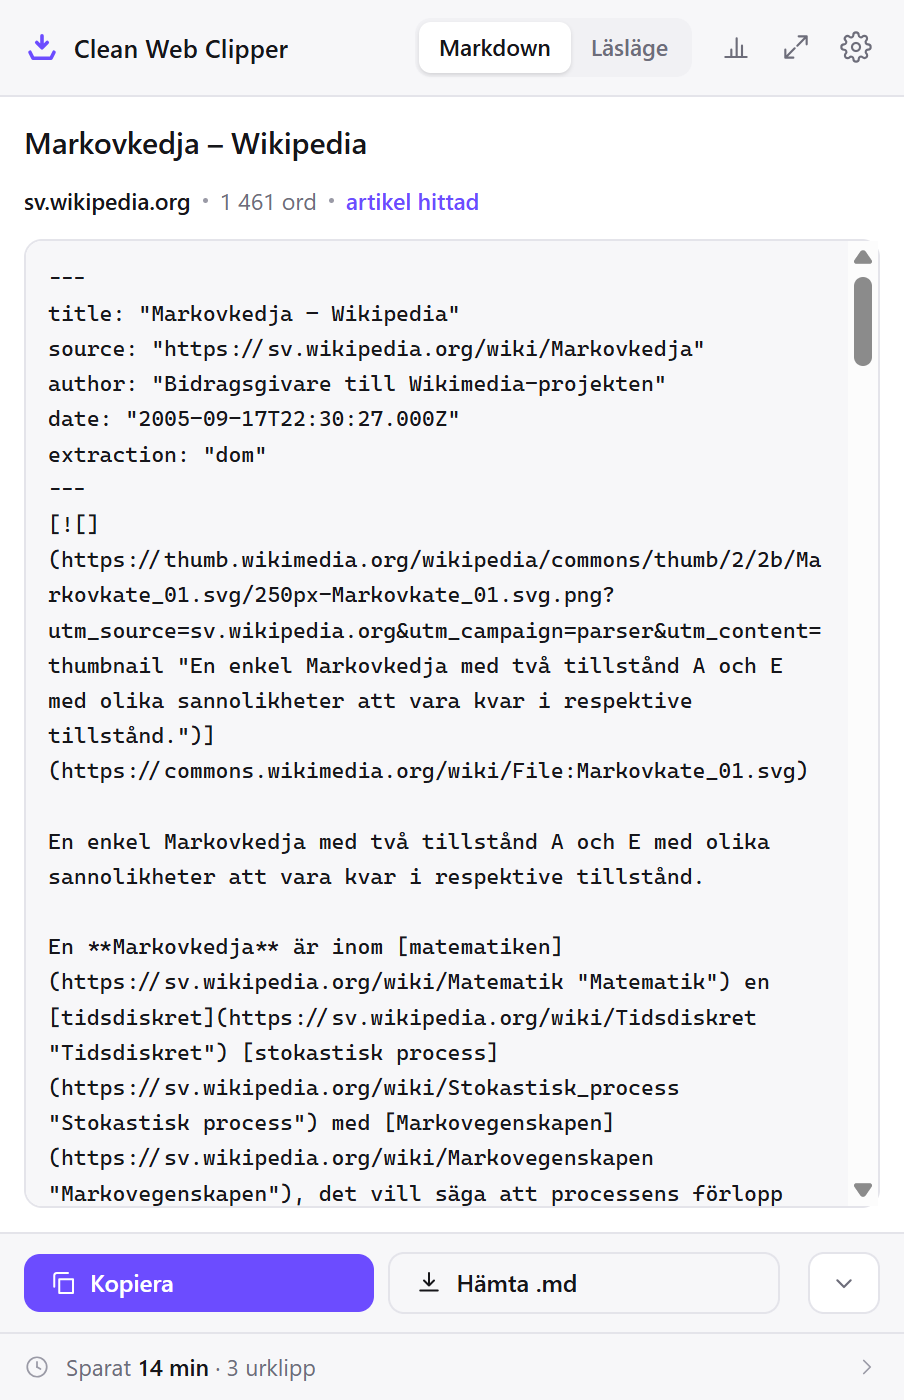
Clean Web Clipper är ett gratis Chrome-tillägg som sparar en webbsida som ren Markdown – till urklipp, en .md-fil, en mapp eller rakt in i ett Obsidian-vault – utan konto och utan inloggning. Testat på 512 sidor från de mest besökta webbplatserna: inga krascher och inga kvarlämnade HTML-taggar i någon extraherad artikel.
Testat på 512 sidor från världens mest besökta webbplatser
Två körningar. Den första tog 109 sidor från de hundra mest besökta webbplatserna i världen och i Ryssland och jämförde utdatan direkt med tre andra extraheringsmotorer. Den andra tog de femtio största webbplatserna i vart och ett av tolv europeiska länder – 403 sidor till, varje sida hämtad på landets eget språk och körd genom enbart vår kärna. Motorer, versioner, datum och var det ligger efter
Problemet är aldrig omvandlingen. Det är allt som följer med.
Alla clippers gör HTML till Markdown. Sedan öppnar du anteckningen och hittar kakbannern, sidomenyn, en ”Läs också”-lista och en tabell som föll isär på vägen in. Clean Web Clipper är byggt kring att ta bort just det, och borttagningen är mätt i stället för påstådd.
vad andra clippers behåller
[Hoppa till innehållet](#main) [Logga in](/logga-in) [Bli medlem](/prenumerera)
[Start](/) [Nyheter](/nyheter) [Sport](/sport) [Kultur](/kultur) [Mer](/mer)

Vi använder kakor och liknande tekniker för att förbättra din upplevelse.
[Godkänn alla] [Hantera inställningar]

# Artikeln du kom för att läsa

Textens faktiska första stycke.

<div class="promo-inline">

## Läs också
[En annan rubrik](/a) [Ytterligare en](/b) [Och en tredje](/c)
vad som hamnar i anteckningen
# Artikeln du kom för att läsa

Textens faktiska första stycke.
Det här gör utdatan ren
- Koden behåller sitt språk. Du får ett kodblock märkt
js, inte ett naket, så färgläggningen fungerar i samma sekund du klistrar in. - Tabeller förblir hela. En cell med kod eller en lista bryter inte längre raden.
- Fotnoter fungerar på riktigt. Referenslänkar blir
[^1]med definitionerna sist i anteckningen, inte döda ankare. - Datum läses, gissas inte. JSON-LD,
article:published_time,citation_date(standarden hos arXiv, PubMed och IEEE),time[datetime], Unix-stämplar. Saknar sidan datum blir fältet tomt – aldrig dagens datum. - Menyer, banners och ”Läs också” klipps bort. Logoradery, sidnumrering och navigering som upprepas i varje avsnitt når aldrig anteckningen.
- Inte en enda kvarlämnad tagg. Ingen
div- ellertable-uppmärkning mitt i texten.
---
title: "Markovkedja – Wikipedia"
source: "https://sv.wikipedia.org/wiki/Markovkedja"
date: "2004-11-18T09:23:07.000Z"
extraction: "dom"
---

En markovkedja är en stokastisk process där sannolikheten för varje händelse
enbart beror på det tillstånd som uppnåddes i den föregående händelsen.[^1]

[^1]: Markov, A. A. (1906). Utvidgning av de stora talens lag till storheter
      som beror av varandra.
Så sparar du en webbsida som Markdown i Chrome
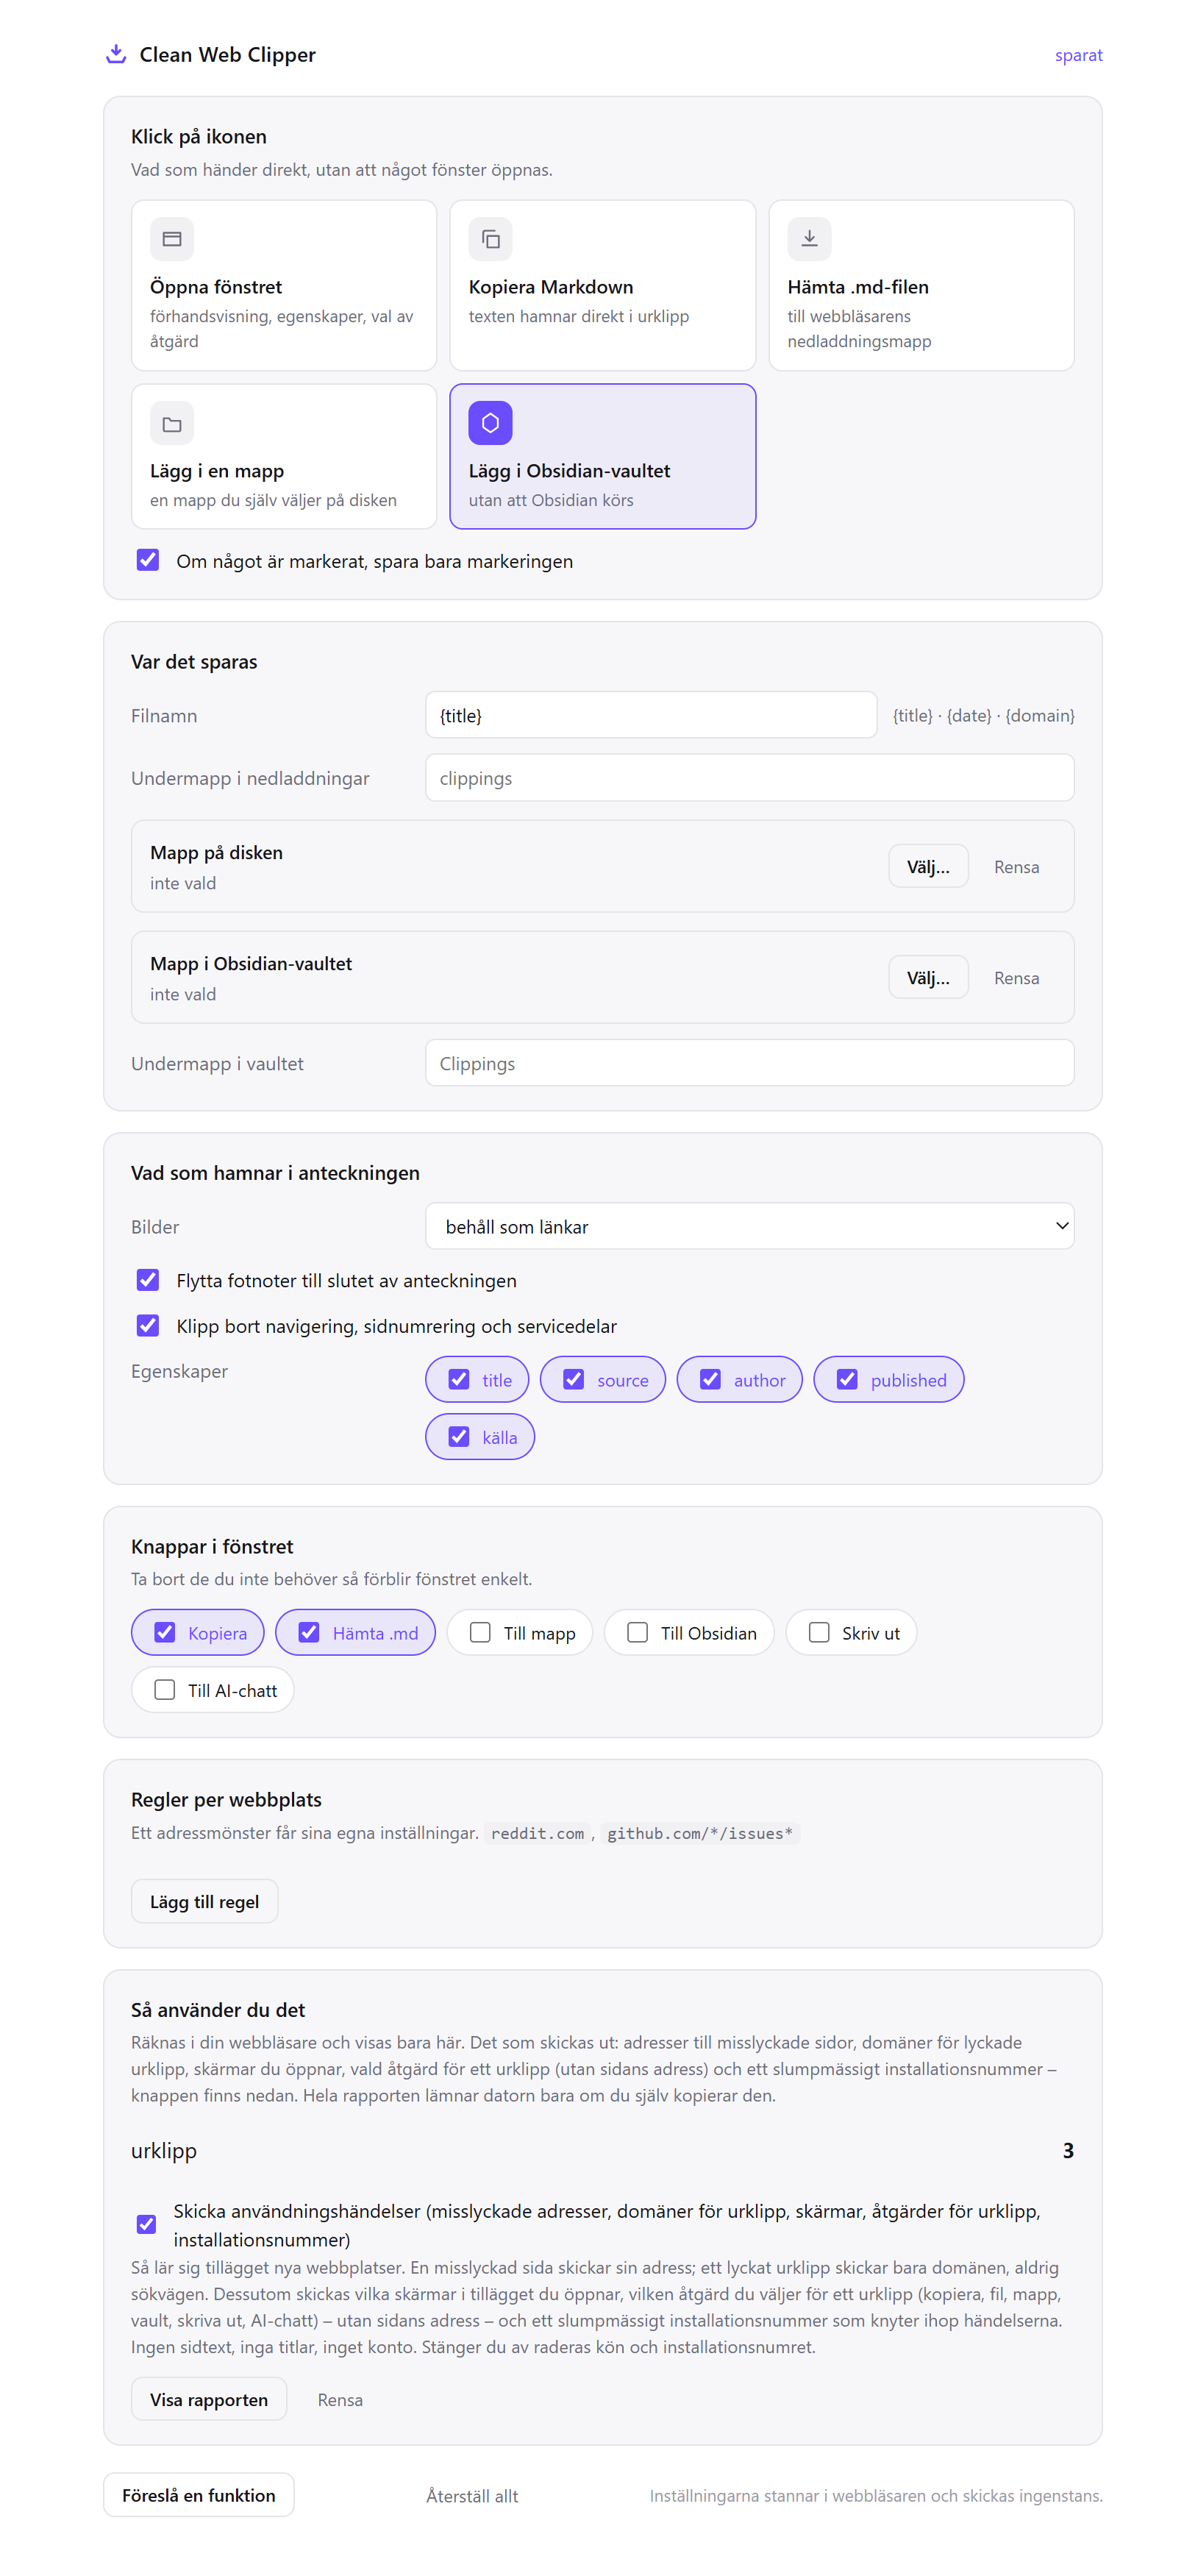
Installera tillägget, sedan tre steg. Ingenting behöver ställas in först: som standard öppnar ett klick en förhandsvisning där Markdown-texten redan är klar att kopiera eller spara som fil. Senare kan du låta ett enda klick skriva anteckningen rakt in i en mapp eller i ditt vault utan förhandsvisning.
- Fäst ikonen. Öppna pusselbitsmenyn bredvid adressfältet och fäst Clean Web Clipper i verktygsfältet.
- Öppna artikeln du vill behålla – själva artikeln, inte en sida med länkar till den.
- Klicka på ikonen. Markdown-texten visas i förhandsvisningen: kopiera den eller spara
.md-filen.
Var det sparas
- Kopiera Markdown till urklipp
- Hämta
.md-filen - Skriv till en mapp du själv valt på disken
- Skriv rakt in i ditt Obsidian-vault – ingen plugin, inget lokalt REST API, inget URI-schema; filen finns helt enkelt där
Vad klicket på ikonen gör bestämmer du. Behåll förhandsvisningen, eller låt ett klick lägga anteckningen i vaultet utan att öppna någonting alls.
Ärligt om källan
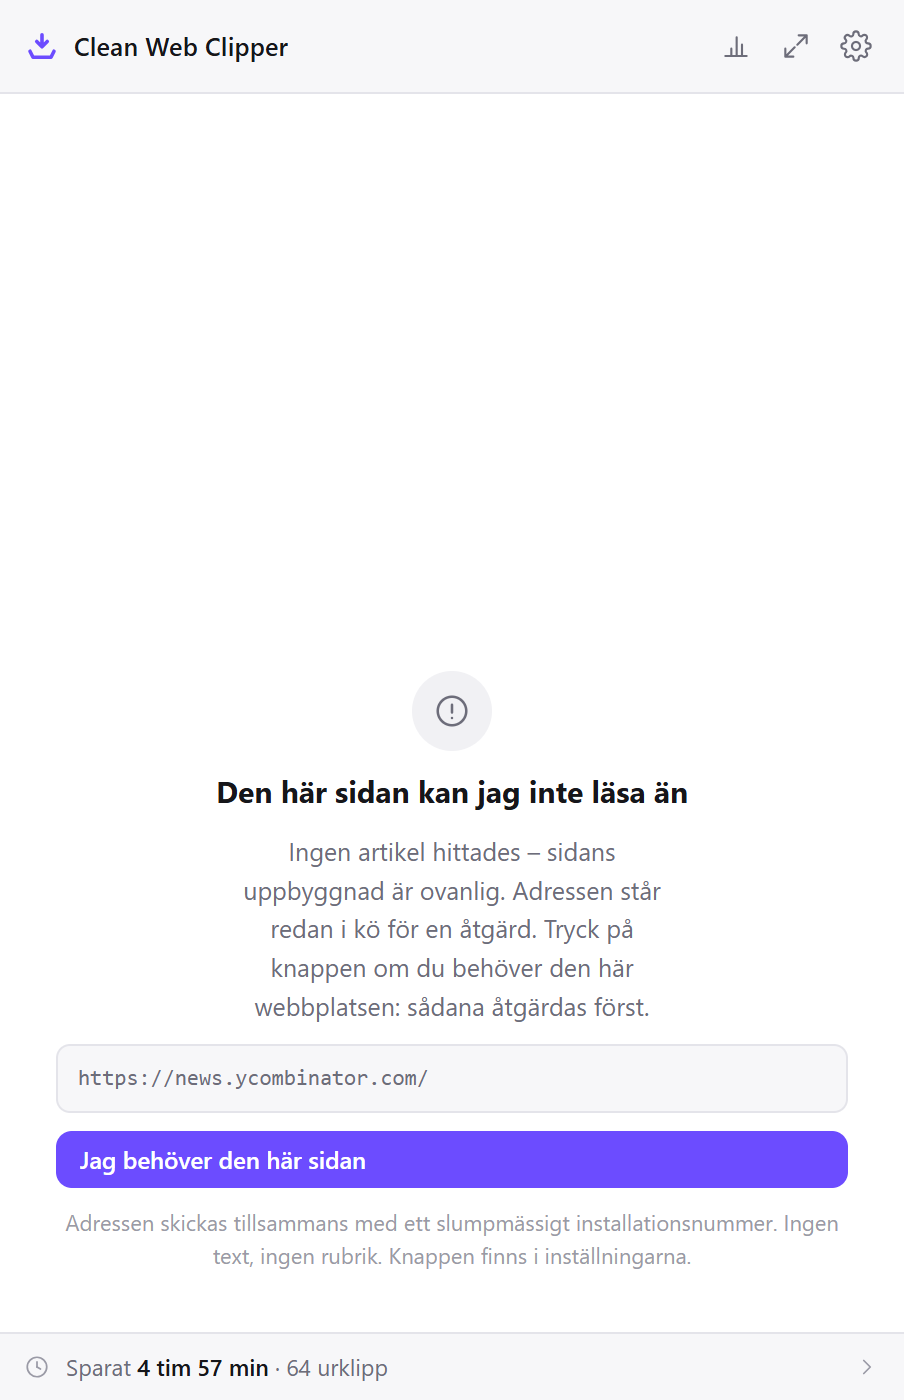
Varje anteckning märks med ett extraction-fält. dom betyder att texten kom från det webbläsaren faktiskt renderade. jsonld-articlebody betyder att sidan aldrig renderade färdigt och att brödtexten fick läsas ur sidans egna strukturerade data. Och när det inte finns någon artikel alls på sidan – en butik, ett flöde, ett sökresultat – säger tillägget det i stället för att kasta trehundra länkar på dig.
Vad det inte gör
- Det kryper inte och kör inga satser – en sida i taget, den sida du står på
- Det sammanfattar och skriver inte om – texten omvandlas, den redigeras inte
- Det hämtar inte bilder – bildlänkarna pekar på originalsajten
Femton sätt att använda det
UtvecklareKodblock behåller sin språkmärkning, så inklistrad dokumentation färgläggs direkt.
Clean Web Clipper läser kodblockets språk ur sidan själv – ur klassen på blocket, ur föräldraelementet eller ur färgläggarens egen uppmärkning – och skriver in det i Markdown-texten. På ett tekniskt korpus överlevde märkningen i 73 av 156 kodblock, mot 20 och 0 för de två jämförda motorerna.
- Ett block kommer ut som
```jsoch inte naket – färgläggningen fungerar i Obsidian, VS Code och på GitHub i samma sekund du klistrar in - Märkningen kommer från sidan själv: klassen färgläggaren lämnat efter sig, inte en gissning utifrån koden
- Tabeller med ett kodexempel i en cell klappar inte ihop till en enda rad
Obsidian-användarePeka ut en mapp i vaultet en gång, så hamnar varje sparad sida där som .md-fil.
Tillägget skriver anteckningen själv, till den mapp du pekar ut, via webbläsarens File System Access API. Ingen community-plugin är inblandad, inget lokalt REST API och ingen obsidian://-länk, och Obsidian behöver inte vara igång: filen ligger där nästa gång du öppnar vaultet.
- Ingen plugin, ingen lokal server, inga
obsidian://-länkar – tillägget skriver filen själv - Obsidian behöver inte vara öppet; filen finns där nästa gång du öppnar vaultet
- YAML-frontmatter med title, source, author, published och extraction, och du väljer vilka fält som stannar
AI och språkmodellerUpprepad navigering är bortkastad kontext. Den försvinner innan texten når modellen.
En webbsida du klistrar in i en modell består till en dryg del av navigering, och varje dubblerad menyrad räknas som kontext. På ett korpus om 109 sidor (den direkta jämförelsen) lämnade Clean Web Clipper 102 dubblerade navigeringsrader, där tre andra motorer lämnade 282, 478 och 491. Kvar blir texten, med källadressen och datumet i frontmatter.
- Ungefär fyra gånger mindre dubblerad navigering än genomsnittet för de jämförda motorerna
- Inga kvarlämnade HTML-taggar i någon extraherad artikel, över 512 testade sidor – ingen uppmärkning att läsa sig förbi
- Frontmatter ger modellen källadressen och publiceringsdatumet uttryckligen
ForskareLäser citation_date, standarden hos arXiv, PubMed och IEEE, och lägger fotnoterna sist.
Datumet kommer ur sidans metadata och inte ur en gissning på texten: citation_date, JSON-LD datePublished, article:published_time, time[datetime] och Unix-stämplar läses i den ordningen. Bär sidan inget datum lämnas fältet tomt. Referenslänkar blir [^1]-fotnoter med sina definitioner sist i anteckningen.
- Läser
citation_dateochcitation_publication_date– metataggarna som arXiv, PubMed och IEEE skickar med - Dessutom JSON-LD
datePublished,article:published_time,time[datetime]och Unix-stämplar - Inget datum på sidan betyder ett tomt fält, aldrig dagens datum
StudenterFöreläsningar, kapitel och uppslagssidor blir vanliga Markdown-filer på din egen disk.
Kursmaterial försvinner när terminen är slut: lärplattformen stängs, länken ruttnar och pdf-filen ligger bakom en inloggning du inte längre har. En sparad sida är ren text med källan kvar, och den öppnas i vilken redigerare som helst om tio år. Markerar du något på sidan sparas bara markeringen.
- Markera ett stycke så sparas bara markeringen – praktiskt när du vill citera en definition
- Varje anteckning bär källadressen, så det kostar ingen sökning att hänvisa till den senare
- Publiceringsdatumet läses där sidan bär ett, och lämnas annars tomt
SkribenterVarje sparad sida behåller källadress, författare och publiceringsdatum, så att ett citat behåller sitt ursprung.
Det du sparar som skärmbild eller bokmärke är oanvändbart just i det ögonblick du ska ange källan. En Markdown-fil håller rubriken, författaren, datumet och adressen i samma fil som texten, där en faktagranskning kan nå dem.
title,author,dateochsourcei frontmatter i varje anteckning, så att källangivelsen följer texten.- Författarfältet filtreras: avsnittsrubriker, tidningsnamn och knapptexter tas inte för bylines.
- Bara artikeltexten: nyhetsbrevsrutor, delningsrader och ”Läs också”-listor når aldrig anteckningen.
JournalisterTexten som du läste den, med publiceringsdatum och adress, i en fil på din egen disk.
Sidor skrivs om och plockas ned. Ett klipp rymmer hela texten, källadressen och publiceringsdatumet som sidan själv angav, i en vanlig fil du behåller – inte i en tjänst som kan läggas ned, ändra sina villkor eller i tysthet tappa underlaget.
- Publiceringsdatumet läses ur sidans egna metadata – JSON-LD,
article:published_time,time[datetime]– inte ur brödtexten. - Källadressen ligger i frontmatter i varje anteckning.
- Hela artikeltexten utan navigering och puffar som byts ut mellan besöken.
Juridiskt arbeteTexten som den är publicerad, med källadress och datum, i en fil du själv råder över.
Föreskrifter, användarvillkor och officiell vägledning ändras utan förvarning. En Markdown-kopia med adressen den kom från och datumet sidan angav visar vad texten sa den dag du läste den.
- Ordagrann text – ingenting i artikeltexten sammanfattas, skrivs om eller kastas om.
- Källadress och sidans angivna publiceringsdatum i frontmatter i varje anteckning.
- Tabeller över avgifter, tidsfrister och beloppsgränser serialiseras av tillägget självt: 12 av 15 behölls på det tekniska korpuset, mot 7 för var och en av de jämförda motorerna.
AnalytikerEn cell med kod, en lista eller en länk bryter inte längre raden: 12 av 15 tabeller behållna.
Generiska omvandlare från HTML till Markdown går sönder på de tabeller som betyder något: de med en lista, en länk eller ett kodexempel inne i en cell. Clean Web Clipper serialiserar tabellen själv och plattar ut cellinnehållet i stället för att tappa raden.
- En GFM-tabellserialisering skriven för just det här, inte en generisk omvandlarplugin som skruvats fast.
- 12 tabeller av 15 behållna på det tekniska korpuset, mot 7 för var och en av de jämförda motorerna.
- Ojämna tvåkolumnstabeller blir rader med fetstilt nyckel och värde i stället för ett trasigt rutnät.
LärareMaterialet utan sajten runt omkring: inga menyer, ingen samtyckesruta, ingen reklam på det utskrivna bladet.
En sida som skrivs ut direkt ur webbläsaren tar med sig menyer, samtyckesruta och reklam till elevunderlaget. Ett klipp tar med texten, med källadressen kvar i filen, så att källhänvisningen inte kostar något extra arbete.
- En utskriftsknapp som skriver ut klippet, inte sidan runt omkring.
- Läsläget visar resultatet som vanlig text, utan Markdown-tecken, innan du skriver ut eller sparar.
- Markera en övning eller en definition och klipp bara den.
ÖversättareNavigering, banners och upprepade menyer når aldrig segmentlistan.
Källtext som klistras in från en webbsida bär med sig navigeringen, och varje menypost blir ett segment du måste hoppa över. Clean Web Clipper klipper bort det före exporten: på ett korpus om 109 sidor återstod 102 dubblerade navigeringsrader, mot 282, 478 och 491 hos de tre andra motorerna. Det du importerar är brödtext.
- Menyer, sidnumrering, kakbanners och ”Läs också”-block klipps bort före exporten
- Dubblerade navigeringsrader ungefär fyra gånger färre än hos de jämförda motorerna
- Vanlig Markdown importeras i alla större CAT-verktyg
ProduktcheferÄndringsloggar, dokumentation och release notes som daterade, sökbara anteckningar.
Omvärldsbevakning som samlas som bokmärken förfaller till en lista länkar du inte kan söka i. Sparad som Markdown blir den ett korpus du kan söka i, jämföra och citera i ett beslutsunderlag – med sidans eget publiceringsdatum, så att en post i en ändringslogg behåller sin verkliga tidpunkt.
- Publiceringsdatumet läses ur sidan, så en post i en ändringslogg behåller sin verkliga tidpunkt
- Med regler per webbplats hamnar varje konkurrent i sin egen mapp av sig själv
- Tabeller över planer, gränser och funktionsjämförelser överlever hela
TeknikinformatörerStruktur, kodblock och tabeller följer med; webbplatsens inredning gör det inte.
Att migrera dokumentation brukar innebära att man omvandlar HTML och sedan lägger längre tid på att ta bort det omvandlaren behöll. Borttagningen är det Clean Web Clipper är byggt kring, och den är också den del som är testad: inga kvarlämnade HTML-taggar i någon extraherad artikel, över 512 testade sidor, och språkmärkningar som sitter kvar på kodblocken.
- Rubriker, listor, tabeller, kodblock och fotnoter blir alla vanlig Markdown
- Språkmärkningen sitter kvar på kodblocken – 73 av 156 på det tekniska korpuset, mot 20 och 0
- Inga kvarlämnade HTML-taggar i någon extraherad artikel, över 512 testade sidor
Personligt arkivVanliga Markdown-filer på din egen disk. Inget konto, ingen tjänst som kan läggas ned.
Bokmärken pekar på sidor som ändras eller försvinner. En sparad kopia är själva texten, i ren text med YAML-frontmatter, lagrad där du bestämmer. Sidans text lämnar aldrig webbläsaren och sparandet hänger inte på någon tjänst, så det finns inget konto som kan gå ut och ingen tjänst som kan dra in din åtkomst.
- Beständigt öppet format: ren text med YAML-frontmatter, läsbar i vilken redigerare som helst
- Inget konto – sidans text lämnar aldrig webbläsaren
- Publiceringsdatum och källadress fångas tillsammans med texten
Läsa utan brusEtt läsläge som visar texten utan menyer, utan banners och utan Markdown-tecken.
Sidinredning är inte bara visuellt stök: det är text som en skärmläsare läser upp och en läsare måste hoppa över. Fönstret visar artikeln för sig själv, i webbläsarens ljusa eller mörka tema, och inga skript från sidan kör med. Det du sparar är ren text som vilket hjälpmedel som helst klarar.
- Visar den sparade texten som vanlig text, utan Markdown-tecken, med rubriker, tabeller och fungerande länkar
- Följer webbläsarens inställning för ljust och mörkt
- Förstoras till ett fönster på tre fjärdedelar av skärmen, så att sidan bakom syns kvar