Rozszerzenie do Chrome ·
Zapisz stronę jako Markdown, którego nie trzeba sprzątać
Kliknij ikonę i klip już jest – Clean Web Clipper zapisuje stronę jako Markdown razem z tytułem, autorem, datą publikacji i adresem źródła we frontmatterze, a treść zostaje bez nawigacji. Wszystko dzieje się w Twojej przeglądarce: bez konta, a tekst strony nigdy jej nie opuszcza.
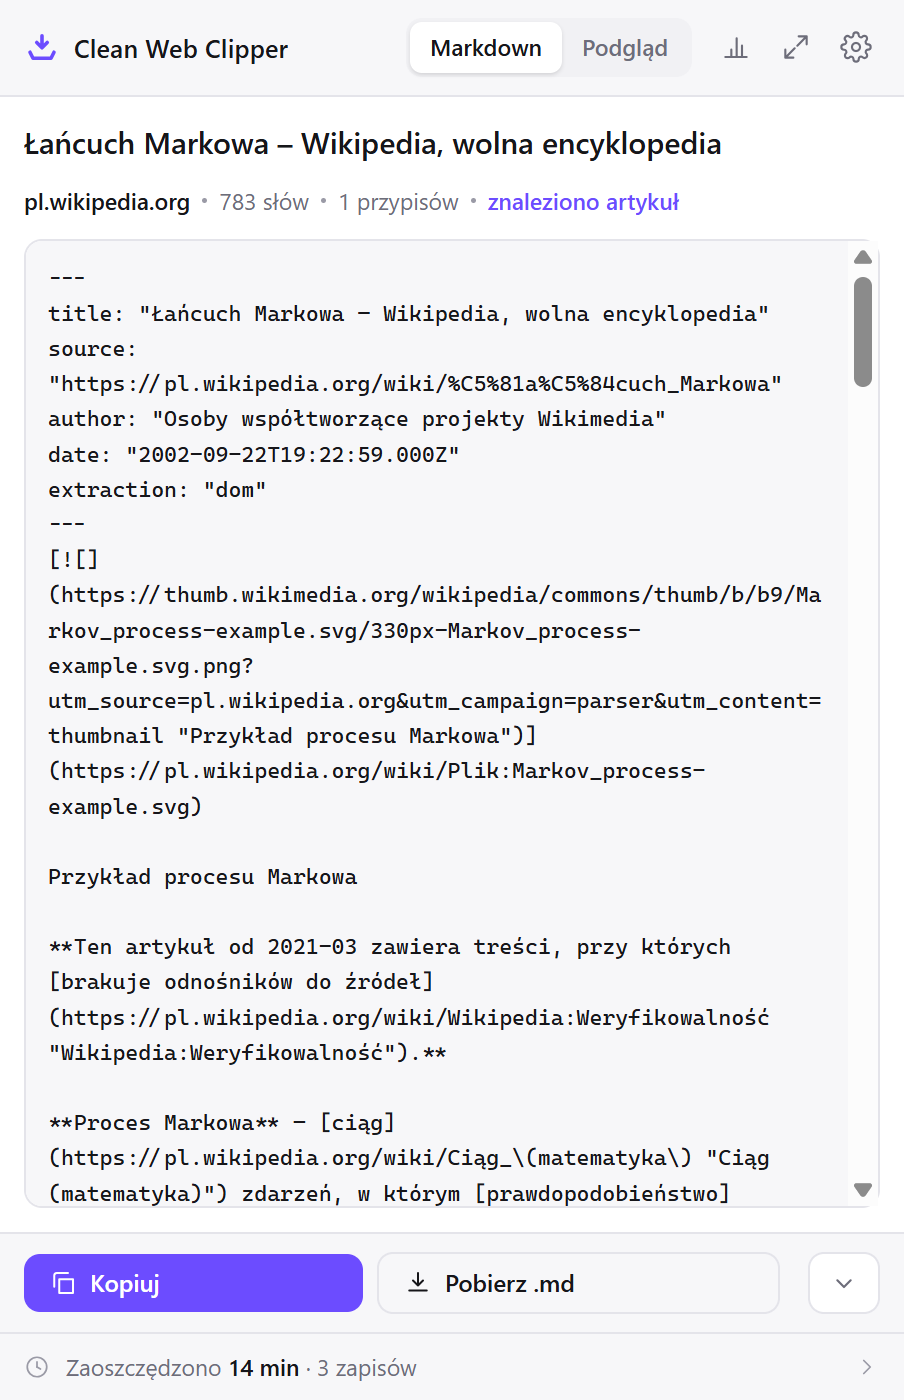
Clean Web Clipper to darmowe rozszerzenie do Chrome, które zapisuje stronę internetową jako czysty Markdown – do schowka, pliku .md, folderu albo prosto do vaultu Obsidian – bez konta i bez logowania. Przetestowane na 512 stronach najczęściej odwiedzanych serwisów: zero awarii i ani jednego resztkowego znacznika HTML w żadnym wyciągniętym artykule.
Przetestowane na 512 stronach najczęściej odwiedzanych serwisów
Dwa przebiegi. Pierwszy wziął 109 stron ze stu najczęściej odwiedzanych serwisów świata i Rosji i porównał wynik bezpośrednio z trzema innymi silnikami ekstrakcji. Drugi wziął po pięćdziesiąt najpopularniejszych serwisów w każdym z dwunastu krajów Europy – kolejne 403 strony, każda zebrana w języku danego kraju i przepuszczona tylko przez nasz rdzeń. Silniki, wersje, daty i to, w czym wypadamy gorzej
Problemem nigdy nie jest konwersja. Problemem jest to, co przychodzi razem z nią.
Każdy clipper zamienia HTML na Markdown. Potem otwierasz notatkę i znajdujesz w niej pasek o ciasteczkach, boczne menu, listę „Czytaj także” i tabelę, która rozsypała się po drodze. Clean Web Clipper jest zbudowany dokładnie wokół usuwania tego, a usuwanie zostało zmierzone, a nie zadeklarowane.
co zostawiają inne clippery
[Przejdź do treści](#main) [Zaloguj się](/login) [Załóż konto](/rejestracja)
[Start](/) [Wiadomości](/wiadomosci) [Sport](/sport) [Kultura](/kultura) [Więcej](/wiecej)

Używamy plików cookie i podobnych technologii, aby ulepszać nasze usługi.
[Akceptuj wszystkie] [Ustawienia]

# Artykuł, po który przyszedłeś

Właściwy pierwszy akapit tekstu.

<div class="promo-inline">

## Czytaj także
[Inny nagłówek](/a) [Jeszcze jeden](/b) [I trzeci](/c)
co ląduje w notatce
# Artykuł, po który przyszedłeś

Właściwy pierwszy akapit tekstu.
Co sprawia, że wynik jest czysty
- Kod zachowuje język. Blok wychodzi z etykietą
js, a nie goły, więc kolorowanie składni działa od razu po wklejeniu. - Tabele zostają całe. Komórka z kodem albo listą nie rozrywa już wiersza.
- Przypisy naprawdę działają. Odnośniki do bibliografii stają się
[^1]z definicjami na końcu notatki, a nie martwymi kotwicami. - Data jest odczytana, a nie zgadnięta. JSON-LD,
article:published_time,citation_date(standard arXiv, PubMed i IEEE),time[datetime], znaczniki uniksowe. Brak daty na stronie oznacza puste pole, nigdy dzisiejszą datę. - Menu, banery i „Czytaj także” lecą precz. Paski logotypów, paginacja i nawigacja powtórzona w każdej sekcji nigdy nie docierają do notatki.
- Ani jednego resztkowego znacznika. Żadnego
divczytablew środku tekstu.
---
title: "Łańcuch Markowa – Wikipedia"
source: "https://pl.wikipedia.org/wiki/Łańcuch_Markowa"
date: "2004-03-19T18:22:07.000Z"
extraction: "dom"
---

Łańcuch Markowa to ciąg zdarzeń losowych, w którym prawdopodobieństwo
każdego zdarzenia zależy wyłącznie od stanu osiągniętego w zdarzeniu
poprzednim.[^1]

[^1]: Plucińska, A.; Pluciński, E. (2000). Probabilistyka. Warszawa:
      Wydawnictwa Naukowo-Techniczne, s. 289–312.
Jak zapisać stronę internetową jako Markdown w Chrome
Zainstaluj rozszerzenie, a potem trzy kroki. Najpierw niczego nie trzeba ustawiać: domyślnie kliknięcie otwiera podgląd z gotowym Markdownem, który możesz skopiować albo zapisać jako plik. Później możesz sprawić, że jedno kliknięcie zapisze notatkę prosto do folderu albo vaultu i pominie podgląd.
- Przypnij ikonę. Otwórz menu z puzzlem obok paska adresu i przypnij Clean Web Clipper do paska narzędzi.
- Otwórz artykuł, który chcesz zachować – sam artykuł, a nie stronę z odnośnikami do niego.
- Kliknij ikonę. Markdown pojawi się w oknie podglądu: skopiuj go albo zapisz plik
.md.
Gdzie zapisuje
- Skopiować Markdown do schowka
- Pobrać plik
.md - Zapisać do wybranego przez Ciebie folderu na dysku
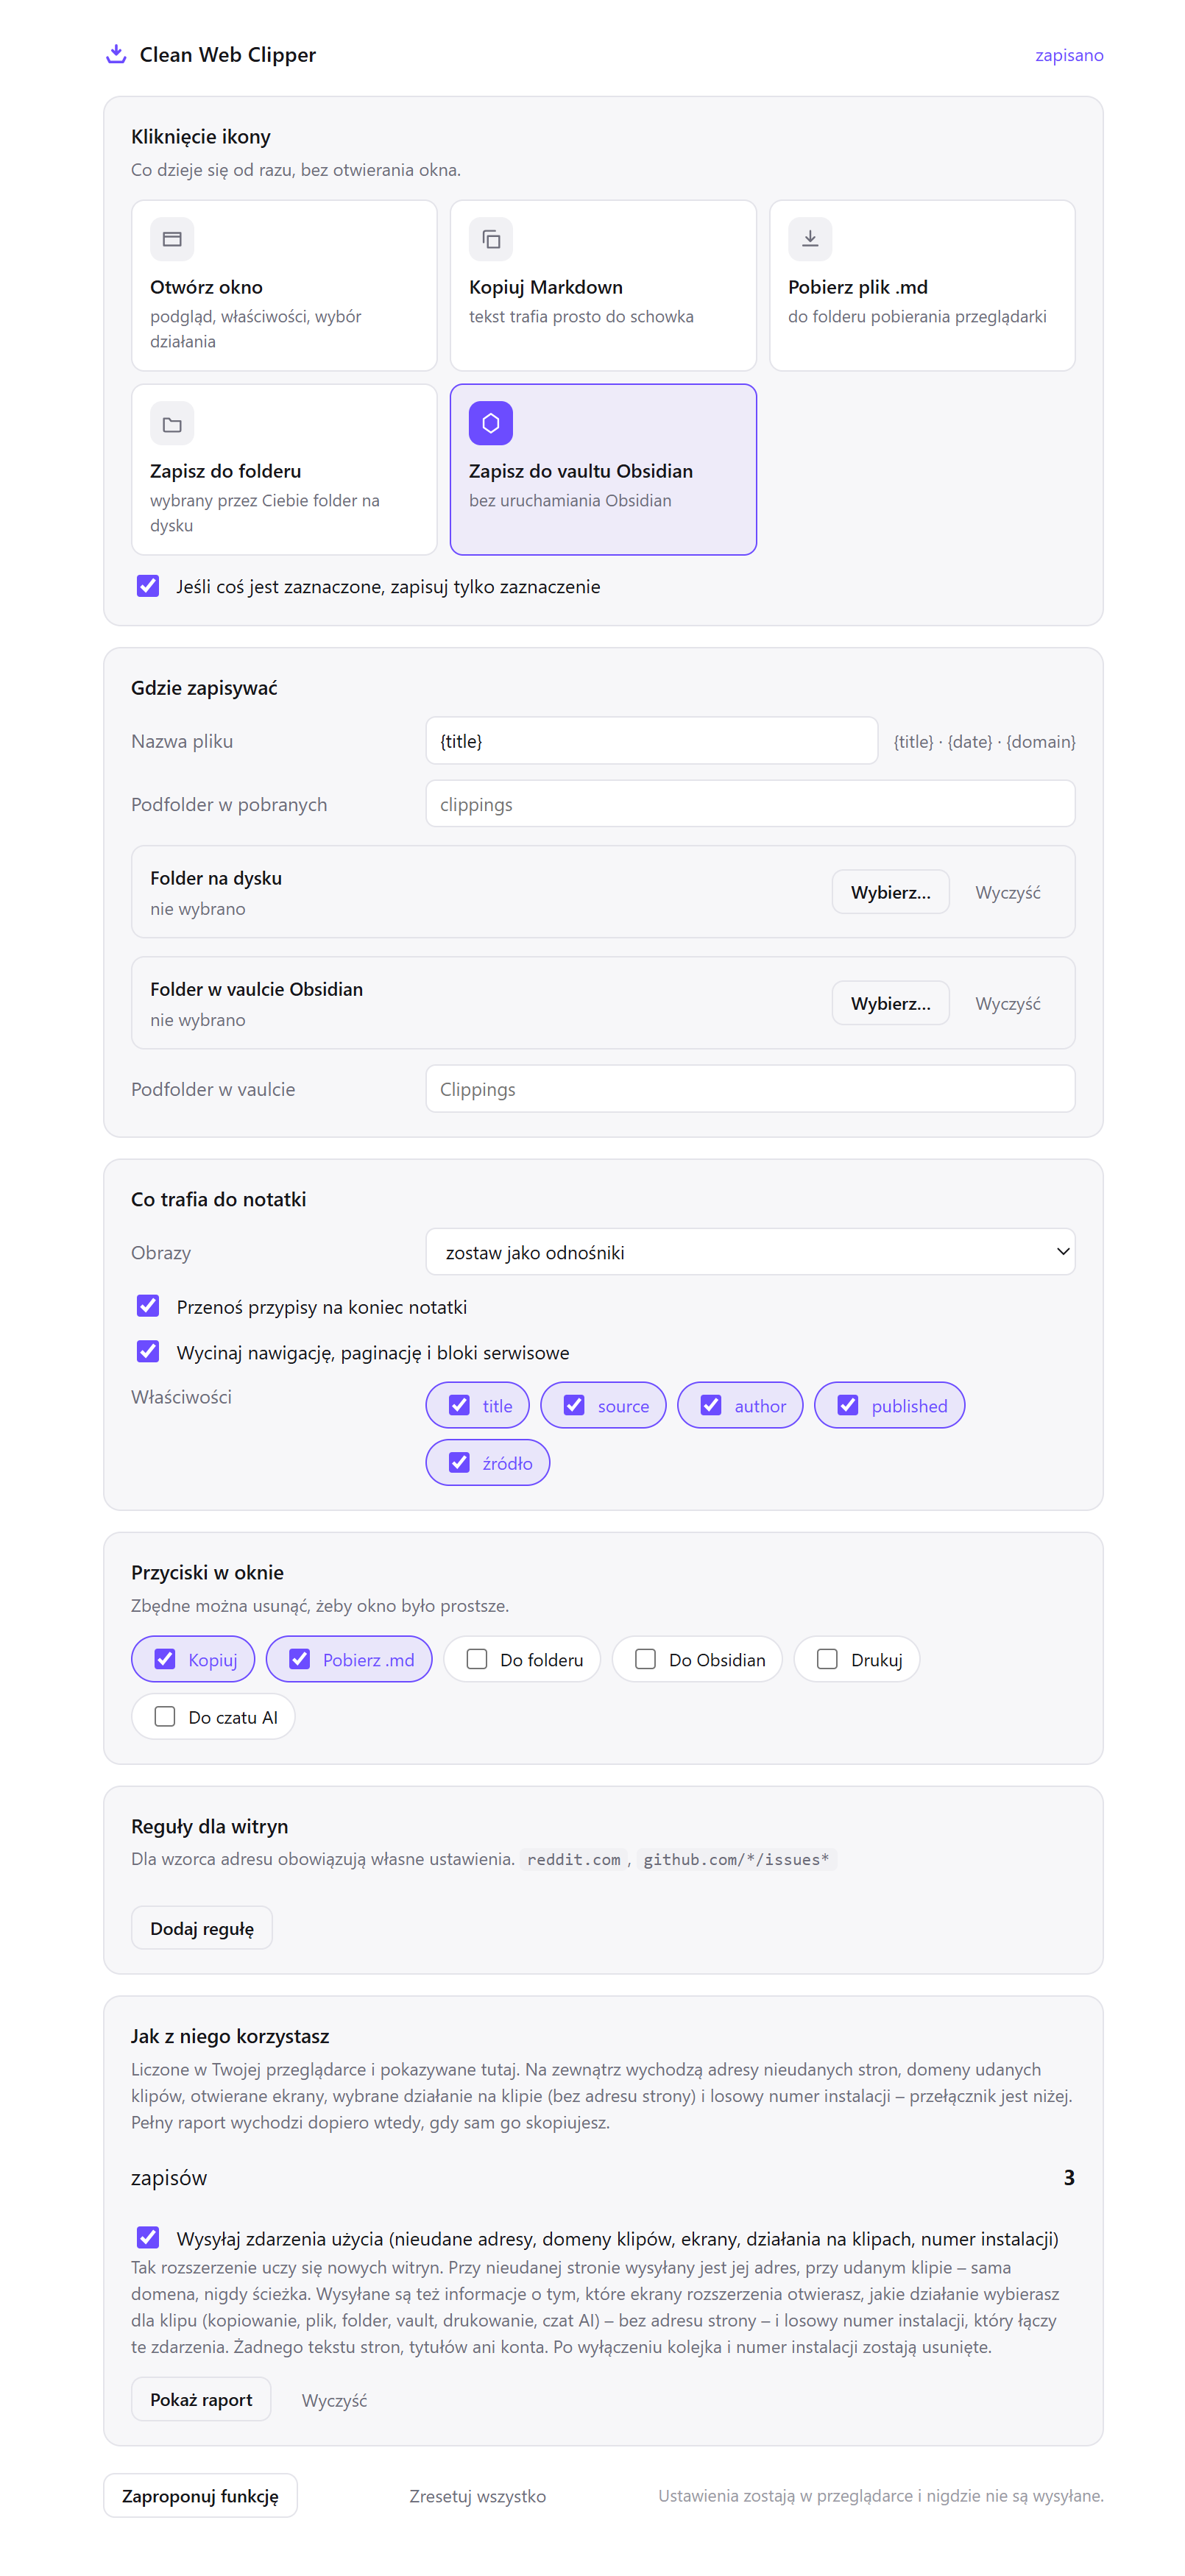
- Zapisać prosto do vaultu Obsidian – bez wtyczki, bez lokalnego REST API, bez schematu URI; plik po prostu się pojawia
Reakcję na kliknięcie ikony ustawiasz sam. Możesz zostawić okno podglądu albo sprawić, żeby jedno kliknięcie odkładało notatkę do vaultu i nie otwierało zupełnie nic.
Uczciwie o źródle
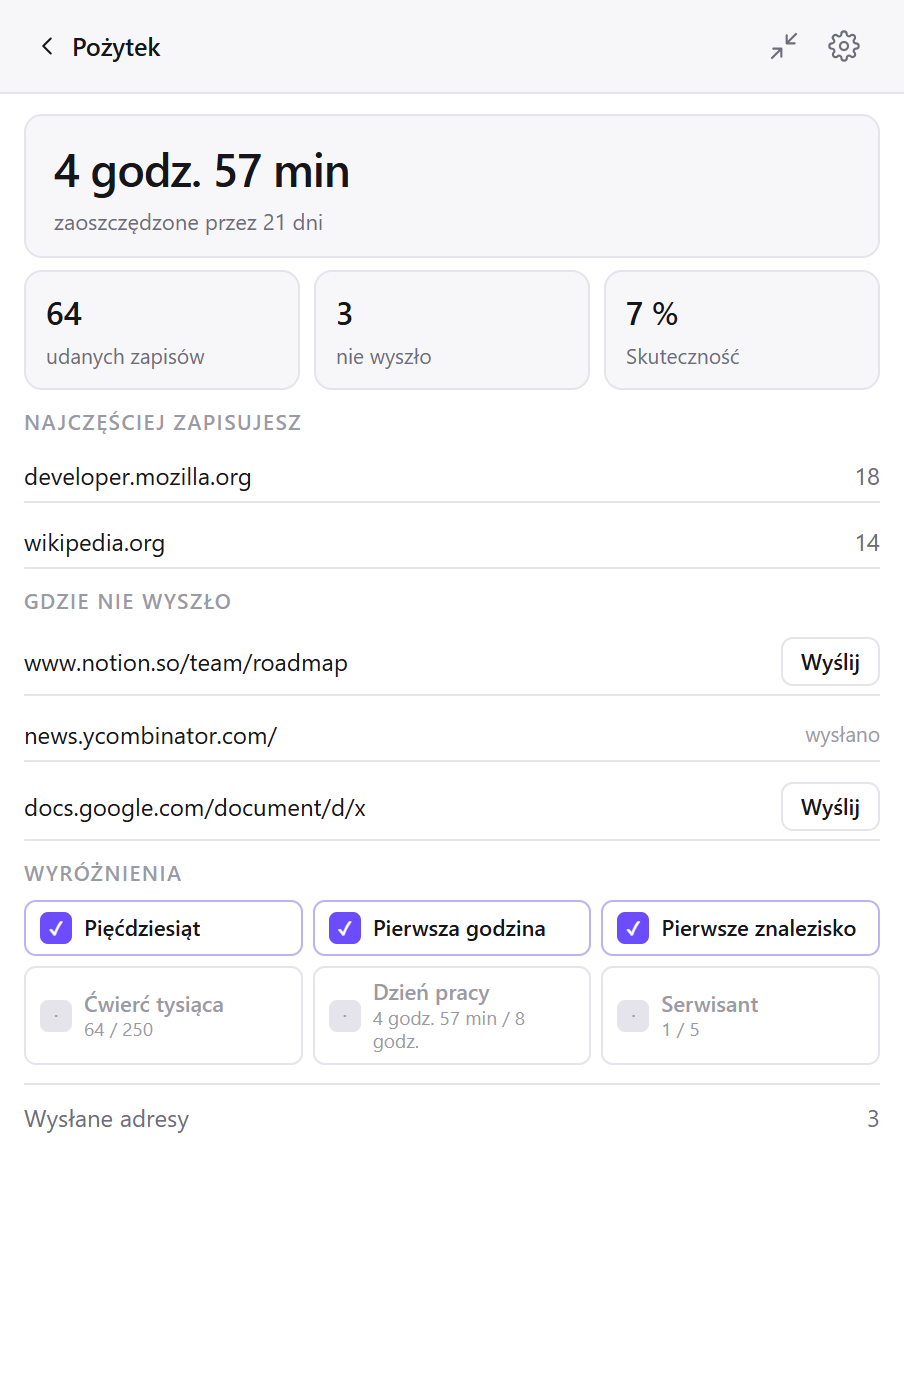
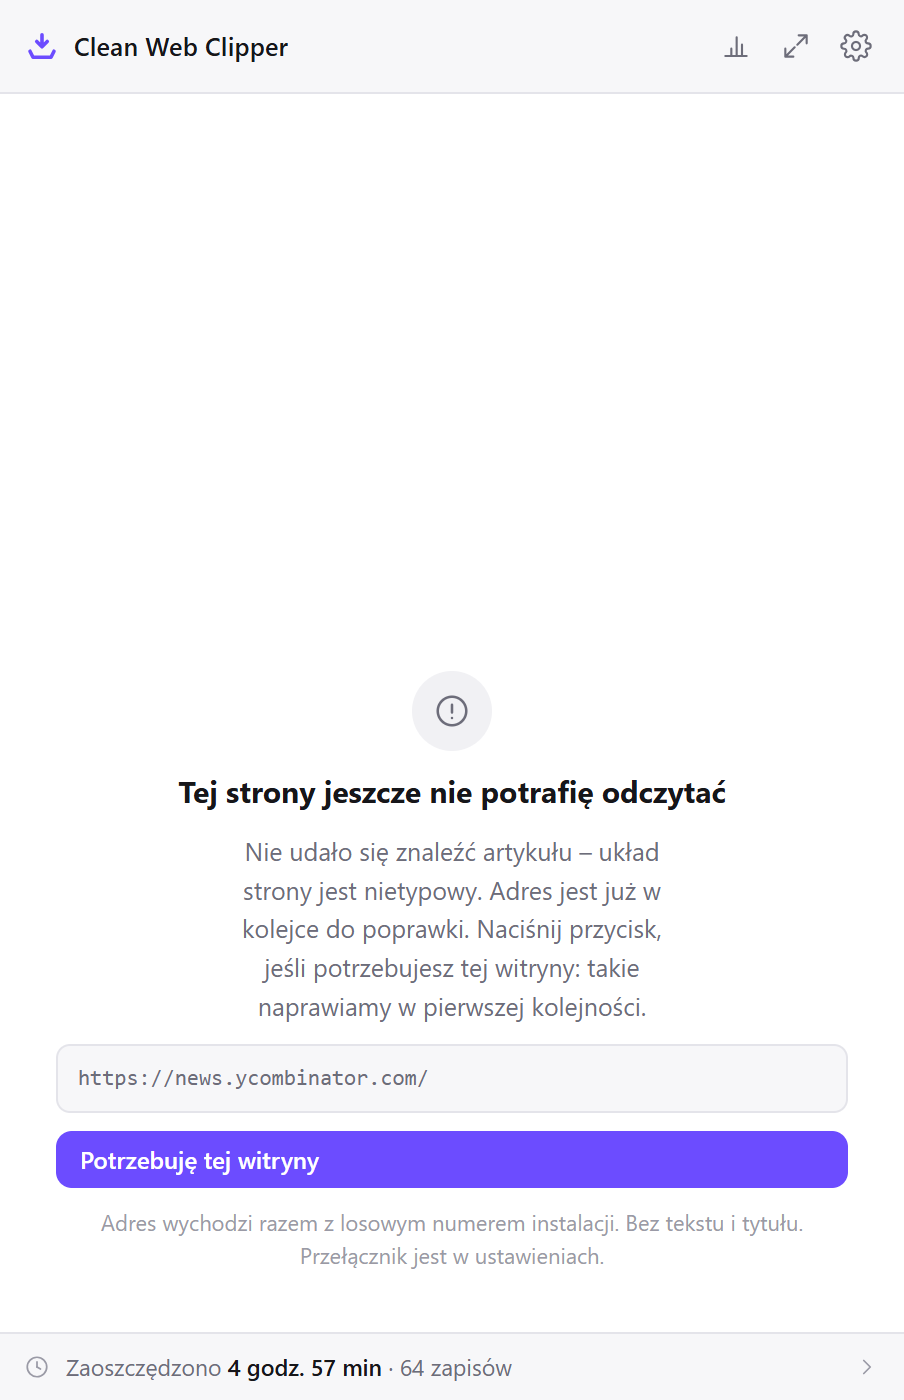
Każda notatka dostaje pole extraction. dom znaczy, że tekst pochodzi z tego, co przeglądarka faktycznie wyrenderowała. jsonld-articlebody znaczy, że strona nigdy nie dokończyła renderowania i treść trzeba było odczytać z jej własnych danych strukturalnych. A kiedy artykułu na stronie nie ma wcale – sklep, lista wpisów, wyniki wyszukiwania – rozszerzenie tak właśnie mówi, zamiast wysypać na Ciebie trzysta odnośników.
Czego nie robi
- Nie chodzi po witrynie i nie działa wsadowo – jedna strona naraz, ta, na której jesteś
- Nie streszcza i nie przepisuje – tekst jest konwertowany, a nie redagowany
- Nie pobiera obrazów – odnośniki do grafik wskazują na oryginalną stronę
Piętnaście sposobów, na jakie się go używa
ProgramiściOgrodzenie kodu zachowuje etykietę języka – kolorowanie działa od razu po wklejeniu.
Clean Web Clipper odczytuje język bloku kodu z samej strony – z klasy przy ogrodzeniu, z elementu nadrzędnego, ze znaczników kolorowania – i wpisuje go za backticki. Na korpusie technicznym metka przetrwała w 73 ogrodzeniach na 156, wobec 20 i 0 w dwóch porównywanych silnikach. Reszta strony trafia do notatki jako zwykły Markdown, bez kolumny bocznej.
- Ogrodzenie wychodzi jako
```js, a nie gołe – kolorowanie działa w Obsidianie, VS Code i na GitHubie od razu po wklejeniu - Język jest czytany ze strony: z klasy przy ogrodzeniu, z elementu nadrzędnego, ze znaczników kolorowania – nigdy zgadywany z treści kodu
- Tabela parametrów z kodem w komórce zachowuje swoje wiersze, zamiast zwinąć się do jednej linii
ObsidianNotatka ląduje w wybranym folderze vaulta z frontmatterem – bez schowka i bez wtyczek.
Clean Web Clipper zapisuje plik .md wprost do folderu, który wskażesz – także do vaulta Obsidiana – z frontmatterem title, source i published na górze. Nie trzeba wtyczki, serwera lokalnego ani przechodzenia przez schowek: notatka pojawia się w vaultcie i Obsidian podnosi ją przy najbliższym odświeżeniu.
- Plik
.mdląduje bezpośrednio w folderze vaulta, który wskażesz – bez wtyczki, bez serwera lokalnego, bez przechodzenia przez schowek - Frontmatter z
title,source,publishediextractionstoi na górze i jest gotowy dla Dataview oraz dla właściwości Obsidiana - Wzorzec nazwy pliku układasz sam:
{date}-{title},{domain}-{title}albo sam{title}
Kontekst dla AIPowtarzana nawigacja strony to kontekst, za który płacisz. Znika, zanim tekst dotrze do modelu.
W przebiegu porównawczym na 109 stronach Clean Web Clipper zostawił 102 powtórzone linie nawigacji, tam gdzie trzy inne silniki zostawiły 282, 478 i 491 – i ani jednego resztkowego znacznika HTML. Do modelu trafia sam artykuł z nagłówkiem frontmattera, który podaje adres źródła i datę publikacji.
- Mniej więcej czterokrotnie mniej powtórzonej nawigacji niż średnio w porównywanych silnikach: 102 powtórzone linie wobec 282, 478 i 491.
- Zero resztkowych znaczników HTML na 512 sprawdzonych stronach: model nie ma czego omijać.
- Frontmatter podaje adres źródła i datę publikacji, więc twierdzenie da się przypisać, zamiast zgadywać jego pochodzenie.
Praca naukowaCzyta citation_date (znacznik z arXiv, PubMed i IEEE) i zamienia odnośniki bibliograficzne w przypisy.
Zapisany artykuł bez daty publikacji to przypis, który później trzeba odtwarzać. Clean Web Clipper czyta datę z metadanych samej strony, a nie z tekstu, a gdy strona żadnej daty nie podaje, pole zostaje puste, zamiast dostać dzisiejszy dzień.
citation_dateicitation_publication_date(znaczniki meta, które wystawiają arXiv, PubMed i IEEE) są czytane wprost.- Także
datePublishedz JSON-LD,article:published_time,time[datetime]i znaczniki czasu Unix, w tej kolejności. - Brak daty na stronie to puste pole – nigdy dzisiejsza data.
StudenciWykłady, rozdziały i strony z materiałami zapisane jako pliki Markdown, które przeżyją logowanie do kursu.
Materiały z przedmiotu znikają razem z końcem semestru: odnośniki wygasają, strona kursu idzie do archiwum, lektura na seminarium zmienia adres. Pliki Markdown na twoim dysku zostają i za dziesięć lat otworzą się w dowolnym edytorze, nadal z adresem źródła w środku.
- Zaznacz fragment, a zapisze się tylko zaznaczenie – tak bierze się jedną definicję bez strony wokół niej.
- Każda notatka niesie adres źródła, więc późniejsze cytowanie nie wymaga szukania.
- Widok do czytania pokazuje wycinek jako zwykły tekst, bez znaków Markdowna, jeszcze przed zapisem.
PiszącyTytuł, autor, data publikacji i adres źródła jadą z każdym wycinkiem, więc cytat zachowuje pochodzenie.
Materiał zbierany jako zrzuty ekranu i zakładki przestaje się nadawać do użytku dokładnie wtedy, gdy trzeba go przypisać autorowi. Plik Markdown trzyma tytuł, autora, datę i adres w tym samym pliku co tekst – tam, gdzie sięgnie weryfikacja.
title,author, data isourcewe frontmatterze każdej notatki, więc przypisanie mieszka razem z tekstem.- Pole autora jest filtrowane: nagłówki sekcji, nazwy publikacji i etykiety przycisków nie są brane za podpis.
- Tylko treść artykułu: okienka newslettera, paski udostępniania i listy „czytaj dalej” nie docierają do notatki.
DziennikarzeTekst taki, jaki czytałeś, z datą publikacji i adresem, w pliku na twoim własnym dysku.
Strony są redagowane i zdejmowane. Wycinek trzyma pełny tekst, adres źródła i datę publikacji zadeklarowaną przez samą stronę, w zwykłym pliku, który masz u siebie – a nie w serwisie, który może się zamknąć, zmienić regulamin albo po cichu zgubić zapis.
- Data publikacji czytana z metadanych samej strony – JSON-LD,
article:published_time,time[datetime]– a nie z tekstu. - Adres źródła stoi we frontmatterze każdej notatki.
- Pełny tekst artykułu bez nawigacji i bloków promocyjnych, które zmieniają się między wizytami.
Praca prawniczaTekst w brzmieniu z publikacji, z adresem źródła i datą, w pliku, nad którym masz kontrolę.
Przepisy, regulaminy i oficjalne wyjaśnienia zmieniają się bez zapowiedzi. Kopia w Markdownie z adresem, spod którego pochodzi, i datą zadeklarowaną przez stronę to zapis tego, co tekst mówił w dniu, w którym go czytałeś.
- Tekst dosłowny – w treści artykułu nic nie jest streszczane, przepisywane ani przestawiane.
- Adres źródła i data publikacji zadeklarowana przez stronę we frontmatterze każdej notatki.
- Tabele opłat, terminów i progów serializuje samo rozszerzenie: 12 z 15 zachowanych na korpusie technicznym, wobec 7 w każdym porównywanym silniku.
AnalitycyKomórka z kodem, listą albo odnośnikiem nie rozbija już wiersza: 12 z 15 tabel zachowanych.
Ogólne konwertery HTML do Markdowna psują się na tabelach, które się liczą: tych z listą, odnośnikiem albo przykładem kodu w komórce. Clean Web Clipper sam serializuje tabelę i spłaszcza zawartość komórki, zamiast gubić wiersz.
- Serializator tabel GFM napisany do tego zadania, a nie przykręcona wtyczka ogólnego konwertera.
- 12 tabel z 15 zachowanych na korpusie technicznym, wobec 7 w każdym porównywanym silniku.
- Nierówne tabele dwukolumnowe stają się liniami z pogrubionym kluczem i wartością zamiast rozsypanej siatki.
NauczycieleSam materiał, bez witryny wokół: bez menu, paska zgody i reklam na wydrukowanej kartce.
Strona wydrukowana prosto z przeglądarki przenosi na kartkę swoje menu, pasek zgody i reklamy. Wycinek przenosi tekst, a adres źródła zostaje w pliku, więc podanie źródła nie wymaga dodatkowej pracy.
- Przycisk drukowania, który drukuje wycinek, a nie stronę wokół niego.
- Widok do czytania pokazuje wynik jako zwykły tekst, bez znaków Markdowna, zanim wydrukujesz albo zapiszesz.
- Zaznacz jedno zadanie albo jedną definicję i zapisz tylko to.
TłumaczeMenu, banery i powtarzana nawigacja nigdy nie trafiają na listę segmentów.
Tekst źródłowy wklejony ze strony internetowej przynosi ze sobą nawigację, a każda pozycja menu staje się segmentem, który trzeba pominąć, policzyć i w końcu wytłumaczyć na fakturze. Clean Web Clipper usuwa ją, zanim plik w ogóle zbliży się do twojego narzędzia.
- Menu, paginacja, paski zgody i kanały „czytaj dalej” są wycinane, zanim plik powstanie.
- Powtórzona nawigacja zredukowana mniej więcej czterokrotnie wobec porównywanych silników: 102 powtórzone linie wobec 282, 478 i 491.
- Ani jednego resztkowego znacznika HTML na 512 sprawdzonych stronach, więc żaden zabłąkany znacznik nie zamieni się w tag wewnątrzsegmentowy.
Menedżerowie produktuListy zmian, dokumentacja i informacje o wydaniach w plikach, które da się przeszukać, porównać i zacytować.
Analiza konkurencji trzymana w zakładkach rozpada się w listę odnośników, której nie da się przeszukać. Zapisana w Markdownie staje się zbiorem, który przeszukasz grep, porównasz z zapisem z zeszłego kwartału i zacytujesz w dokumencie decyzyjnym razem z datą.
- Data publikacji odczytana ze strony, więc wpis z listy zmian zachowuje prawdziwy termin, a nie dzień, w którym go znalazłeś.
- Reguły dla witryn same kierują każdego konkurenta do jego folderu.
- Tabele cen i limitów przetrwają: 12 z 15 zachowanych na korpusie technicznym, wobec 7 w każdym porównywanym silniku.