Розширення для Chrome ·
Зберегти вебсторінку в Markdown, який не треба вичищати
Щоб зберегти вебсторінку в Markdown, досить натиснути іконку: заголовок, автор, дата публікації та адреса джерела вже зібрані у frontmatter, а текст – без навігації. Видобування відбувається у вашому браузері: без акаунта, і текст сторінки ніколи його не залишає.
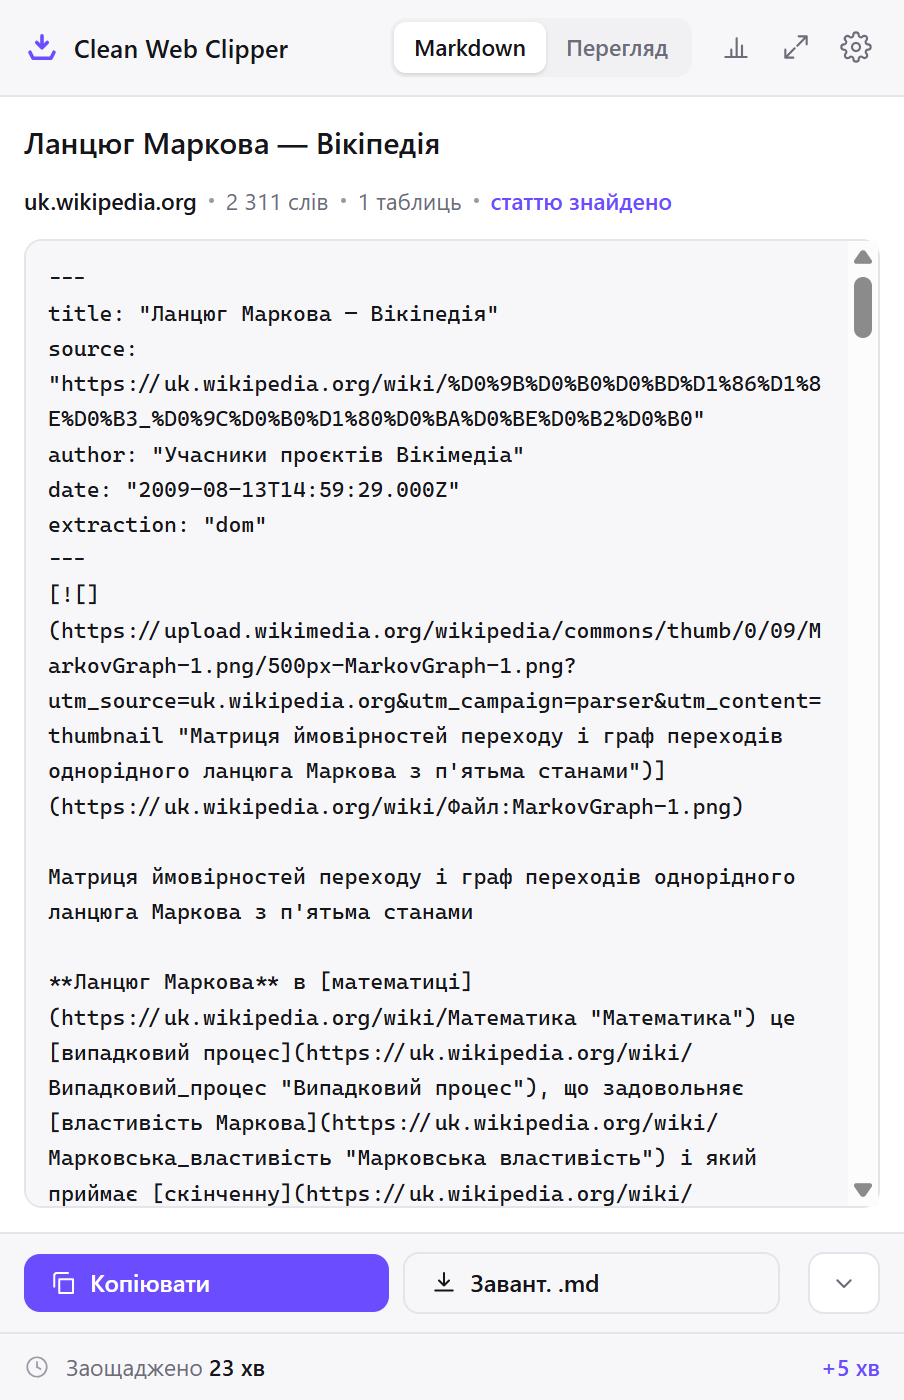
Clean Web Clipper – безкоштовне розширення для Chrome, що зберігає вебсторінку в чистий Markdown: у буфер обміну, файл .md, теку або просто у vault Obsidian, без акаунта й без входу. Протестовано на 512 сторінках найвідвідуваніших сайтів: жодного падіння і жодного вцілілого тега HTML у видобутих статтях.
Протестовано на 512 сторінках найвідвідуваніших сайтів світу
Два прогони. Перший узяв 109 сторінок зі ста найвідвідуваніших сайтів світу та Росії і порівняв результат пліч-о-пліч із трьома іншими рушіями видобування. Другий узяв по п’ятдесят найвідвідуваніших сайтів у кожній із дванадцяти європейських країн: ще 403 сторінки, кожну знято мовою своєї країни й пропущено лише через наше ядро. Рушії, версії, дати й де ми позаду
Проблема ніколи не в конвертації. Проблема в тому, що приїжджає разом із нею.
Перетворити HTML на Markdown вміє будь-яке розширення. А потім ви відкриваєте нотатку – і бачите там банер про cookie, бічне меню, список «читайте також» і таблицю, що розсипалася дорогою. Clean Web Clipper побудований саме навколо того, щоб це прибирати, і прибирання тут не заявлене, а виміряне.
що лишають інші розширення
[До змісту](#main) [Увійти](/login) [Зареєструватися](/register)
[Головна](/) [Новини](/news) [Спорт](/sport) [Культура](/culture) [Ще](/more)

Ми використовуємо файли cookie та подібні технології, щоб покращити ваш досвід.
[Прийняти всі] [Налаштувати]

# Стаття, по яку ви прийшли

Справжній перший абзац тексту.

<div class="promo-inline">

## Читайте також
[Інший заголовок](/a) [Ще один заголовок](/b) [І третій](/c)
що потрапляє в нотатку
# Стаття, по яку ви прийшли

Справжній перший абзац тексту.
Що робить результат чистим
- Код зберігає мову. Блок виходить із міткою
js, а не голий, тому підсвічування працює одразу після вставляння. - Таблиці лишаються цілими. Комірка з кодом або списком більше не розриває рядок.
- Виноски справді працюють. Посилання-примітки стають
[^1]з визначеннями в кінці нотатки, а не мертвими якорями. - Дату читають, а не вгадують. JSON-LD,
article:published_time,citation_date(стандарт arXiv, PubMed, IEEE),time[datetime], мітки Unix. Якщо дати на сторінці немає – поле лишиться порожнім, а не сьогоднішнім числом. - Меню, банери й «читайте також» зрізаються. Смуги логотипів, пагінатори та навігація, повторена в кожній секції, до нотатки не доходять.
- Жодного вцілілого тега. Ніяких
divчиtableпосеред вашого тексту.
---
title: "Ланцюг Маркова – Вікіпедія"
source: "https://uk.wikipedia.org/wiki/Ланцюг_Маркова"
date: "2006-03-11T09:42:18.000Z"
extraction: "dom"
---

Ланцюг Маркова – послідовність випадкових подій зі скінченною або зліченною
кількістю результатів, у якій імовірність кожної події залежить лише від стану,
досягнутого в попередній події.[^1]

[^1]: Марков А. А. Поширення закону великих чисел на величини, що залежать
      одна від одної. – Доповідь Казанському фізико-математичному товариству, 1906.
Як зберегти вебсторінку в Markdown у Chrome
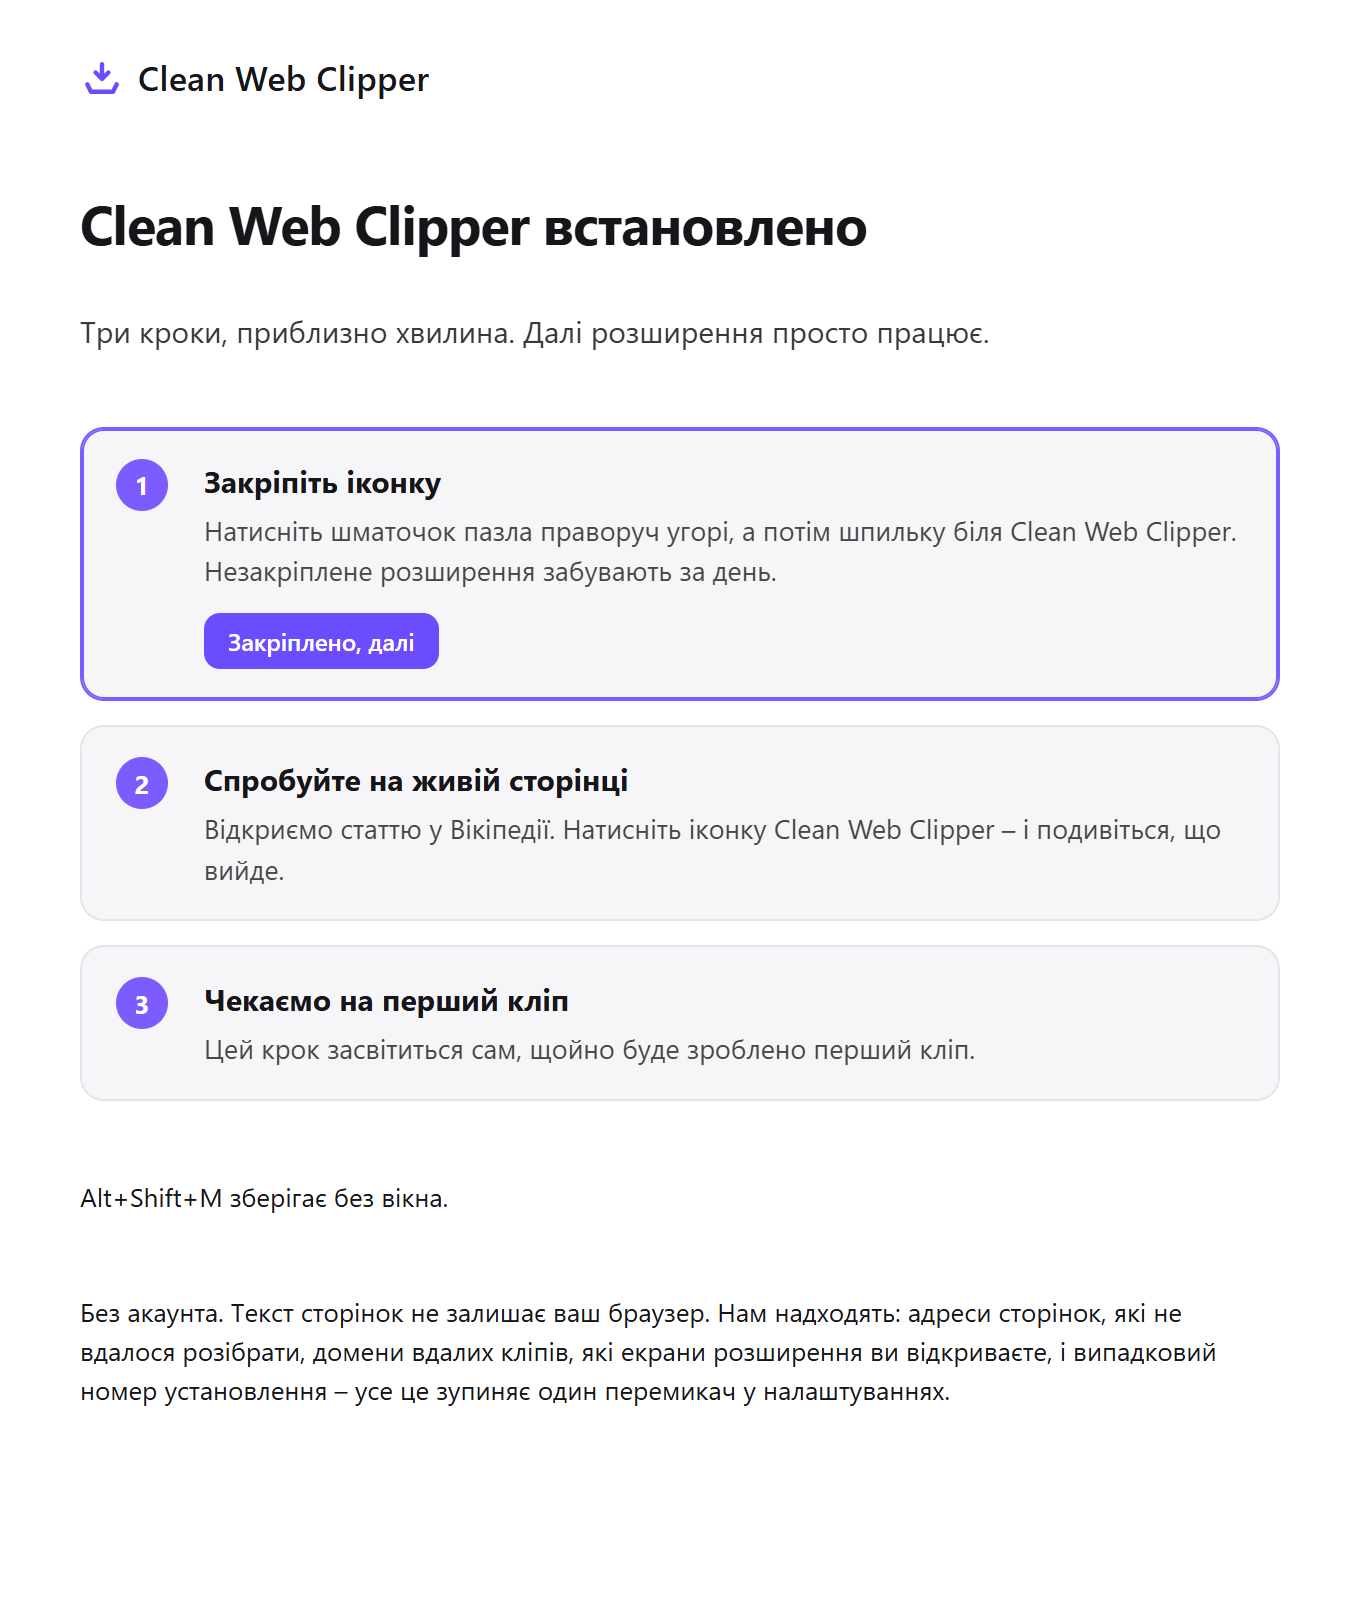
Установіть розширення – далі три кроки. Заздалегідь нічого налаштовувати не треба: типово клік відкриває вікно перегляду з уже готовим Markdown, який можна скопіювати або зберегти файлом. Згодом можна зробити так, щоб один клік записував нотатку просто в теку чи vault, минаючи перегляд.
- Закріпіть іконку. Відкрийте меню з пазлом біля адресного рядка й закріпіть Clean Web Clipper на панелі.
- Відкрийте статтю, яку хочете зберегти, – саму статтю, а не сторінку з посиланнями на неї.
- Натисніть іконку. Markdown з’явиться у вікні перегляду: скопіюйте його або збережіть файл
.md.
Куди зберігає
- Скопіювати Markdown у буфер обміну
- Завантажити файл
.md - Записати в обрану вами теку на диску
- Записати просто у ваш vault Obsidian – без плагіна, без локального REST API, без URI-схеми; файл просто з’являється
Дія на клік по іконці налаштовується. Можна лишити вікно з переглядом, а можна зробити так, щоб один клік клав нотатку у vault і не відкривав нічого.
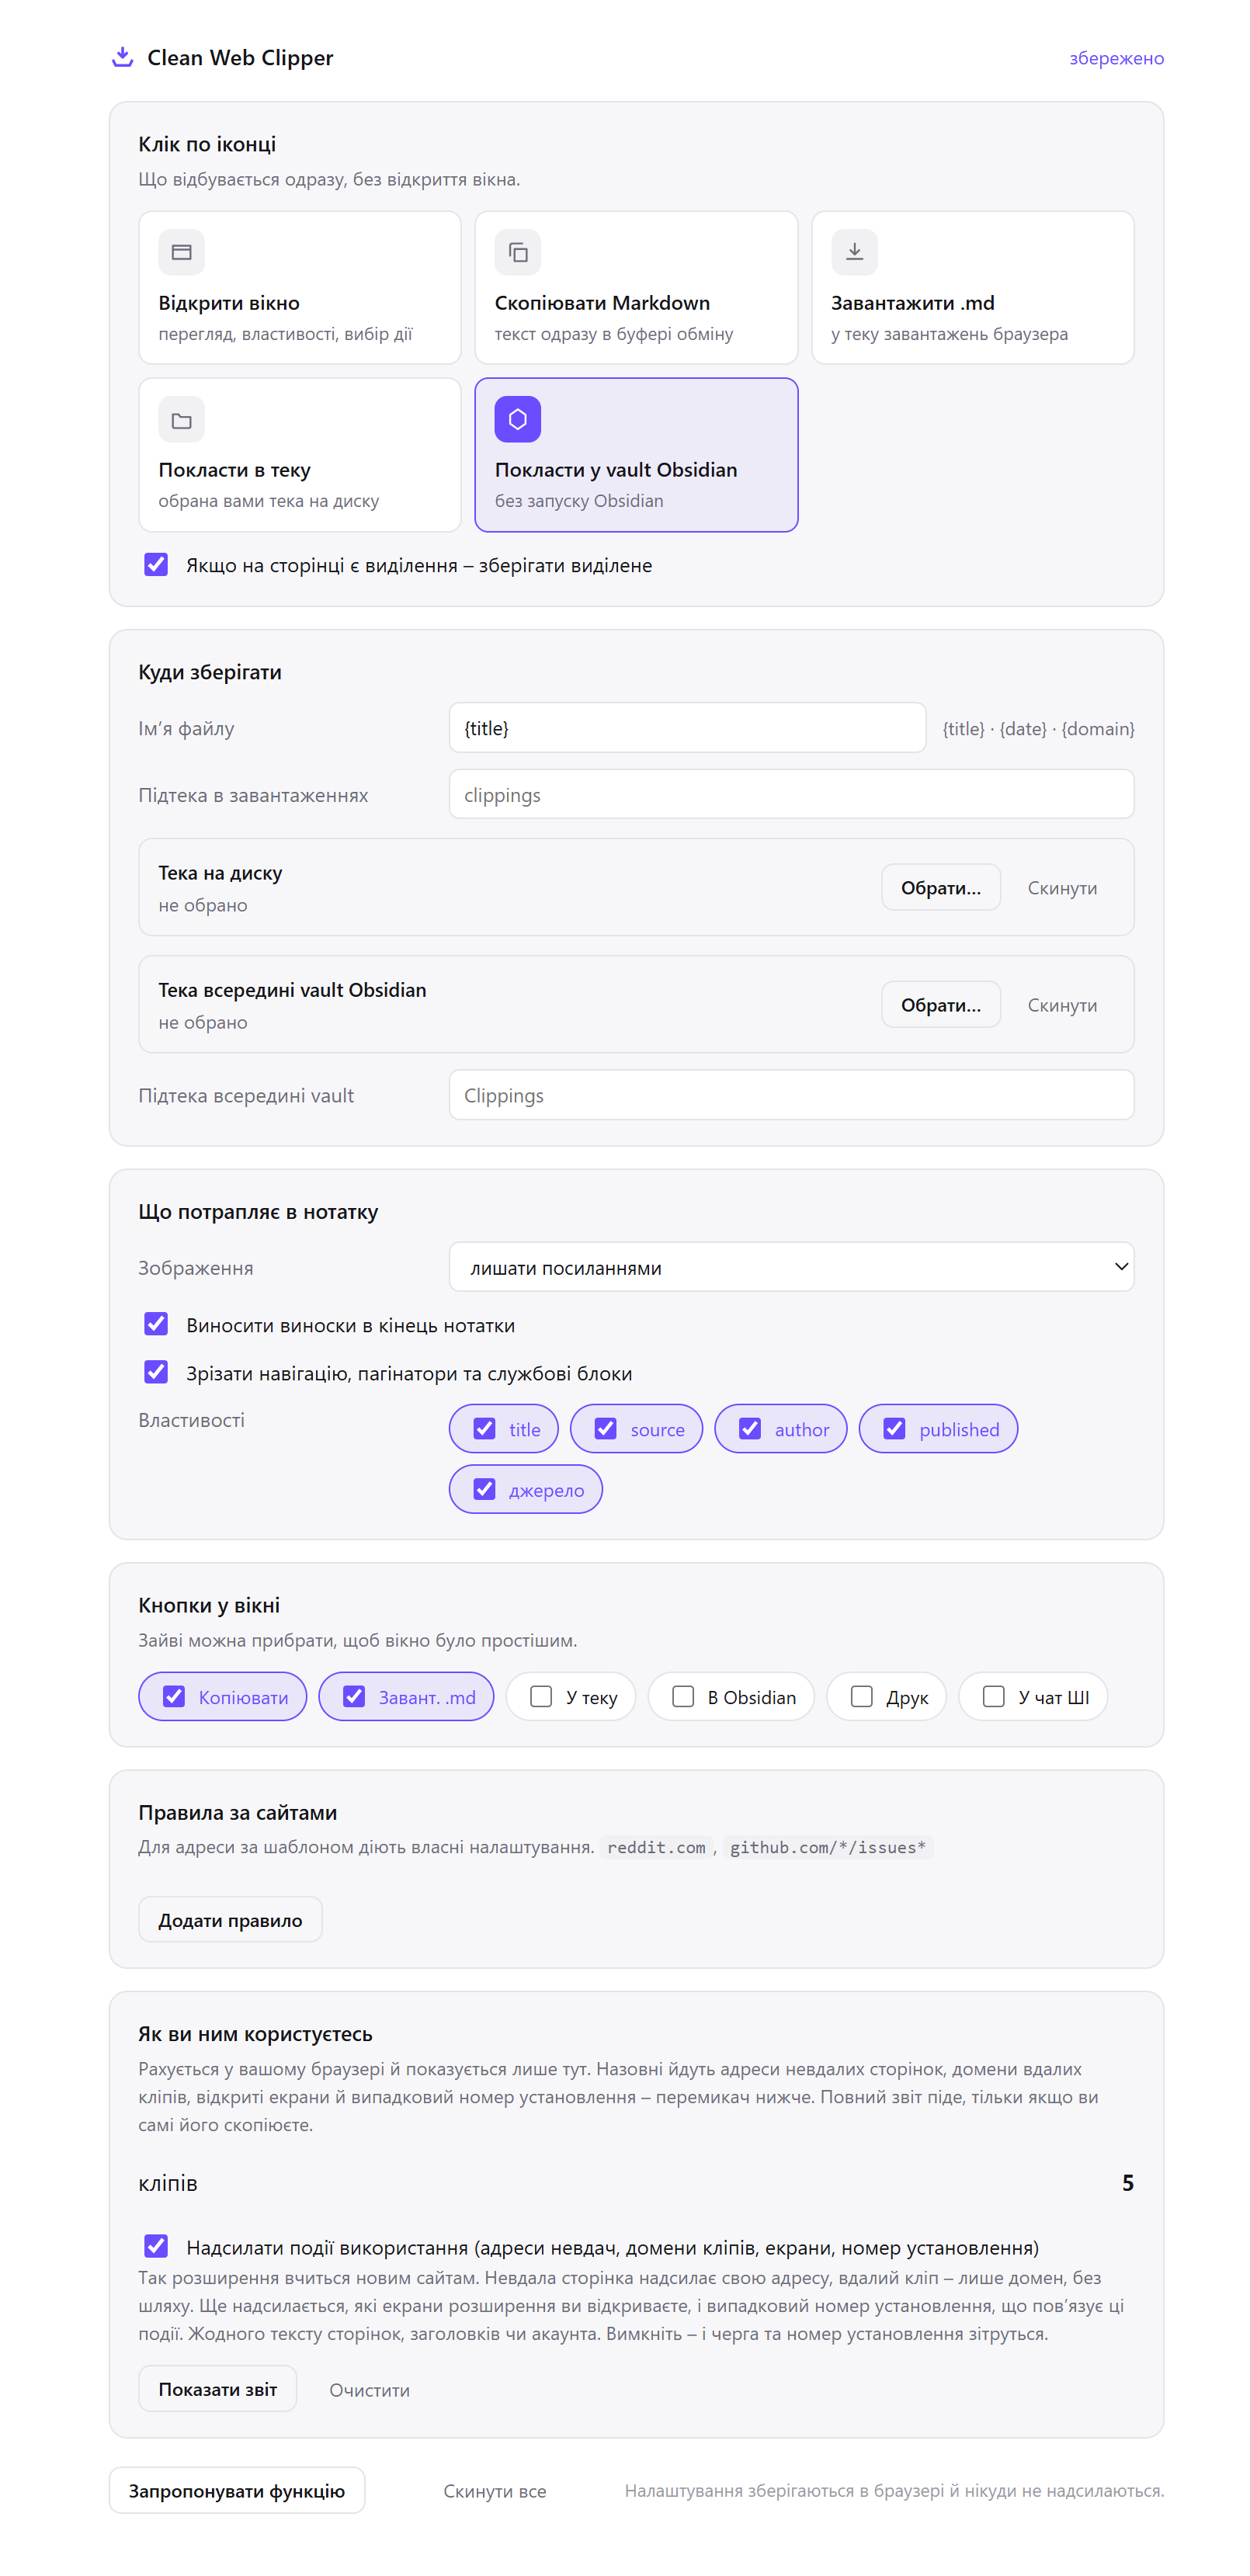
Чесно про джерело
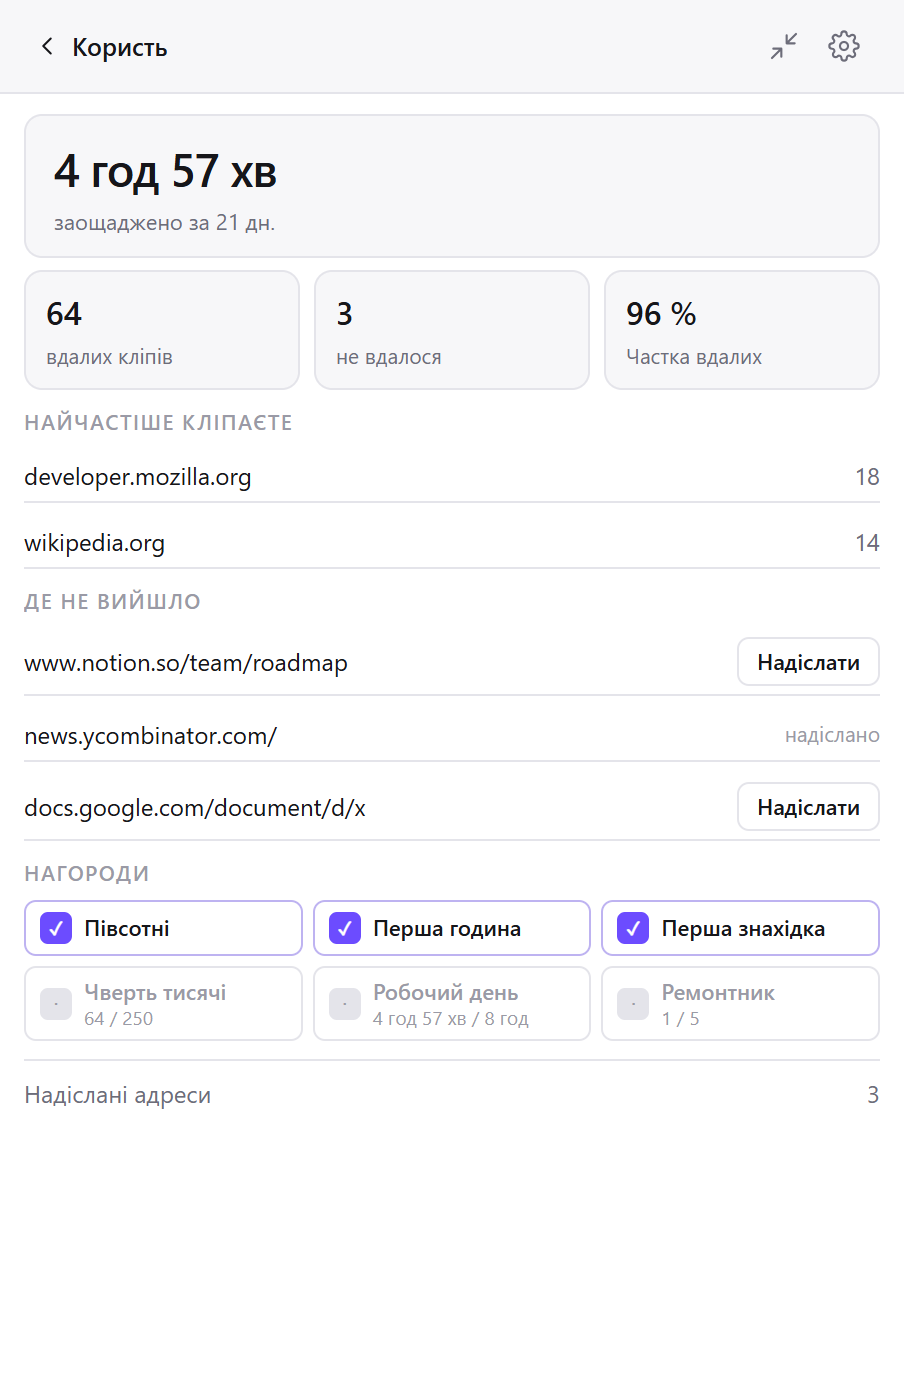
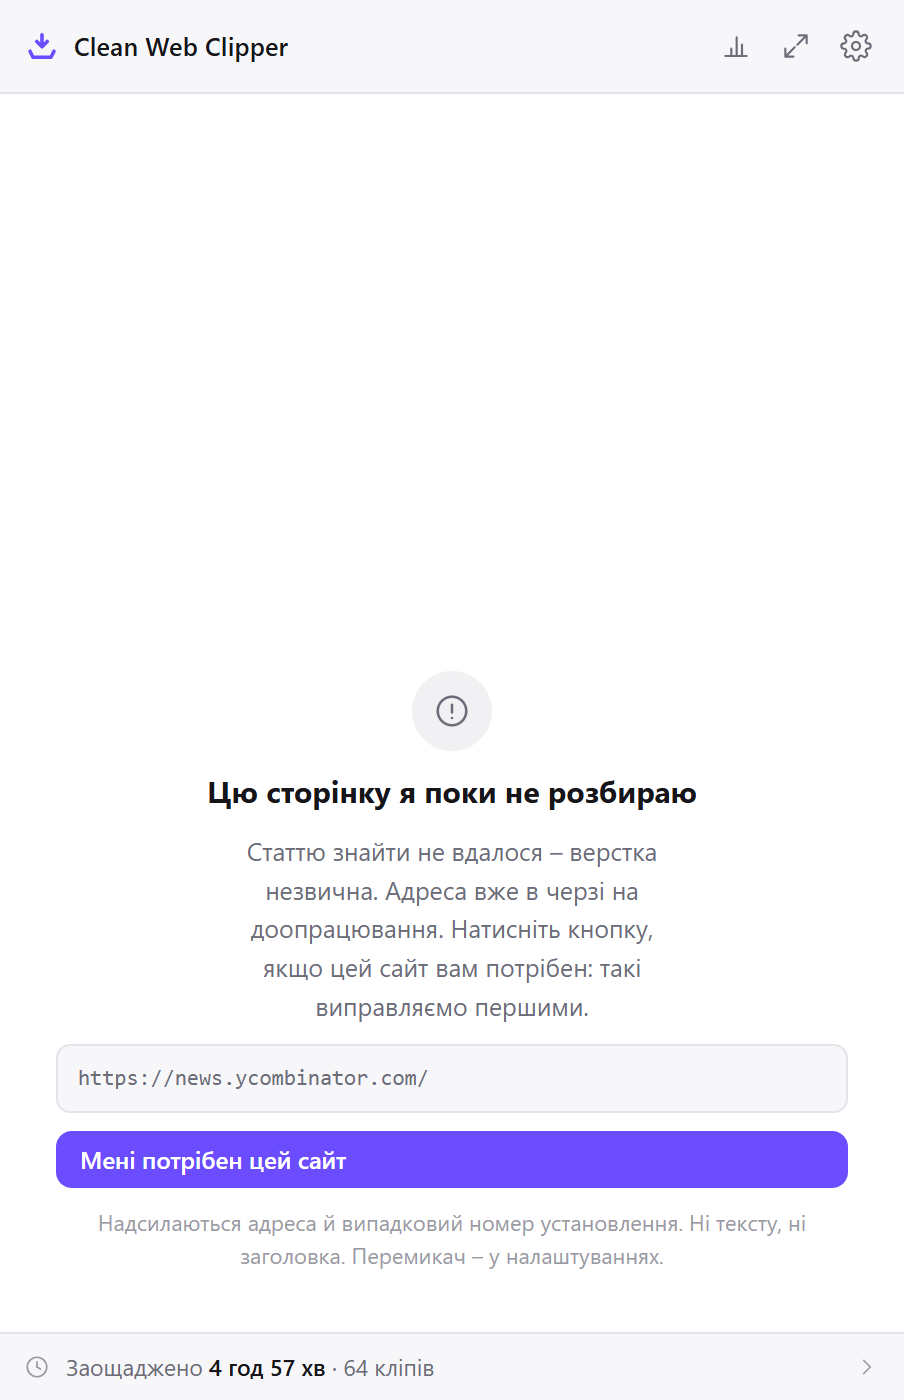
Кожна нотатка має поле extraction. dom означає, що текст узято з того, що браузер справді відмалював. jsonld-articlebody – що сторінка так і не дорендерилася і тіло довелося взяти з її ж структурованих даних. А коли статті на сторінці немає взагалі – вітрина, стрічка, результати пошуку – розширення так і каже, замість того щоб вивалити на вас триста посилань.
Чого воно не робить
- Не обходить сайт і не обробляє пакетами – одна сторінка за раз, та, на якій ви стоїте
- Не переказує й не переписує – текст конвертується, а не редагується
- Не завантажує зображення – посилання на картинки ведуть на початковий сайт
П’ятнадцять способів це використати
РозробникамБлоки коду зберігають мітку мови, тож вставлений фрагмент підсвічується одразу.
Довідник – це переважно код, і саме його більшість розширень губить дорогою. Clean Web Clipper зчитує мову з розмітки самої сторінки – з класу огорожі, з батьківського елемента або з розмітки підсвічувача – і записує її в блок. На технічному корпусі з дев’яти сторінок мітка вціліла в 73 огорожах зі 156 – проти 20 і 0 у двох порівнюваних рушіїв. Вставлений фрагмент підсвічується в Obsidian, VS Code і на GitHub без жодної правки руками.
- Блок виходить як
```js, а не голий – підсвічування в Obsidian, VS Code і на GitHub працює одразу після вставляння - Мову беруть із розмітки сторінки: клас огорожі, батьківський елемент, сліди підсвічувача – розширення не вгадує її з самого коду, тож мітка правильна рівно настільки, наскільки правильна сторінка
- Таблиці параметрів серіалізує саме розширення: комірка зі списком або кодом більше не розриває рядок – на технічному корпусі цілими лишилися 12 таблиць із 15 проти 7 у кожного з порівнюваних рушіїв
Користувачам ObsidianОберіть теку всередині vault – і один клік покладе нотатку туди. Obsidian запускати не треба.
Щоб зберегти вебсторінку в Markdown просто у vault, Clean Web Clipper не потребує ані плагіна спільноти, ані локального сервера, ані посилань obsidian://. Ви один раз обираєте теку, браузер запам’ятовує дозвіл – далі файл з’являється сам, навіть коли Obsidian закритий.
- Без плагіна, без локального сервера, без посилань
obsidian://– розширення пише файл саме - Obsidian не мусить бути відкритий: файл просто вже лежить у теці, коли ви туди зазирнете
- YAML-frontmatter із title, source, author, датою та способом видобування – ви самі обираєте, що з цього лишити
Робота з ШІ та LLMПовторена навігація – це витрачений контекст. Він зрізається до того, як текст дійде до моделі.
На корпусі зі 109 сторінок (порівняльний прогін пліч-о-пліч) Clean Web Clipper лишив 102 дубльовані рядки навігації там, де три інші рушії видобування лишили 282, 478 і 491, – і жодного вцілілого тега HTML. До моделі доходить сама стаття плюс шапка frontmatter, де названо адресу джерела й дату публікації.
- Приблизно вчетверо менше дубльованої навігації, ніж у середньому в порівнюваних рушіїв: 102 повторені рядки проти 282, 478 і 491
- Жодного вцілілого тега HTML ні в одній видобутій статті на 512 протестованих сторінках – моделі не доводиться продиратися крізь уламки розмітки
- YAML-frontmatter прямо віддає моделі адресу джерела й дату публікації, тож твердження можна приписати джерелу, а не вгадувати
ДослідникамЧитає citation_date – стандарт arXiv, PubMed та IEEE – і виносить примітки в кінець нотатки.
Збережена стаття без дати – це посилання, яке потім доведеться відновлювати руками. Clean Web Clipper бере дату з метаданих самої сторінки, а не вгадує її з тексту; якщо на сторінці дати немає, поле лишається порожнім, а не заповнюється сьогоднішнім числом.
- Читає
citation_dateіcitation_publication_date– метатеги, які віддають arXiv, PubMed та IEEE - А також JSON-LD
datePublished,article:published_time,time[datetime]і мітки Unix – саме в такому порядку - Порожня дата чесніша за вигадану: якщо сторінка мовчить, поле лишається порожнім
СтудентамЛекції, розділи й довідкові сторінки – у файли Markdown, які переживуть доступ до курсу.
Матеріали курсу зникають, щойно закінчується семестр: посилання гниють, сторінку дисципліни архівують, матеріал до семінару переїжджає. Clean Web Clipper кладе прочитане у файли Markdown на вашому диску – вони відкриються в будь-якому редакторі й через десять років, з адресою джерела всередині.
- Виділили уривок – збережеться лише виділене: так беруть одне означення без сторінки навколо
- У кожній нотатці є адреса джерела, тож послатися на неї в роботі можна без жодного пошуку
- Режим читання показує результат звичайним текстом, без символів Markdown, ще до збереження
АвторамЗаголовок, автор, дата публікації й адреса джерела їдуть із кожною нотаткою, тож цитата не губить походження.
Матеріал, зібраний знімками екрана й закладками, стає непридатним саме тоді, коли на нього треба послатися. Файл Markdown тримає заголовок, автора, дату й адресу в тому самому файлі, що й текст, – там, де їх знайде перевірка фактів.
title,author,dateіsourceу frontmatter кожної нотатки – підпис живе разом із текстом.- Поле автора фільтрується: назви рубрик, назви видань і підписи кнопок за автора не вважаються.
- Лише тіло статті: форми розсилки, панелі «поділитися» й стрічки «читайте також» до нотатки не доходять.
ЖурналістамТекст таким, яким ви його прочитали, з датою публікації й адресою, у файлі на вашому диску.
Сторінки редагують і знімають. Збережена нотатка тримає повний текст, адресу джерела й дату публікації, яку оголосила сама сторінка, у звичайному файлі, що лишається у вас, а не в сервісі, який може закритися, змінити умови або тихо загубити запис.
- Дата публікації – з метаданих самої сторінки: JSON-LD,
article:published_time,time[datetime], а не з тексту статті. - Адреса джерела стоїть у frontmatter кожної нотатки.
- Повний текст статті без навігації та промоблоків, які змінюються від відвідин до відвідин.
Юридична роботаТекст так, як його опубліковано, з адресою джерела й датою, у файлі, яким розпоряджаєтеся ви.
Нормативні акти, умови користування й офіційні роз’яснення змінюються без попередження. Копія в Markdown з адресою, звідки її взято, і датою, яку оголосила сторінка, – це запис того, що текст говорив у день, коли ви його читали.
- Дослівний текст – усередині тіла статті ніщо не скорочується, не переписується й не переставляється.
- Адреса джерела й дата публікації, оголошена сторінкою, – у frontmatter кожної нотатки.
- Таблиці зборів, строків і порогів серіалізує саме розширення: на технічному корпусі збережено 12 із 15 проти 7 у кожного з порівнюваних рушіїв.
АналітикамКомірка з кодом, списком чи посиланням більше не розриває рядок: цілими лишилися 12 таблиць із 15.
Універсальні конвертери HTML у Markdown ламаються саме на тих таблицях, які мають значення, – там, де в комірці список, посилання чи фрагмент коду. Clean Web Clipper пише таблицю сам і сплющує вміст комірки замість того, щоб викидати рядок.
- Серіалізатор таблиць GFM, написаний саме для цього, а не універсальний плагін до конвертера.
- 12 таблиць із 15 цілими на технічному корпусі – проти 7 у кожного з порівнюваних рушіїв.
- Нерівні двоколонкові таблиці стають рядками з жирним ключем і значенням, а не поламаною сіткою.
ВикладачамСам матеріал без сайту довкола: без меню, без банера про cookie й без реклами на аркуші.
Сторінка, надрукована просто з браузера, переносить на роздатку своє меню, банер про cookie й рекламу. Збереження через розширення бере лише текст, а адресу джерела лишає всередині файлу, тож послатися на першоджерело не коштує додаткової роботи.
- Кнопка друку друкує збережений текст, а не сторінку з усім, що довкола.
- Режим читання показує результат звичайним текстом, без символів Markdown, ще до друку чи збереження.
- Виділіть одну вправу чи одне означення – і збережеться лише воно.
ПерекладачамМеню, банери й повторена навігація не доходять до списку сегментів.
Вихідний текст, вставлений із вебсторінки, тягне за собою навігацію, і кожен пункт меню стає сегментом, який доводиться пропускати, рахувати в обсязі й зрештою пояснювати в рахунку. Clean Web Clipper прибирає це ще до того, як файл потрапить у вашу програму.
- Меню, пагінатори, банери згоди й стрічки «читайте також» зрізаються ще до появи файлу.
- Дубльованої навігації приблизно вчетверо менше, ніж у порівнюваних рушіїв: 102 повторені рядки проти 282, 478 і 491.
- Жодного вцілілого тега HTML у видобутих статтях на 512 протестованих сторінках, тож жоден уламок розмітки не стане внутрішнім тегом.
Продакт-менеджерамСписки змін, документація й нотатки до релізів – у файлах, де можна шукати, порівнювати й цитувати.
Конкурентна розвідка, складена в закладки, з часом вироджується в перелік посилань, у якому нічого не знайти. Збережена в Markdown, вона стає корпусом: по ньому шукають через grep, його порівнюють зі збереженням минулого кварталу і цитують у документі з рішенням – разом із датою.
- Дату публікації читають зі сторінки, тож запис у списку змін зберігає справжній час виходу, а не день, коли ви його знайшли
- Правила за сайтом самі розкладають кожного конкурента в його власну теку
- Таблиці цін і обмежень доїжджають цілими: на технічному корпусі збережено 12 із 15 – проти 7 у кожного з порівнюваних рушіїв
Технічним письменникамЗаголовки, таблиці, огорожі коду й виноски переїжджають; обв’язка сайту лишається на сайті.
Перенесення документації зазвичай означає конвертувати HTML, а потім довше вичищати те, що конвертер залишив. Саме навколо цього вичищання й побудовано Clean Web Clipper, і саме його перевірено: на 512 протестованих сторінках у видобутих статтях не лишилося жодного тега HTML.
- Заголовки, списки, таблиці, огорожі коду й виноски лягають у стандартний Markdown
- Огорожі зберігають мітку мови: на технічному корпусі – 73 зі 156, проти 20 і 0 у порівнюваних рушіїв
- Жодного вцілілого тега HTML у видобутих статтях на 512 протестованих сторінках
Особистий архівЗвичайні файли Markdown на вашому диску. Без акаунта, без сервісу, без нічого, що можна закрити.
Закладки вказують на сторінки, які змінюються або зникають, а сервіси «прочитати пізніше» закриваються, переходять до інших власників або починають брати гроші за експорт. Збережена нотатка – це сам текст, у форматі без постачальника й без строку придатності, і лежить він там, де вирішили ви.
- Довговічний відкритий формат: звичайний текст із YAML-frontmatter, який читає будь-який редактор і
grep - Без акаунта: текст і заголовок сторінки не залишають ваш браузер, а збережене лежить на вашому диску
- Дата публікації й адреса джерела зберігаються разом із текстом, тож нотатку можна впізнати й через роки
Читання без шумуРежим читання без меню, банерів і символів Markdown – у світлій чи темній темі вашого браузера.
Обв’язка сторінки – це не лише візуальний безлад: це текст, який читалка з екрана озвучує, а читач мусить пропускати на кожній сторінці. Вікно збереження показує саму статтю, у світлій або темній темі вашого браузера, і жоден скрипт сторінки в ньому не виконується.
- Режим читання малює результат як звичайний текст – без символів Markdown, з робочими посиланнями й справжніми заголовками
- Вікно слухається світлої чи темної теми вашого браузера, а не теми сайту
- Для довгої статті вікно розгортається приблизно на три чверті екрана