Clean Web Clipper
Clean Web Clipper no funcionó en un sitio que necesitas
Cuando Clean Web Clipper no funciona en un sitio, casi siempre la extensión no encontró ningún artículo en la página y lo dijo en lugar de guardar un menú. A veces es un hueco real de la extracción. En los dos casos, lo que necesitamos para arreglarlo es la dirección de la página.
¿Qué significa «sin artículo»?
La extensión revisa el Markdown terminado. Si más de una cuarta parte está dentro de etiquetas de enlace, la página es un tablón, una tienda o un resultado de búsqueda, y se niega en lugar de entregarte trescientos enlaces. En un artículo de verdad esa negativa es un error de los que se arreglan primero.
El umbral y los pasos previos están en cómo funciona la extracción.
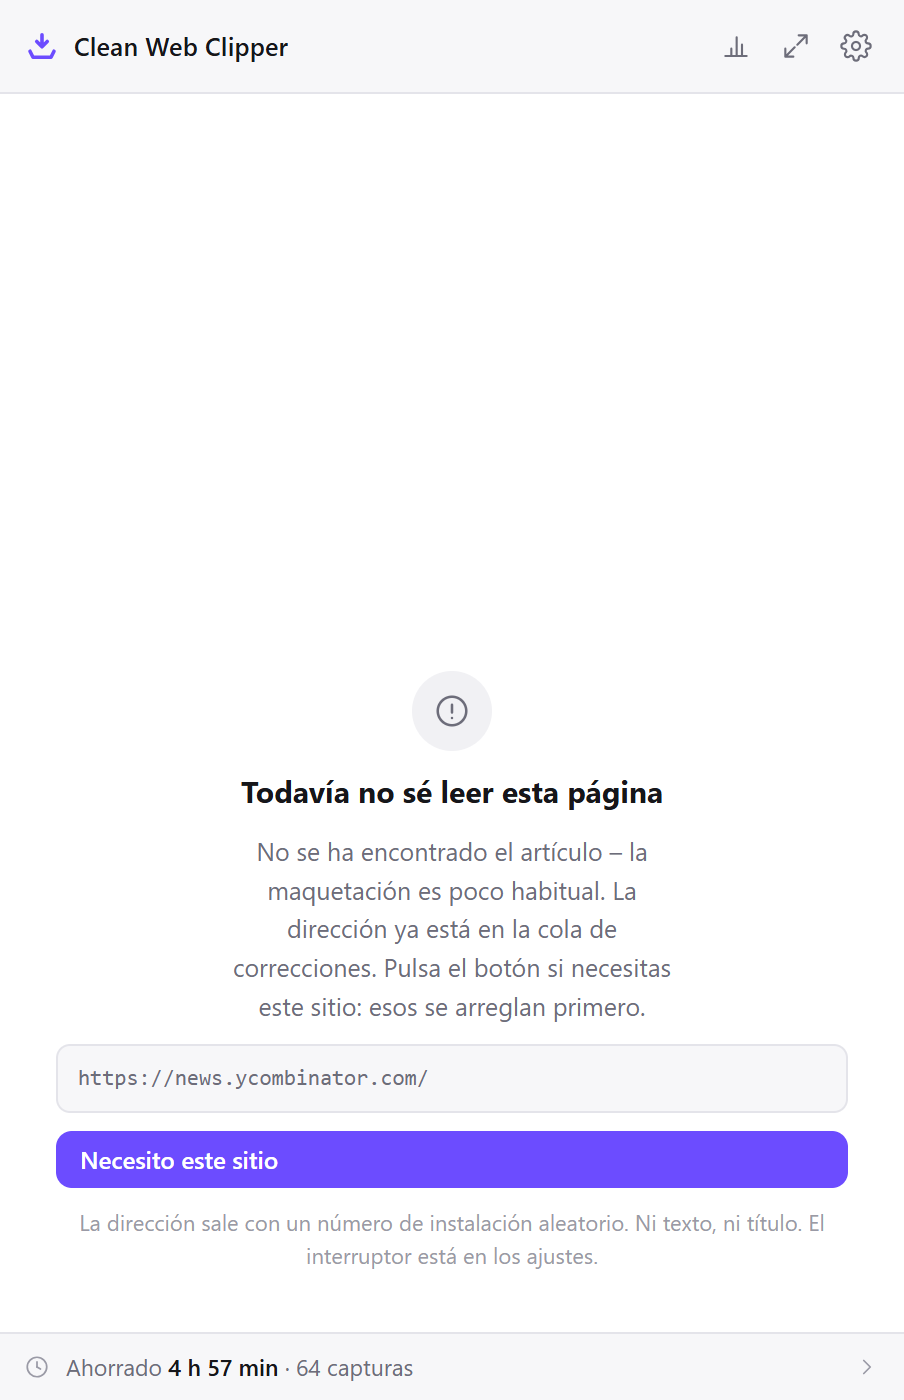
Envíanos la dirección de la página
- En la pantalla de la negativa, pulsa Necesito este sitio. La dirección de esa página entra en la cola de arreglos, y las direcciones por las que la gente pulsa este botón se miran primero. Con ella no se envía ni texto ni título.
- O escribe a cws@lessroutinemorelife.com con la dirección y una frase sobre lo que esperabas obtener.
- Si la extracción funcionó pero la nota salió mal, di qué faltaba – una tabla, el código, la fecha – o adjunta la nota.
Comprueba qué páginas se sabe que no se capturan
No son errores escondidos. Son cosas que una extensión no puede hacer desde dentro de una pestaña del navegador, o que todavía no hace.
- Páginas que aún se están renderizando. Una aplicación de una sola página que no ha terminado de dibujar el artículo no le da a la extensión nada que leer. Espera a que aparezca el texto y captura entonces. Cuando la página lleva su artículo en datos estructurados, se usan esos datos y la nota se marca como
jsonld-articlebody. - Muros de pago e inicios de sesión. La extensión lee lo que muestra tu navegador. Detrás de un inicio de sesión que no tienes no hay nada que capturar; cuando has iniciado sesión, la página se captura como cualquier otra.
- Editores de código incrustados en la página. Editores como CodeMirror y Monaco solo dibujan las líneas que están en pantalla, así que un fragmento largo mostrado en uno de ellos puede salir cortado.
- Archivos PDF. Un PDF abierto en el navegador no es una página HTML y no se puede capturar.
- Páginas que el navegador protege – direcciones
chrome://y la tienda de extensiones, donde no puede ejecutarse ninguna extensión.
¿Sirve de algo una reseña en la tienda?
No. Una reseña en la tienda no se lee como un informe de error y no lleva la dirección de la página, así que con ella no se puede arreglar nada.
Las dos vías que llegan a la cola de arreglos son el botón «Necesito este sitio» de la pantalla de la negativa y un correo con la dirección a cws@lessroutinemorelife.com; la página de preguntas explica qué se envía con cada una.