Para quién es · ·
Archiva una fuente antes de que cambie
Clean Web Clipper guarda el texto completo de una página, su dirección de origen y la fecha de publicación que declaraba, en un archivo que conservas tú. Las páginas se editan y se retiran sin avisar; el archivo no depende de un servicio que puede cerrar, cambiar sus condiciones o perder el registro.
De dónde salen estas cifras: la medición, con las versiones de los motores y las fechas
¿Qué pasa con la página que ayer decía otra cosa?
Un titular se corrige, un párrafo desaparece y una nota de prensa se sustituye por otra versión con la misma dirección. Cuando alguien discute lo que publicaste, el enlace ya no prueba nada: lleva al texto de hoy, no al de aquel día. Y si el medio cierra o rehace su web, la dirección directamente deja de existir.
Guardarlo en el momento tampoco es gratis. Un PDF de la página pesa, no se busca bien y arrastra el menú, la publicidad y el aviso de cookies. Copiar el texto a mano pierde la fecha de publicación, que es justo el dato que después hay que sostener.
Y una parte de las fuentes ni siquiera es un artículo. Un hilo de foro, un anuncio en una comunidad, una respuesta enterrada entre doscientos comentarios: material que desaparece cuando alguien borra su cuenta. En Reddit los comentarios se capturan como hilo compacto con la puntuación de cada uno, que es la forma de conservar quién dijo qué y cuánto apoyo tenía; en el resto de sitios los comentarios se tratan como mobiliario de la página y se cortan.
Mira qué contiene el registro
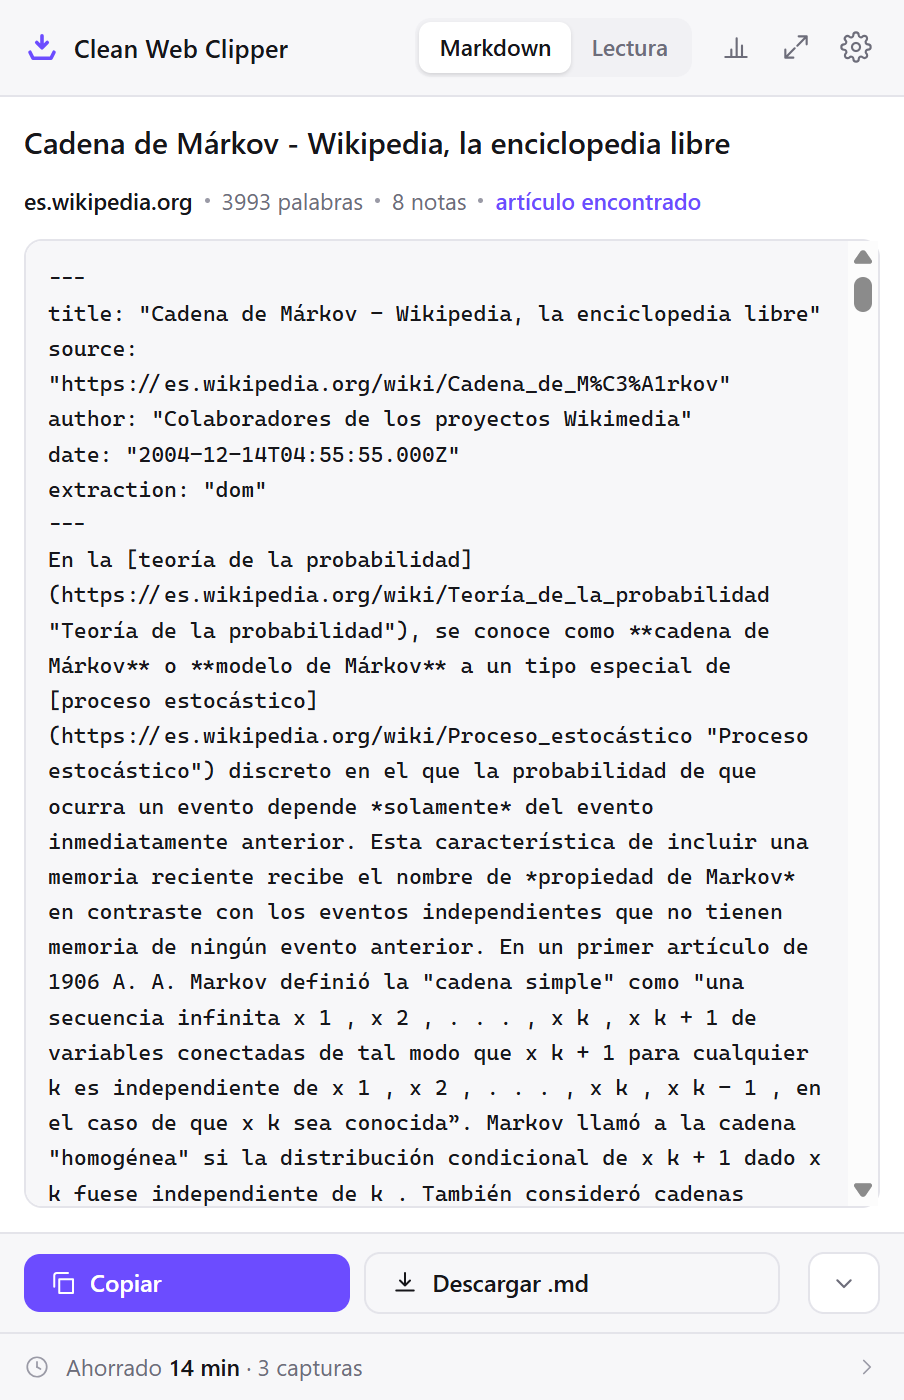
- La fecha de publicación se lee de los metadatos de la página, no del texto ni del día de la captura
- La dirección de origen queda en el frontmatter de cada archivo
- El texto completo del artículo, sin la navegación ni los bloques promocionales que cambian entre visitas
- Archivos normales: sin formato propietario, sin cuenta, sin un servicio que pueda revocarte el acceso
- El campo
extractionregistra cómo se obtuvo el texto, así que la nota es auditable - En Reddit los comentarios se capturan como hilo compacto, con la puntuación de cada uno
dateModifiedse descarta a propósito: una edición posterior no es la fecha en que se publicó la pieza- La captura tarda decenas de milisegundos, así que se hace mientras lees y no «cuando tenga un momento»
published: "2024-03-21T18:42:00+01:00"

  article:published_time    2024-03-21T18:42:00+01:00   ← el que se usa
  JSON-LD datePublished     2024-03-21
  JSON-LD dateModified      2024-06-02   (edición posterior, no es la fecha)
  time[datetime]            2025-08-31   (fecha de visita, descartada)
Archiva una fuente en dos segundos
Lo que decide si una fuente queda archivada no es la calidad de la herramienta, sino que capturar cueste menos que dudar. Estos seis pasos dejan el gesto en una tecla.
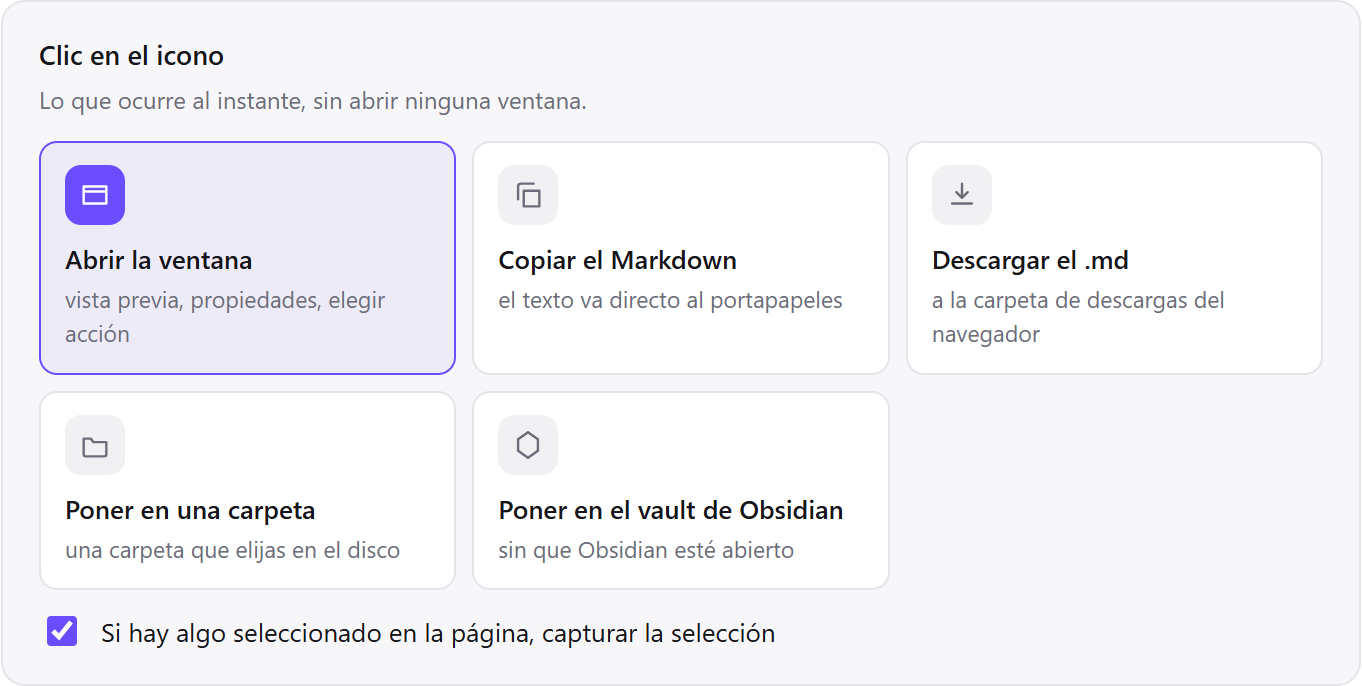
- En los ajustes, pon el clic en el icono en «carpeta». Sin ventana intermedia, capturar deja de ser una decisión: se hace mientras lees, que es el único momento en que la página todavía dice lo que decía.
- Elige como destino una carpeta de trabajo y escribe la subcarpeta del tema que estés cubriendo. Cambiar de tema es cambiar una línea de texto en los ajustes, no volver a dar permiso sobre la carpeta.
- Pon la plantilla de nombre en
{date}-{domain}-{title}. El{date}del nombre es el día de la captura; la fecha de publicación vive aparte en el campopublished, así que en un archivo siempre se ve a la vez cuándo se publicó y cuándo lo guardaste. - Deja activos los cinco campos del frontmatter.
extractiones el que convierte la copia en algo auditable: dice si el texto salió del DOM que el navegador mostró o de los datos estructurados de la página. - Comprueba Alt+Shift+M en
chrome://extensions/shortcuts. Con el clic puesto en «carpeta», el atajo archiva sin apartar la vista de la página: es la diferencia entre archivar veinte fuentes en una jornada y archivar tres. - Cuando la fuente sea un hilo de Reddit, despliega antes los comentarios que te interesen. Se captura lo que hay en la página en ese momento, y los hilos plegados no están en la página.
Elige los ajustes para un archivo de fuentes
La configuración de abajo prioriza dos cosas por encima de todo: que capturar sea instantáneo y que el archivo diga por sí solo de dónde salió cada cosa y cuándo.
| Ajuste | Valor | Por qué así para archivar fuentes |
|---|---|---|
| Clic en el icono | Carpeta | Archivar tiene que costar menos que decidir si archivar; una ventana de por medio ya es demasiado |
| Subcarpeta | El tema que cubres | Un tema se revisa entero cuando salta; repartido entre carpetas, no se revisa |
| Plantilla de nombre | {date}-{domain}-{title} | La fecha de captura y el medio en el nombre reconstruyen la cronología sin abrir un solo archivo |
| Frontmatter | Los cinco campos | published sostiene la cronología y extraction hace la copia auditable |
| Imágenes | Enlace | Un gráfico o una fotografía citada queda localizable; los archivos binarios no se descargan |
| Atajo de teclado | Alt+Shift+M | Permite archivar sin apartar la vista, que es lo que hace posible veinte capturas en una jornada |
| Regla por sitio | Fuentes oficiales → subcarpeta aparte | Separar la fuente primaria de la reacción evita atribuir a una lo que dijo la otra |
---
title: "Corte de suministro en el polígono: qué se sabe"
source: "https://www.reddit.com/r/es/comments/1f2k8xq/"
published: "2025-04-22"
extraction: "dom"
---

- **[+412] vecino_del_9** – Llevamos desde las 6:40 sin luz en toda la
  calle. La compañía dice que es una avería en el centro de transformación.
  - **[+88] a_pie_de_obra** – Confirmado, hay dos camiones trabajando
    en la esquina desde las 8:15.
  - **[+12] pasaba_por_aqui** – En el polígono de al lado no hay corte.
- **[+37] turno_de_noche** – Aviso oficial publicado a las 9:02.

Los comentarios llegan como hilo compacto con su puntuación. Fuera de
Reddit los comentarios se tratan como mobiliario de la página y se cortan.
Mira tres capturas de fuentes
Las tres capturas de abajo muestran lo que un archivo con fecha le da a quien informa: una nota de prensa que va a cambiar antes de que acabe el día, un hilo de foro guardado como fuente y no como captura de pantalla, y la prueba de qué decía una página aquel día. Las tres dependen de capturar antes de que nadie tenga motivo para cambiar nada.
Una nota de prensa que va a cambiar
Un organismo publica una nota y sabes por experiencia que la versión de mañana no será la de hoy: se corrigen cifras, se retira un párrafo, se sustituye el archivo en la misma dirección. Pulsas Alt+Shift+M nada más leerla. Dos segundos, sin salir de la página.
Lo que queda en la carpeta del tema es el texto completo con la fecha de publicación leída de los metadatos de la propia página, no del día de la captura. Cuando la versión cambie, capturas otra vez: como el nombre coincide, la segunda recibe un sufijo numérico y la primera queda intacta para comparar.
Un hilo como fuente
La primera señal de una historia aparece en un hilo, entre doscientos comentarios y con la mitad plegados. Despliegas lo que te interesa y capturas: se guarda un hilo compacto con la puntuación de cada intervención, que es lo que después permite decir cuánta gente lo respaldaba.
Ese material desaparece con facilidad: una cuenta borrada se lleva sus mensajes por delante. Tu copia es un archivo de texto en tu disco y no depende de que la plataforma siga sirviendo el hilo, aunque no sustituye a un archivo web ni certifica nada ante un tercero.
Demostrar qué decía la página aquel día
Publicas apoyándote en una página y semanas después alguien discute la cita. El enlace ya no ayuda: lleva al texto de hoy. Abres tus dos capturas de la misma dirección y las comparas con cualquier herramienta de comparación de texto, línea por línea.
Lo que aporta la extensión aquí es solo que las dos copias sean comparables: no vigila páginas, no avisa de cambios y no compara nada por su cuenta. Y conviene decirlo entero: es tu copia fechada, no una prueba certificada; para eso hace falta un tercero autorizado.
Compara con las otras formas de archivar una página
En este oficio conviven varias vías y cada una cubre algo distinto. La última fila es esta extensión, con lo que no hace dicho igual de claro.
| Cómo se hace ahora | Qué obtienes | Qué cuesta |
|---|---|---|
| Servicio de archivo web | Un registro visual con sello de un tercero | Depende de que ese servicio siga en pie y llegue a la página; muchas páginas con sesión o con muro no se archivan |
| Imprimir a PDF | La página tal como se veía, en un archivo | Arrastra menú, publicidad y aviso de cookies; no se busca bien y no lleva dentro la fecha real de publicación |
| Captura de pantalla | Inmediata y visual | No se busca por palabra, no se compara con la versión siguiente y un artículo largo son quince imágenes |
| Copiar y pegar | El texto, ya | Se pierden la fecha de publicación y la dirección, que es justo lo que hay que sostener después |
| Marcador | Un índice de lo leído | Cuando la página se edita o el medio rehace su web, no prueba nada |
| Clean Web Clipper | El texto completo con fecha de publicación y dirección, en tu disco, en dos segundos | No guarda la maquetación ni hace capturas de pantalla, no sella ni certifica, y fuera de Reddit no captura comentarios |
¿Qué hacer cuando la captura no es la que esperabas?
Cuando una captura de Clean Web Clipper no es la que esperabas, suele ser por una de cuatro causas: un directo que seguía añadiendo entradas, una portada rechazada porque es casi toda enlaces, una nota oficial sin fecha en sus metadatos o comentarios cortados como mobiliario de la página fuera de Reddit. Cada una se comprueba contra lo que muestra la página.
¿Por qué un directo sale incompleto?
Porque un directo no termina de existir. Las entradas se añaden mientras lees y muchas se cargan al desplazarse, así que la captura contiene lo que había en la página en el instante en que pulsaste. Baja hasta donde te interese antes de capturar, y si el directo dura horas, captura varias veces: cada archivo recibe un sufijo numérico y entre todos queda la cronología.
¿Por qué una portada dice «sin artículo»?
Porque no lo hay. La extensión revisa el Markdown terminado y, si más de una cuarta parte del texto está dentro de etiquetas de enlace, se niega en lugar de entregar trescientos titulares con aspecto de contenido. Las portadas, las páginas de sección y los resultados de búsqueda caen ahí siempre. Entra en la pieza concreta y captura ahí.
¿Por qué está vacía la fecha de una nota oficial?
Porque esa página no la declara en sus metadatos. Se buscan JSON-LD datePublished, article:published_time, citation_date, time[datetime] y marcas de tiempo Unix, y en muchos sitios institucionales la fecha solo aparece impresa dentro del texto, donde no se puede leer con seguridad.
Rellenarla con el día de la captura sería inventar un dato. Lo que sí queda registrado es cuándo lo archivaste tú, en el {date} del nombre del archivo, y ese es un dato distinto que no se confunde con el otro.
¿Por qué no aparecen los comentarios?
Porque solo se capturan en Reddit. En el resto de los sitios los comentarios se tratan como mobiliario de la página y se cortan junto con la navegación y los bloques promocionales. Cuando el hilo de comentarios es la fuente y no el adorno, la vía es capturar la selección: marca en la página los mensajes que importan y captura solo eso, con el frontmatter completo.
¿Qué no es Clean Web Clipper?
Clean Web Clipper no sustituye a un archivo web: guarda el texto, no la página tal como se veía, sin maquetación, capturas de pantalla ni recursos descargados. No sella ni firma nada: es tu copia, no una prueba certificada. No captura los comentarios fuera de Reddit, porque en el resto de sitios son mobiliario de la página. Y en una portada dirá que no hay artículo, porque ahí no lo hay.
Comprueba qué registra una captura como constancia
¿Sustituye a un archivo web?
¿Captura los comentarios?
¿Puede registrar cuándo lo capturé?
{date}, que es la fecha de la captura. La fecha de publicación es un campo aparte del frontmatter, así que las dos nunca se confunden.¿Y si la página no declara fecha?
¿Sirve para páginas en otros idiomas?
Consulta velocidad, suscripciones y fragmentos
¿Cuánto tarda una captura?
¿Se puede archivar una página que solo veo con mi suscripción?
¿Queda constancia de cómo se obtuvo el texto?
extraction. dom significa que el texto salió de lo que el navegador mostró de verdad; jsonld-articlebody, que la página nunca terminó de renderizarse y el cuerpo se leyó de sus datos estructurados.