Para quién es · ·
Guarda la letra de una norma, literal
Clean Web Clipper copia una norma, unas condiciones o una guía administrativa palabra por palabra, con la dirección de origen y la fecha que declaraba la página, en un archivo Markdown que controlas tú. Los textos cambian sin aviso; la captura deja constancia de lo que decían el día que los leíste.
De dónde salen estas cifras: la medición, con las versiones de los motores y las fechas
¿Qué pasa cuando la redacción misma es el hecho?
Una condición general se actualiza y la anterior desaparece de la web. Una guía de la administración se sustituye por otra con la misma dirección y sin número de versión. Cuando hay que sostener qué decía el texto en la fecha del contrato, el enlace lleva a la redacción de hoy y la anterior hay que reconstruirla, si es que se puede.
La otra pérdida es de estructura. Las tablas de tasas, plazos y umbrales son la mitad del contenido útil de una norma, y son lo primero que se rompe al copiar y pegar. Las notas al pie se convierten en anclas muertas, la numeración de apartados se desordena y el documento deja de servir como referencia.
El tercer problema es de fechas. Un texto consolidado incorpora cada modificación sin decir siempre desde cuándo rige la redacción que tienes delante, y la fecha que muestra la página suele ser la de la última actualización del registro. Por eso la fecha de publicación se lee de los metadatos y dateModified se descarta a propósito, y por eso el día en que capturaste vive aparte, en el nombre del archivo: son dos datos distintos y confundirlos es exactamente el error que hay que evitar.
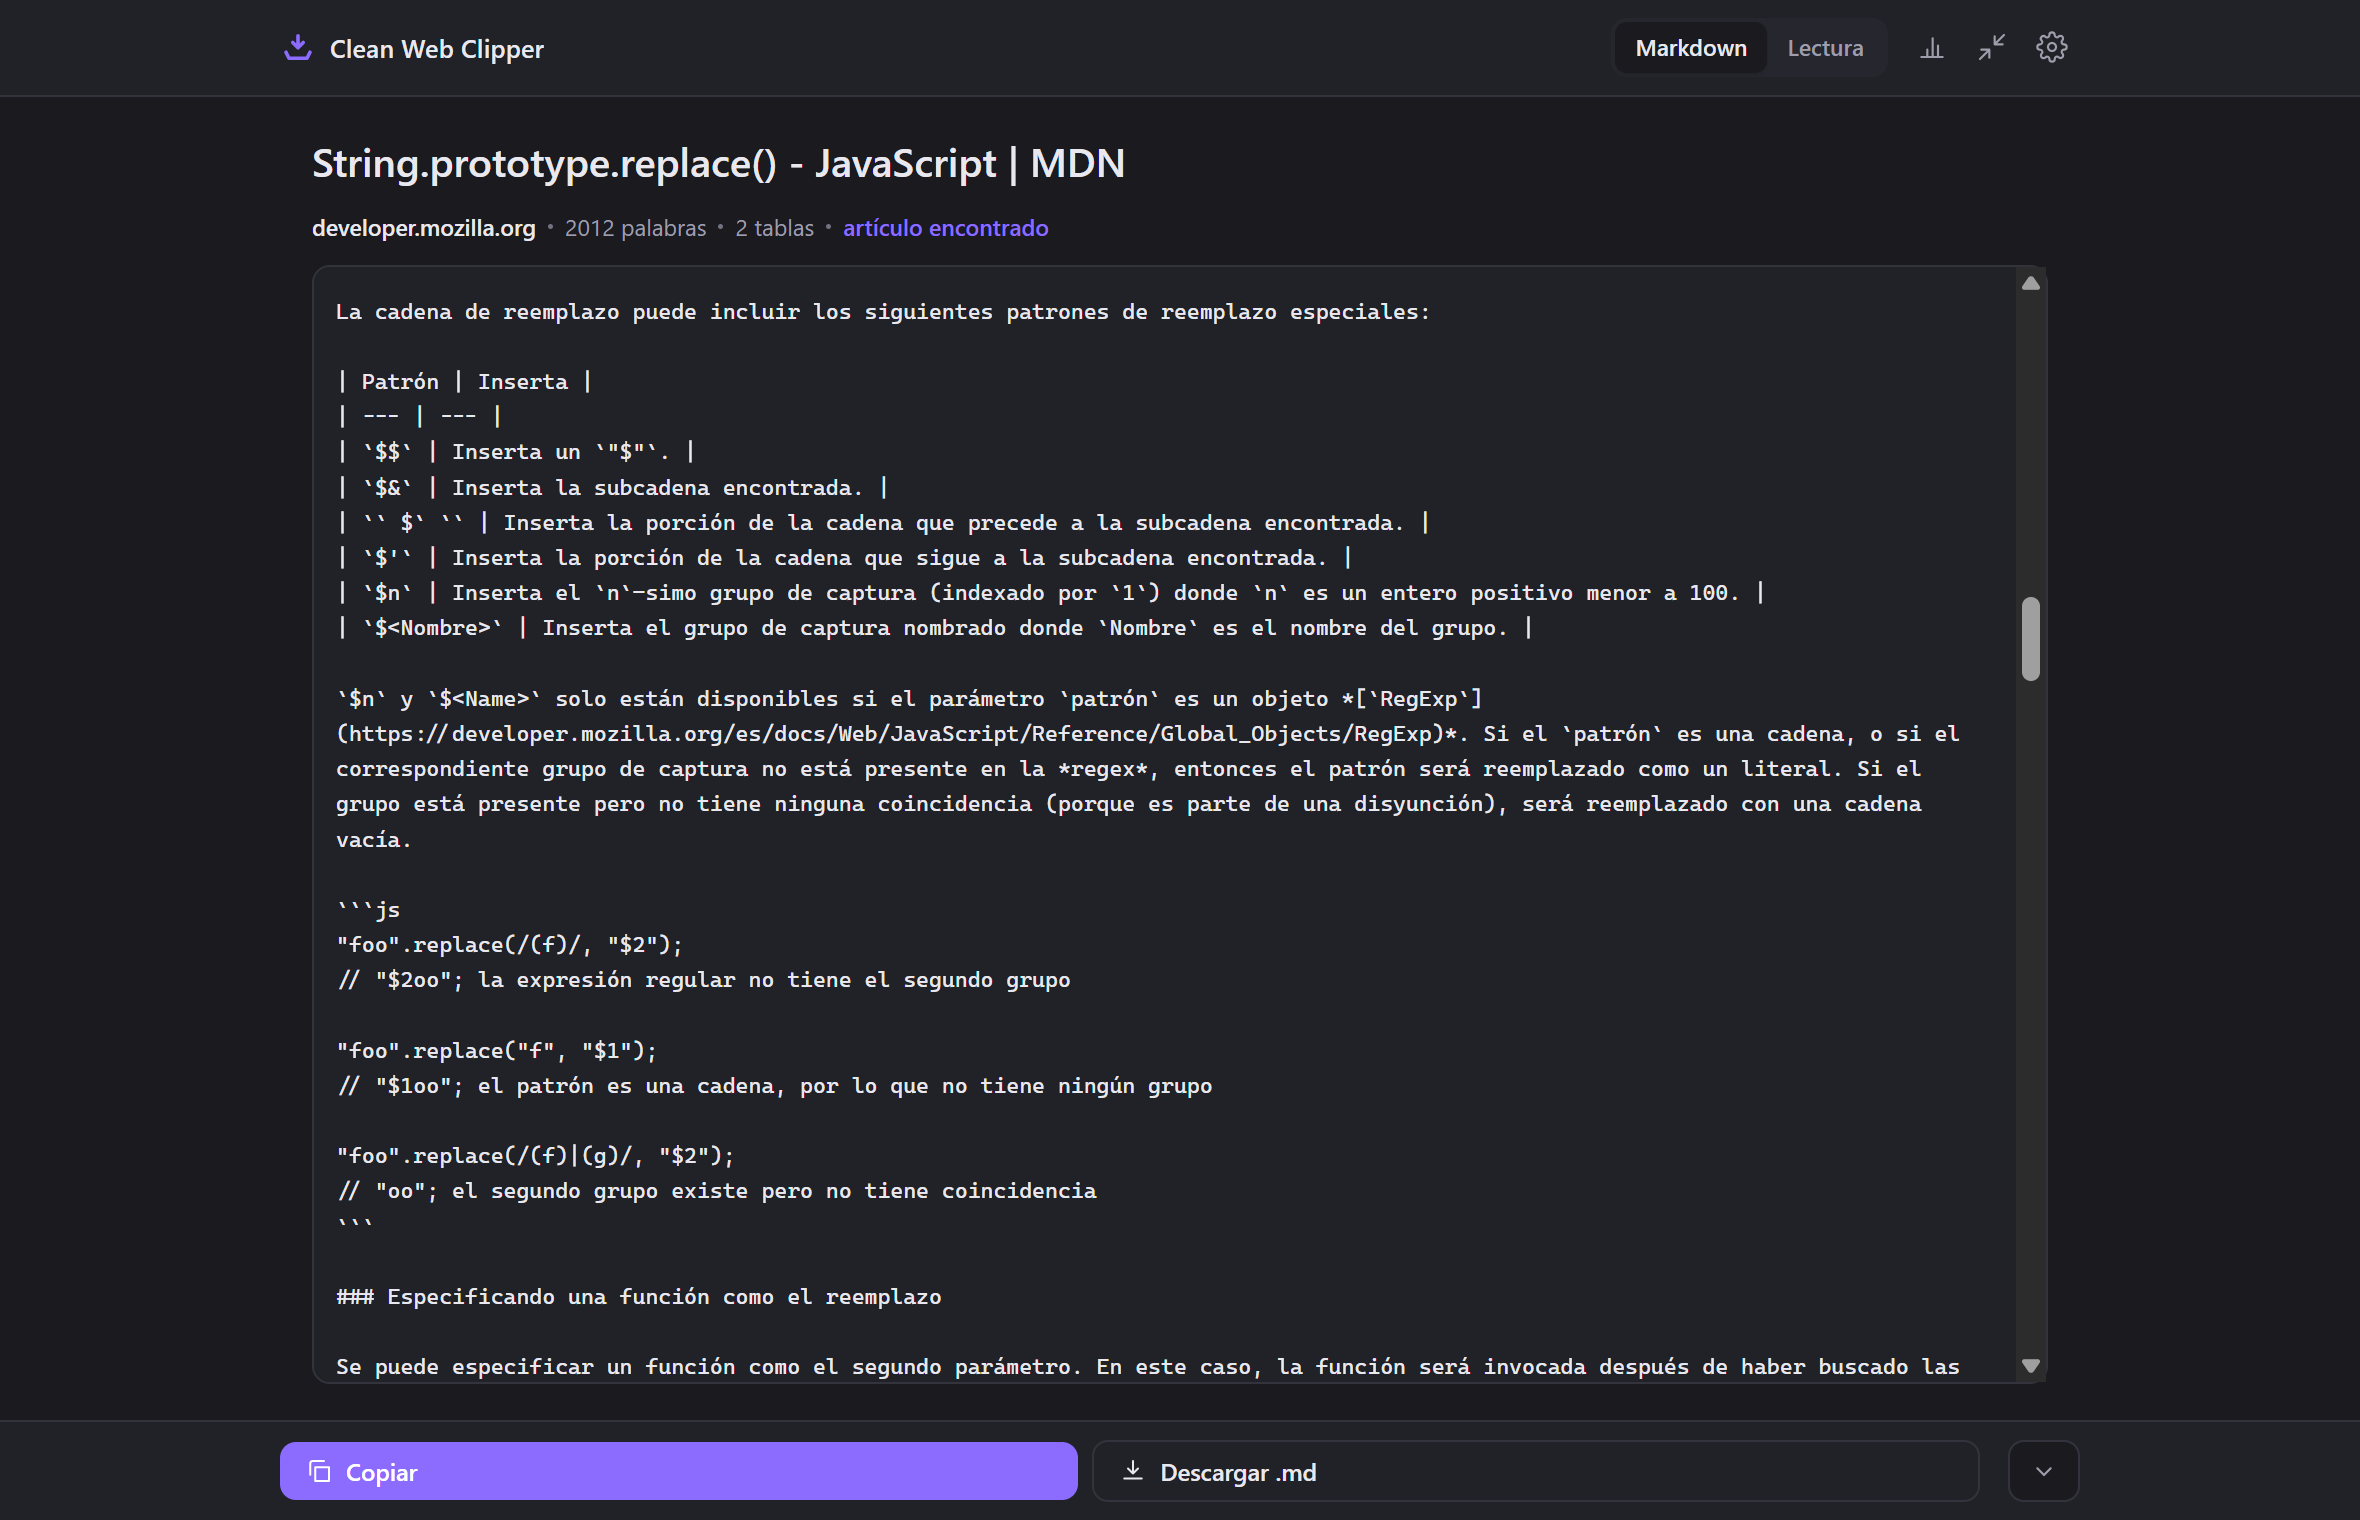
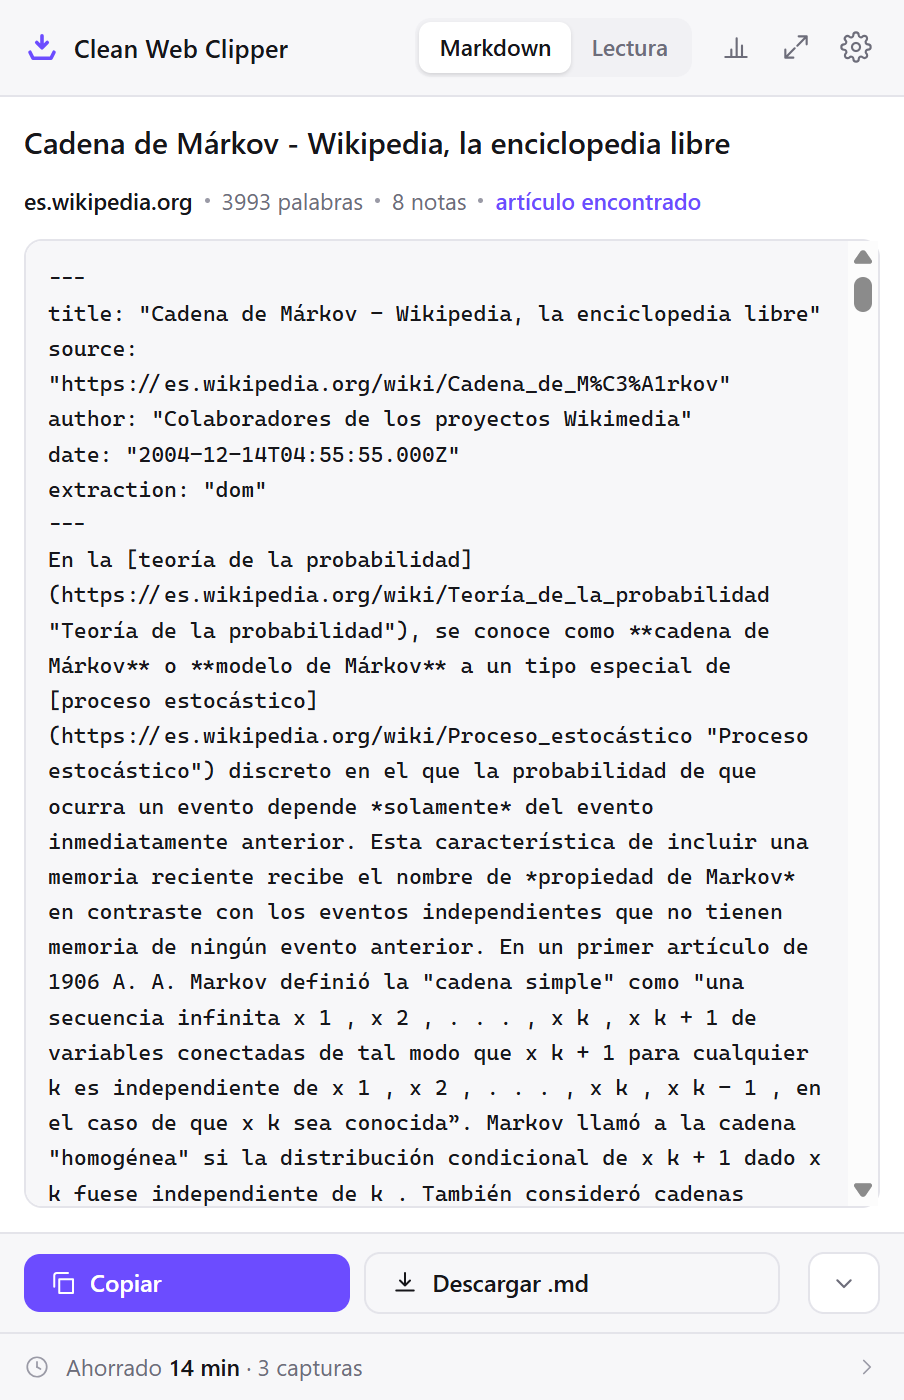
Mira qué sobrevive a la conversión
- Texto literal: no se resume, no se reescribe y no se reordena nada dentro del cuerpo
- Dirección de origen y fecha de publicación en el frontmatter de cada archivo
- Las tablas de tasas, plazos y umbrales sobreviven enteras a la conversión
- Las notas al pie y los enlaces de referencia se conservan en vez de aplanarse
- La numeración de artículos y apartados se mantiene como lista o como texto, no se renumera
- Los archivos se guardan donde tú decidas, sin ningún tercero por el camino
- El campo
extractiondeja escrito si el texto salió del DOM renderizado o de los datos estructurados de la página - Una segunda captura de la misma dirección recibe un sufijo numérico: la redacción anterior no se pisa nunca
## Artículo 5. Deber de confidencialidad.

1. Los responsables y encargados del tratamiento de datos así como todas
las personas que intervengan en cualquier fase de este estarán sujetas al
deber de confidencialidad al que se refiere el artículo 5.1.f) del
Reglamento (UE) 2016/679.

2. La obligación general señalada en el apartado anterior será
complementaria de los deberes de secreto profesional de conformidad con
su normativa aplicable.

3. Las obligaciones establecidas en los apartados anteriores se
mantendrán aun cuando hubiese finalizado la relación del obligado con el
responsable o encargado del tratamiento.
Guarda una norma paso a paso
Lo que sostiene un expediente no es la captura, sino que dentro de dos años se pueda decir qué decía el texto y cuándo lo leíste. Estos seis pasos dejan esas dos cosas escritas en cada archivo.
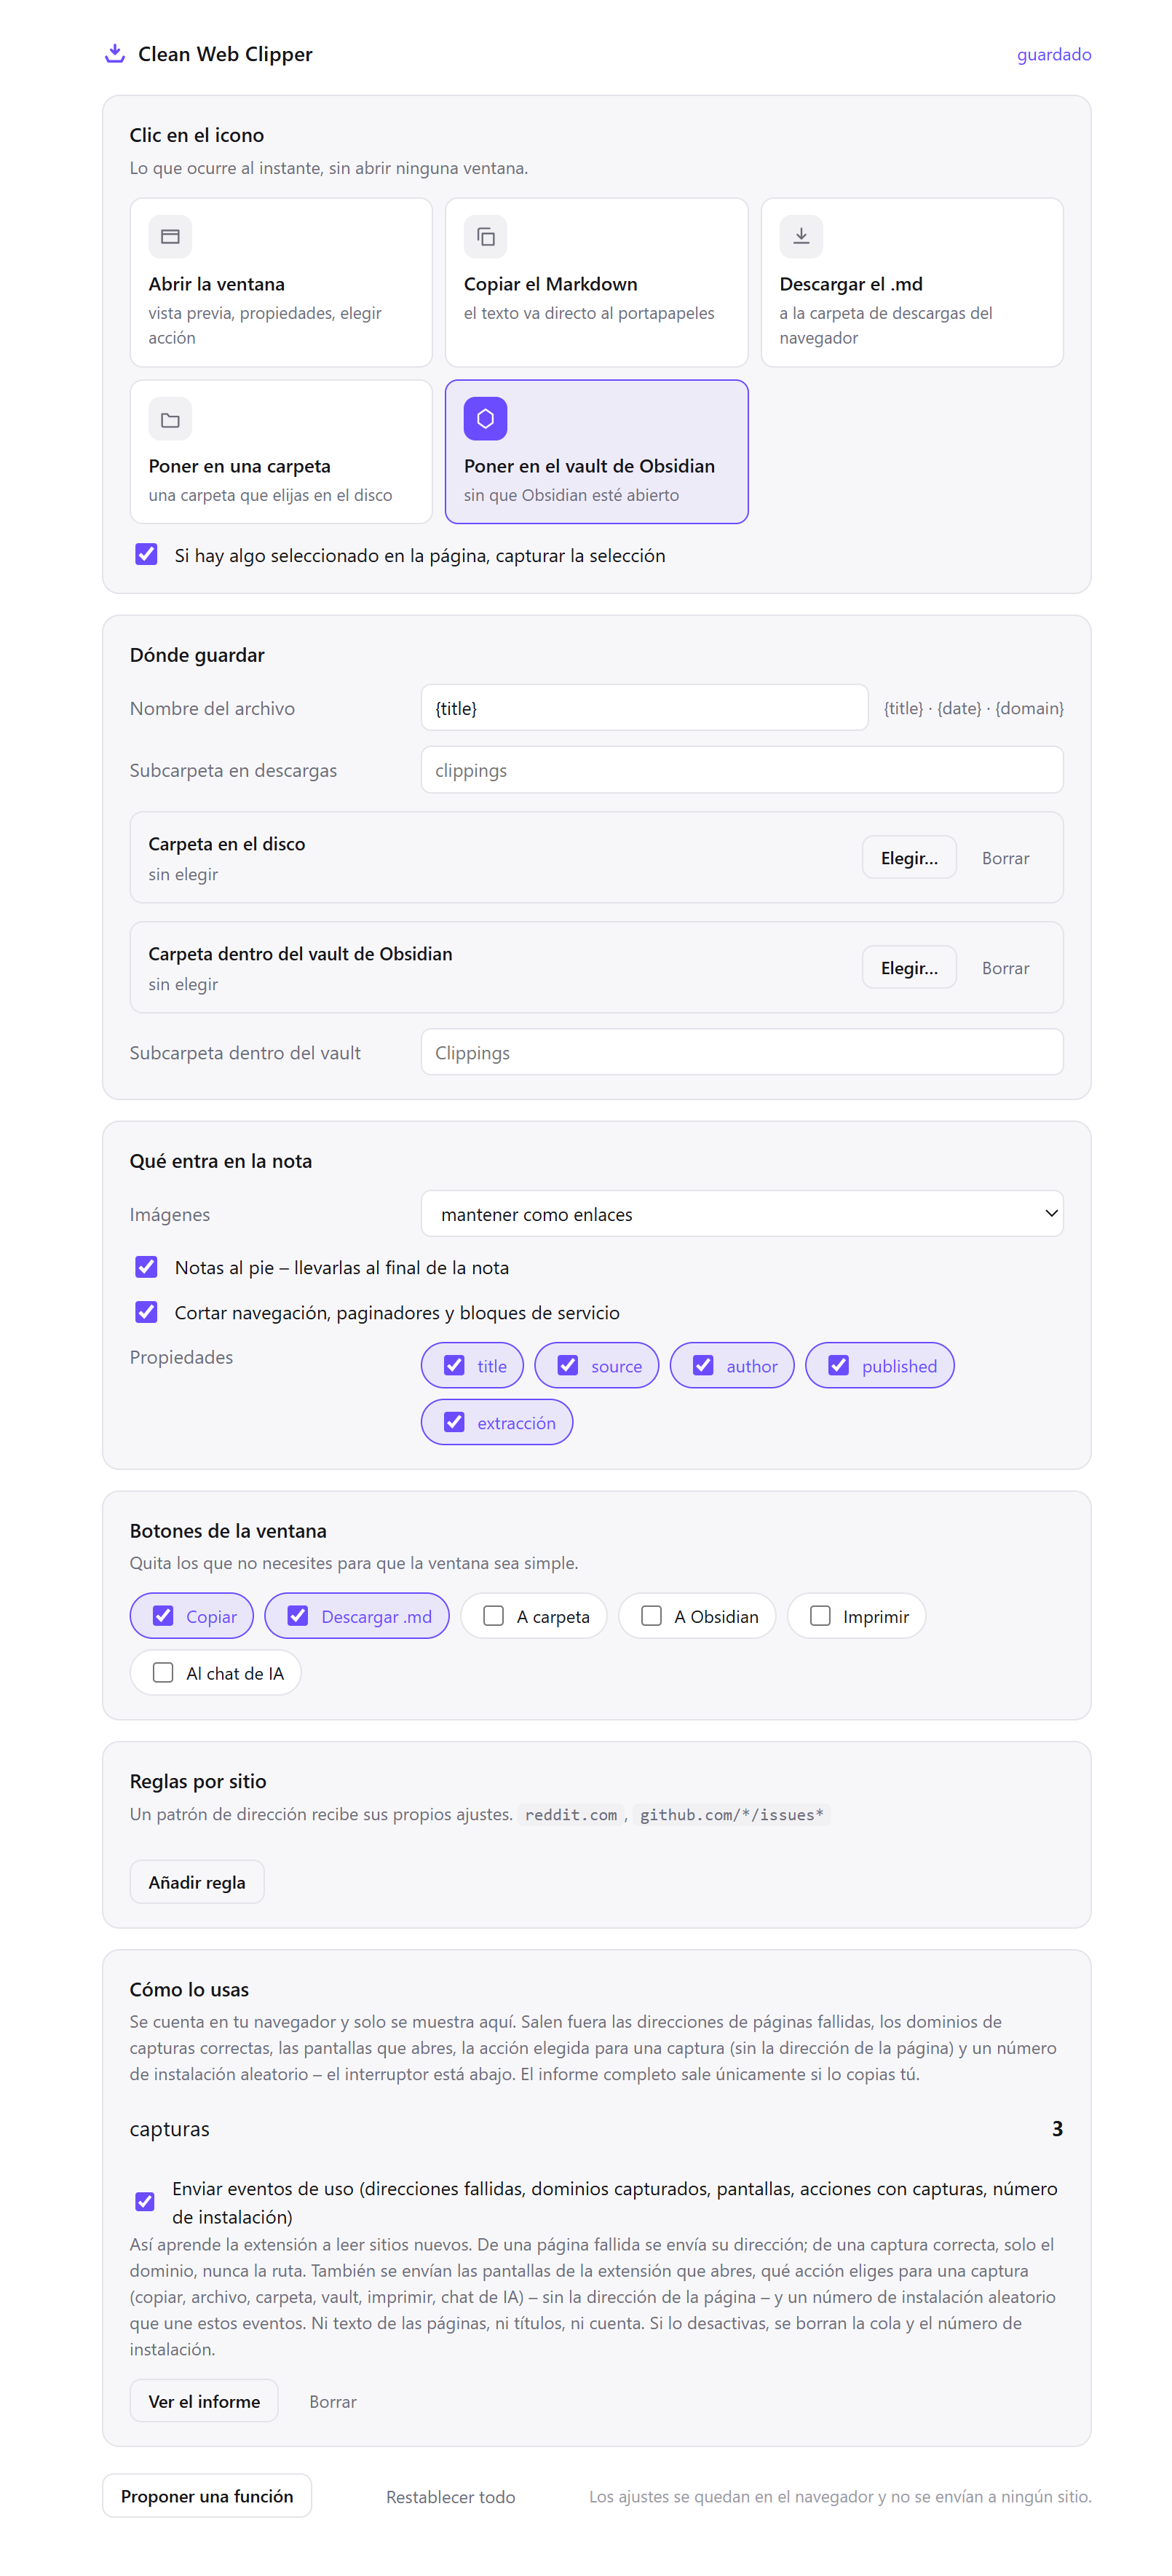
- En los ajustes, deja el clic en el icono en «vista previa». En material normativo conviene mirar antes de archivar: es el momento de comprobar que las tablas de plazos y de tasas llegaron enteras.
- Elige como carpeta de destino la del asunto y escribe la subcarpeta con su referencia. Un expediente se revisa entero; repartido entre carpetas generales, no se revisa.
- Pon la plantilla de nombre en
{date}-{title}. Ese{date}es el día de la captura, y es el dato que dice desde cuándo puedes afirmar que el texto decía lo que dice tu copia. - Deja activos los cinco campos del frontmatter.
publishedrecoge la fecha que declara la página yextractiondeja constancia de por qué vía se obtuvo el cuerpo: los dos juntos son lo que hace la copia auditable. - Captura la versión HTML del texto, no la ficha del registro ni el visor de PDF. En un boletín oficial, el texto consolidado en HTML es lo que se convierte; del PDF oficial, lo que corresponde es descargarlo con el botón del propio sitio.
- Cuando el texto cambie, captura otra vez la misma dirección. El sufijo numérico conserva la redacción anterior, y a partir de ahí comparar dos versiones es comparar dos archivos de texto con cualquier herramienta.
Elige los ajustes para material normativo
Los valores de abajo están elegidos por una razón concreta: que la copia sirva para trabajar y para sostener después qué decía el texto. La diferencia con otros usos está en las fechas y en el nombre del archivo.
| Ajuste | Valor | Por qué así en trabajo jurídico |
|---|---|---|
| Clic en el icono | Vista previa | Es el único momento barato para ver si una tabla de plazos o de umbrales llegó entera |
| Carpeta y subcarpeta | Carpeta del asunto → referencia del expediente | Un expediente se consulta entero; lo que está fuera de él no se encuentra cuando hace falta |
| Plantilla de nombre | {date}-{title} | La fecha de captura es lo que fecha tu copia; la de publicación va aparte, en published, y no se mezclan |
| Frontmatter | Los cinco campos | published y extraction son lo que convierte un texto guardado en una copia auditable |
| Imágenes | Omitir | En normativa las imágenes son membretes y sellos; como no se descargan, solo dejarían enlaces que caducan |
| Regla por sitio | Boletín oficial → subcarpeta propia | Separar la fuente oficial de comentarios y notas de despacho evita citar uno por otro |
| Segunda captura | Misma dirección, sufijo automático | Es lo que permite comparar redacciones sin llevar un control de versiones a mano |
## Disposición adicional segunda. Plazos y cuantías.

| Trámite | Plazo máximo | Cuantía |
| --- | --- | --- |
| Solicitud inicial | 3 meses desde el hecho causante | 42,50 euros |
| Subsanación | 10 días hábiles | Sin coste |
| Recurso de alzada | 1 mes desde la notificación | 22,00 euros |
| Revisión de oficio | 4 años | Sin coste |

Los plazos señalados en días se entenderán referidos a días hábiles.[^1]

[^1]: La definición de la nota queda al final del archivo, no como un
      ancla que apunta a una página que puede haber cambiado.

La tabla la escribe la propia extensión y no un conversor genérico: una
celda con una lista o con una referencia dentro ya no parte la fila.
Mira tres usos en un despacho
Los tres asuntos de abajo usan el mismo método: las condiciones vigentes el día en que se firmó un contrato, un solo artículo extraído de una norma larga y una guía administrativa que se sustituye sin aviso por otra con la misma dirección. En los tres, la captura anterior es lo que permite comparar meses o años después.
Las condiciones vigentes el día del contrato
Vas a firmar apoyándote en las condiciones generales publicadas por la otra parte. Las abres en el navegador y las capturas antes de nada. El archivo cae en la carpeta del asunto con la fecha de la captura en el nombre y la fecha declarada por la página en published.
Seis meses después las condiciones se actualizan y la redacción anterior desaparece de la web. Tu copia sigue diciendo, palabra por palabra, qué decía el texto el día de la firma, y con la dirección de la que salió. Dentro del cuerpo no se ha añadido, quitado ni reordenado nada: solo el HTML se convirtió en Markdown.
Un solo artículo de una norma larga
Necesitas el artículo 5 de una ley de doscientas páginas, no la ley entera. Lo seleccionas en la página y capturas la selección: se guarda ese artículo con el frontmatter completo, incluidas la dirección y la fecha de la norma.
La numeración de apartados se conserva como aparece –lista o texto, según cómo la maquete la fuente– y no se renumera. Eso importa más de lo que parece: un apartado renumerado en una cita es un error que nadie detecta hasta que alguien va a comprobarlo.
Una guía administrativa que se sustituye sin aviso
Los criterios de un organismo cambian y la guía nueva ocupa la misma dirección, sin número de versión. Como capturaste la anterior, la segunda captura recibe un sufijo numérico y las dos conviven en la carpeta.
Comparar dos archivos de texto enseña qué párrafos se movieron, cuáles desaparecieron y qué umbral cambió. La extensión no vigila la página ni avisa de nada: lo que aporta es que las dos copias sean comparables línea por línea, y que cada una lleve dentro de dónde salió.
Compara con las otras formas de conservar un texto
Cada vía cubre una necesidad distinta y ninguna las cubre todas. La última fila es esta extensión, con sus límites dichos sin rodeos.
| Cómo se hace ahora | Qué obtienes | Qué cuesta |
|---|---|---|
| Descargar el PDF oficial | El documento tal como lo publica el organismo, paginado | No se busca ni se compara bien entre versiones, y hay textos consolidados que solo existen en HTML |
| Imprimir la página a PDF | Un archivo inmediato con la maquetación | Arrastra menús y avisos, corta las tablas anchas y no lleva dentro la fecha de publicación |
| Copiar y pegar al expediente | El texto donde ya trabajas | Las tablas de plazos y umbrales se deshacen, las notas quedan como anclas muertas y se pierde la dirección |
| Captura de pantalla | Prueba visual de lo que se veía | No se busca por palabra ni se compara con la redacción siguiente; una norma larga son cuarenta imágenes |
| Acta notarial o servicio de archivo | Constancia con fe pública o sello de un tercero | Cuesta tiempo y dinero, y no encaja para las decenas de textos que se consultan a diario |
| Clean Web Clipper | El texto literal con dirección, fecha y tablas enteras, en tu carpeta | No certifica ni sella nada, no es asesoramiento, no descarga el PDF ni entra en un expediente electrónico |
¿Qué hacer cuando el texto no llega entero?
Cuando una norma capturada con Clean Web Clipper no llega entera, suele ser por una de cuatro causas: una tabla de tasas maquetada con celdas combinadas, un boletín publicado solo en PDF, una numeración de apartados que dibuja la hoja de estilos y no el texto, o una sede electrónica que carga el contenido tras iniciar sesión. Cada caso se explica abajo.
¿Por qué se ha roto una tabla de tasas?
Casi siempre porque lleva celdas combinadas. Markdown no sabe expresarlas: el contenido se conserva, pero la combinación visual se pierde y la fila puede leerse desplazada. Las tablas irregulares de dos columnas se convierten en líneas Clave: valor, que es más legible que una rejilla rota. En el corpus técnico sobrevivieron doce tablas de quince, frente a siete de cada motor comparado: es bueno, no es perfecto.
¿Por qué no captura el PDF del boletín?
Porque en el visor de PDF no hay página HTML que convertir. La extensión trabaja sobre el DOM de una página web y un PDF abierto en el visor del navegador no lo es. Usa el botón de descarga del propio sitio: en ese caso ya tienes el documento oficial, que es mejor prueba que cualquier conversión. Para el texto consolidado, captura su versión HTML.
¿Por qué la numeración de apartados se ve distinta?
Porque depende de cómo la maquete la fuente. Si el sitio publica los apartados como lista numerada, llegan como lista; si los publica como texto con el número escrito dentro del párrafo, llegan como texto. Lo que no ocurre en ningún caso es que se renumeren: la extensión no reordena nada dentro del cuerpo.
Si necesitas la numeración exactamente como se ve en pantalla, la vista de lectura muestra el resultado antes de guardar y ahí se comprueba en un vistazo. Las tablas de maquetación muy anidadas siguen siendo difíciles para cualquier herramienta, incluida esta.
¿Por qué falta el contenido de una sede electrónica?
Porque muchas sedes muestran el documento dentro de un marco o lo generan tras varios pasos de un formulario, y lo que la extensión lee es la página exterior. Abre el documento en su propia pestaña y captura ahí. Y si lo que hay dentro del marco es un PDF, lo que corresponde es descargarlo. En las páginas que el navegador protege, como chrome://, la extensión no se ejecuta en absoluto.
¿Qué no afirma Clean Web Clipper?
Clean Web Clipper no es asesoramiento ni interpreta nada: convierte una página a texto y ahí termina. No certifica ni sella la captura, así que no equivale a un acta notarial ni a una prueba preconstituida. No descarga el PDF de un boletín oficial ni entra en un expediente electrónico; captura la página HTML que estás viendo. Y las tablas de maquetación muy anidadas siguen siendo difíciles para cualquier herramienta, incluida esta.
Comprueba si el texto llega exacto
¿Se modifica el texto de alguna forma?
¿Sobreviven las tablas complejas?
¿Dónde se guardan los archivos?
¿Vale como prueba?
¿Puedo capturar solo un artículo de la norma?
Consulta fechas, comparaciones y confidencialidad
¿Cómo distingo la fecha del texto de la fecha en que lo guardé?
published del frontmatter y sale de los metadatos de la página; la de la captura está en el nombre del archivo si usas {date} en la plantilla.¿Se puede comparar la redacción de hoy con la de hace un año?
¿Queda registro de cómo se obtuvo el texto?
extraction. dom significa que el texto salió de lo que el navegador mostró; jsonld-articlebody, que la página no terminó de renderizarse y el cuerpo se leyó de sus datos estructurados. En material normativo conviene revisar los segundos.