Кому это · ·
Сохранить веб-страницу навсегда – простым текстом у себя
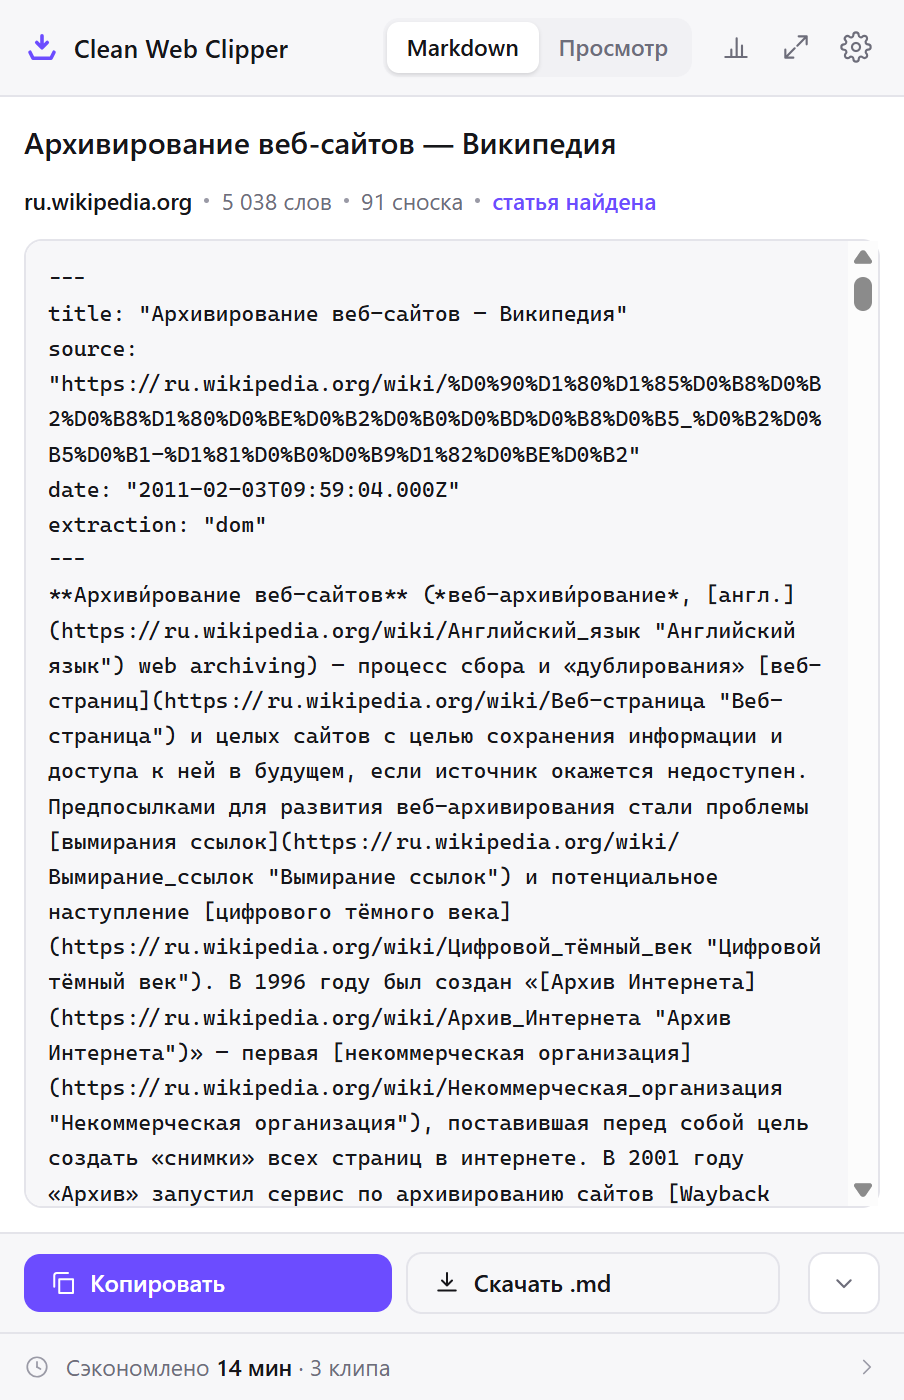
Закладка не поможет сохранить веб-страницу навсегда: она ведёт на страницу, которая меняется или пропадает, а сам текст не хранит. Clean Web Clipper записывает клип простым текстом с YAML-фронтматтером туда, куда вы решили, – у такого файла нет ни владельца, ни срока годности. Когда файл записан, от расширения больше ничего не зависит.
Откуда эти цифры: страница замера с версиями движков и датами
Во что превращается коллекция ссылок?
Собрание ссылок стареет плохо. Страницы переносят, склеивают и снимают, домены не продлевают, а те сайты, что остались, переписывают адреса при каждом редизайне. Через несколько лет заметная часть закладок не ведёт никуда, и никто вас об этом не предупредит: вы узнаёте в тот день, когда ищете именно эту страницу.
Сервисы отложенного чтения переносят проблему, а не решают. Текст вроде бы есть, но в формате, который вам не подчиняется, за аккаунтом, на сервисе, который может закрыться, сменить владельца или увести вашу библиотеку за лимит. Экспорт бывает не всегда, полным – редко, и подумать о нём надо до объявления о закрытии.
Восстановить пропавшее задним числом получается реже, чем принято думать. Публичные веб-архивы обходят сайты выборочно: до глубокой страницы робот доходит не всегда, за логин и пейволл не проходит вовсе, а свежую правку ловит через раз. Поисковый кэш живёт неделями. В итоге страница, за которой вы возвращаетесь, чаще всего не сохранилась нигде – и узнаёте вы об этом в тот единственный день, когда она понадобилась.
Что гарантирует обычный файл?
- Открытый и долговечный формат – простой текст с YAML-фронтматтером, без остатков HTML на 512 замеренных страницах
- Ни аккаунта, ни загрузки: склипанный текст остаётся у вас
- Дата публикации и адрес источника сохраняются вместе с текстом
- Читается офлайн, без срока, в любом редакторе
- Поле
extractionфиксирует, каким путём получена каждая заметка - Никакого потолка по числу клипов: ни квоты, ни срока действия
- Имя файла собирается из даты, домена и заголовка – папка остаётся навигируемой без единого инструмента
- Настройки лежат в браузере и никуда не отправляются, учётной записи нет; на наш сервер статистики уходят только события использования, и их останавливает один переключатель в настройках
---
title: "Как искать документы в архивах"
source: "https://rusarchives.ru/state/poisk"
published: "2021-02-15"
extraction: "dom"
---

Описи, переведённые в электронный вид, ищут по фондообразователю, по шифру
или по периоду – смотря что о документе уже известно.
Как собрать архив, переживающий инструменты
Архив держится не на инструменте, а на том, что после записи от инструмента ничего не зависит. Настройка ниже нужна ровно для этого – и делается один раз.
- Заведите папку архива внутри того каталога, который у вас уже попадает в резервную копию. Отдельная папка вне копии – самая частая причина потерять архив целиком, и обнаруживается она в неудачный момент.
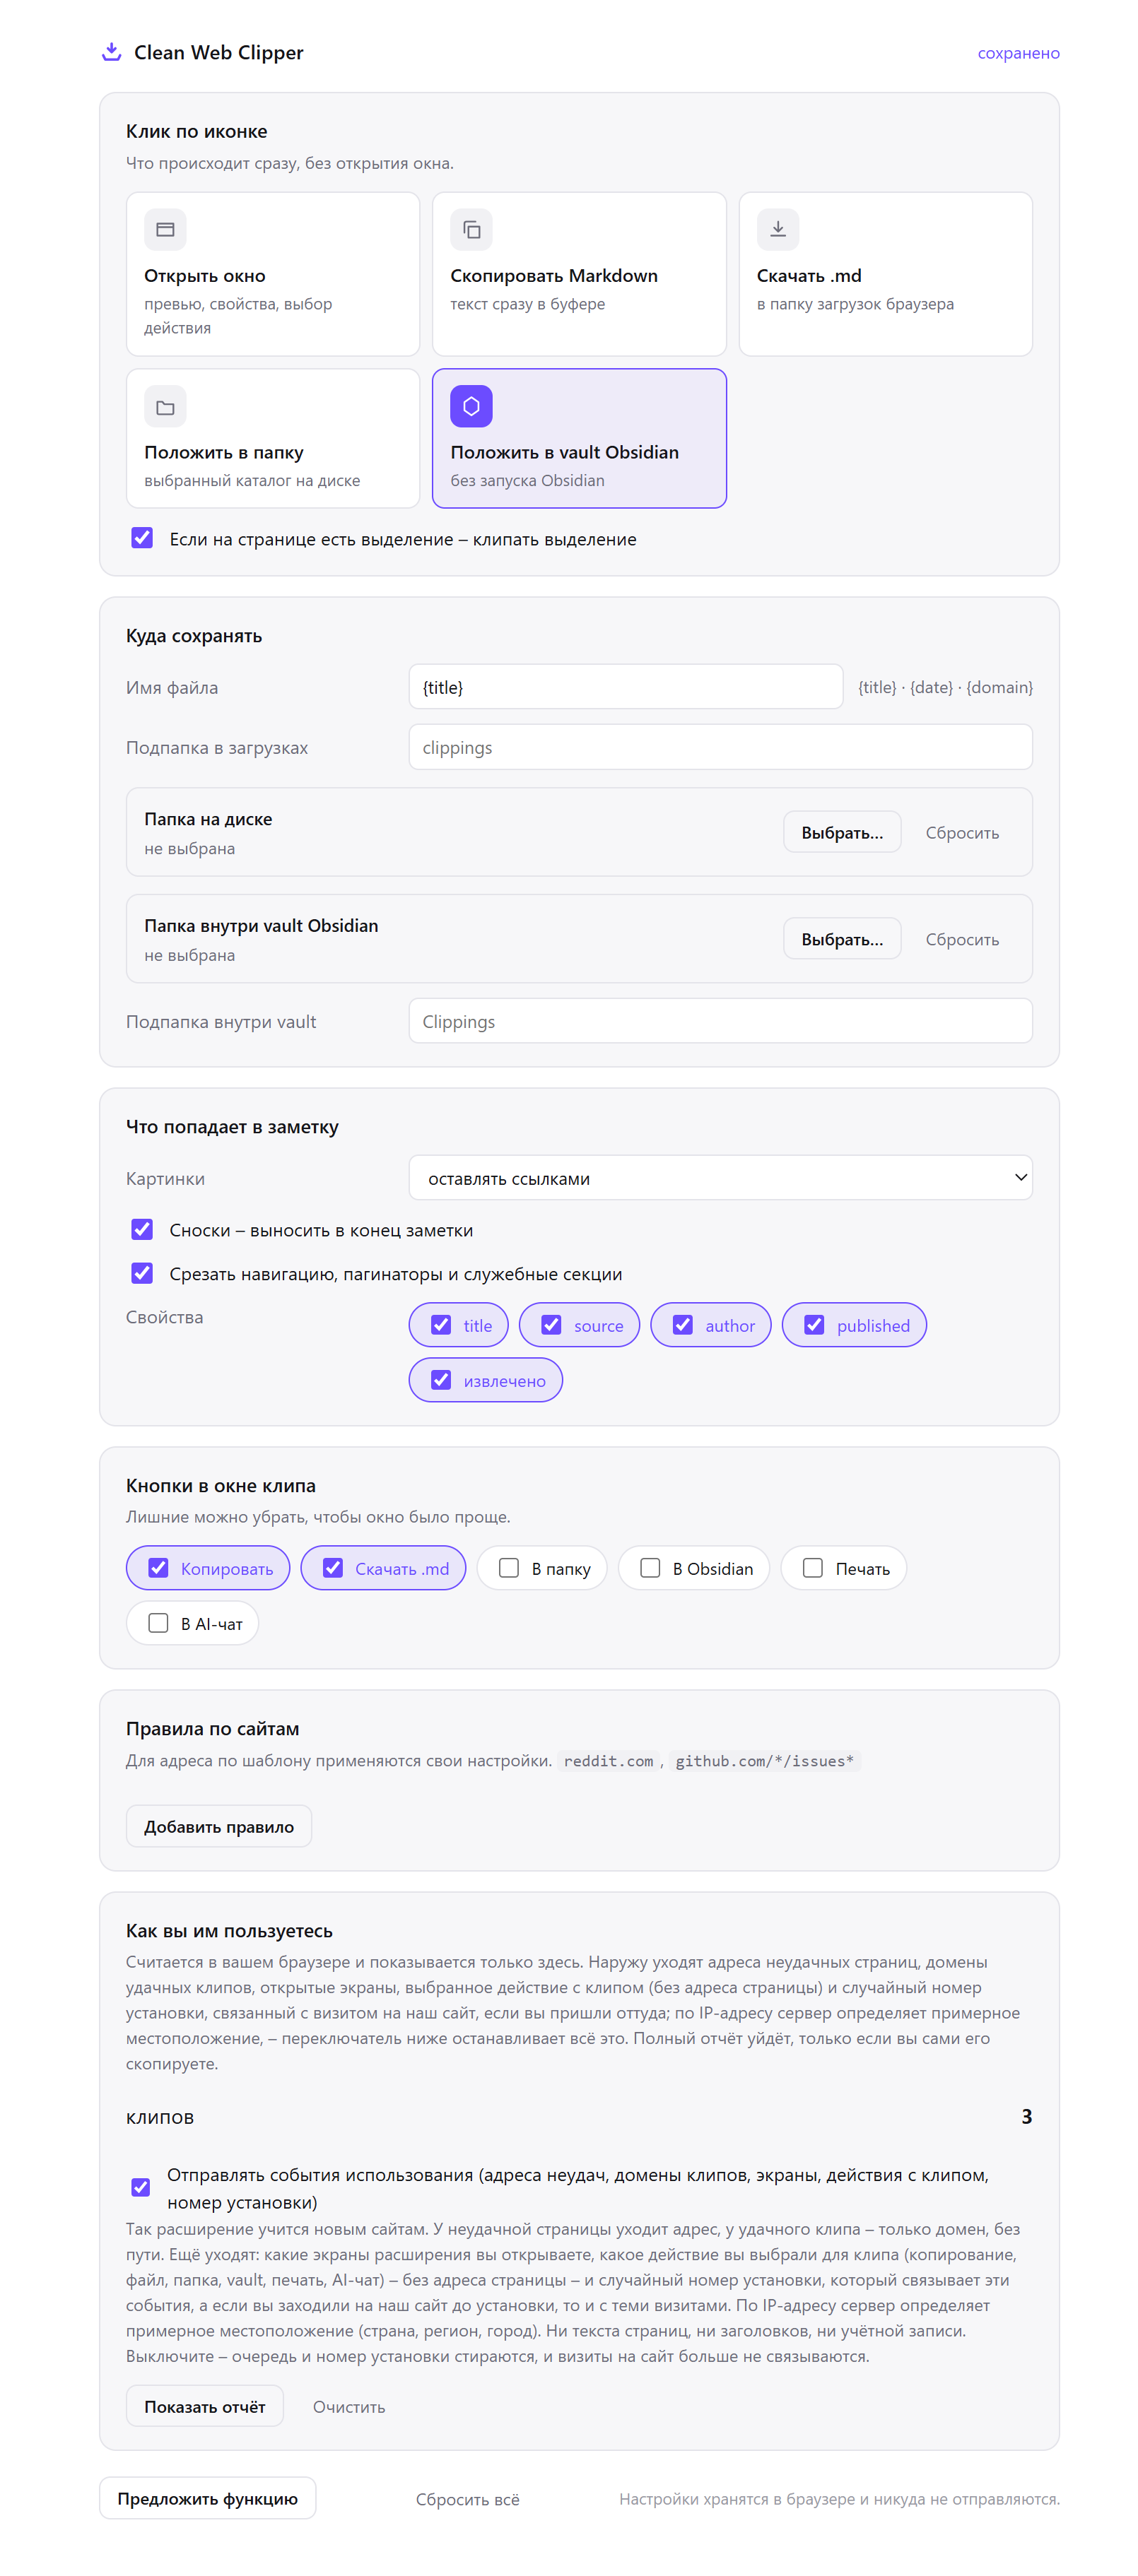
- В настройках, в разделе «Куда сохранять», выберите эту папку и впишите шаблон имени
{date} – {domain} – {title}. Дата берётся из публикации, домен отвечает, чья это была страница, – и папка читается без единого инструмента, обычным списком файлов. - В разделе «Что попадает в заметку» откройте «Свойства» и оставьте все пять полей. Через десять лет метаданные внутри файла будут единственным, что о нём известно: ни базы, ни индекса, ни приложения рядом уже может не оказаться.
- Переключите «Клик по иконке» на «Положить в папку». Архив собирается по ходу чтения или не собирается вовсе; всё, что добавляет шаг, со временем перестают делать.
- Клипайте прочитанное сразу, не откладывая. Расширение не умеет достать страницу, которую вы не открыли, – ни краулера, ни очереди адресов у него нет, и вернуться к закрытой вкладке за клипом уже не выйдет.
- Раз в полгода откройте случайный файл из архива и убедитесь, что он читается. Это простой текст с YAML-фронтматтером: разметка разбирается глазами даже без единого инструмента для Markdown.
Какие настройки подходят для личного архива?
Здесь всё подчинено одному правилу: файл должен оставаться понятным без расширения, без приложения и без вас. Каждая строчка ниже отвечает на вопрос «а что через десять лет».
| Настройка | Значение | Почему именно так |
|---|---|---|
| Папка на диске | внутри каталога, который уже копируется | архив вне резервной копии – самая частая причина потерять его целиком |
| Имя файла | {date} – {domain} – {title} | папка читается обычным списком файлов: видно, что, откуда и когда, без открытия |
| Клик по иконке | Положить в папку | архив собирается по ходу чтения; всё, что добавляет шаг, со временем перестают делать |
| Свойства | все пять полей | через десять лет метаданные внутри файла – единственное, что о нём будет известно |
| Картинки | оставлять ссылками | ссылка отмечает место картинки, но умрёт вместе с сайтом; важные изображения надо сохранять отдельно |
| Сноски | выносить в конец заметки | определения примечаний уезжают в файл целиком – иначе от них останутся только номера |
| Срезать навигацию | включено | обвязка сайта стареет быстрее текста и в архиве не значит уже ничего |
Архив/2019-11-08 – rusarchives.ru – Фонд 1349.md

---
title: "Фонд 1349. Коллекция формулярных списков"
source: "https://rusarchives.ru/fonds/1349"
published: "2019-11-08"
extraction: "dom"
---

Формулярные списки составлялись ежегодно и содержат сведения
о происхождении, чинах, наградах и прохождении службы.[^1]

## Сноски

[^1]: Опись переведена в электронный вид частично.
Пройти три сценария целиком
Три сценария показывают, чем обычный файл выручает не сразу, а спустя время: статья, исчезнувшая через два года вместе с изданием, архив, переживший смену компьютера, и материал, который читается только под своим логином. В каждом решает то, что текст уже лежит у вас, а не на чужом сервере, который может закрыться или сменить владельца.
Статья, которая через два года исчезла
Вы прочли разбор, показавшийся важным, и склипали его в архив, не думая, пригодится ли. Через два года издание закрылось, домен не продлили, и по адресу висит заглушка. В публичном веб-архиве этой страницы нет: робот до неё не дошёл.
У вас она есть – текстом, с адресом и датой публикации внутри файла. Вида страницы, конечно, нет: ни вёрстки, ни стилей, ни скриншота. Но текст, ради которого всё и делалось, читается ровно так же, как в день сохранения.
Архив, переживший смену компьютера
Вы меняете машину, и вместе с ней меняется всё: браузер ставится заново, расширения настраиваются с нуля, разрешение на папку приходится выдавать снова. Архив при этом переезжает как обычная папка – потому что это и есть обычная папка.
Ни одного шага «экспортировать перед переносом» здесь нет. После того как файл записан, от расширения не зависит уже ничего: ни открытие, ни поиск, ни чтение. Настройки на новой машине придётся ввести заново – они хранятся в браузере и никуда не отправляются.
То, что читается только под своим логином
Часть материалов, которые стоит сохранить, лежит за входом: подписка, внутренний портал, личный кабинет. Публичный архиватор их не увидит никогда, а закладка приведёт второго человека на страницу входа.
Клип снимает то, что браузер отрисовал для вас, поэтому такие страницы архивируются так же, как любые другие. Содержимое при этом никуда не уходит: текст остаётся между браузером и вашим диском.
Чем это отличается от привычных способов?
Прочитанное сохраняют пятью способами, и каждый оптимизирует что-то своё: удобство, полноту, независимость. Ниже – что каждый из них на самом деле обещает.
| Способ | Что получается | Чего стоит |
|---|---|---|
| Закладка | мгновенно и ничего не весит | сохраняется адрес, а не текст; через несколько лет заметная часть закладок не ведёт никуда |
| Сервис отложенного чтения | текст без обвязки, с синхронизацией и поиском | формат чужой, аккаунт обязателен, а экспорт бывает не всегда и полным – редко |
| Публичный веб-архив | независимая копия с отметкой времени | глубокие страницы попадают туда выборочно, за логин он не проходит, и сохранить свою страницу по требованию удаётся не везде |
| Сохранить страницу целиком | сохраняются вёрстка, стили и картинки | на диске остаётся папка служебных файлов, которую через десять лет откроет не всякий браузер |
| Печать в PDF | один файл, вид страницы сохранён | текст ищется хуже, правка невозможна, а метаданных внутри обычно нет вовсе |
| Clean Web Clipper | простой текст с метаданными, дальше ни от чего не зависящий | ни вёрстки, ни скриншота, ни картинок; краулера нет – сохраняется только то, что вы открыли |
Что архив всё-таки не спасает?
Ниже – честные границы текстового архива: неоткрывающиеся картинки, вид страницы, который не сохраняется, настройки, которые приходится вводить заново на новом компьютере, и служебные страницы, которые вообще не клипаются. Каждое ограничение – осознанный выбор, а не недоработка расширения, и почти для каждого есть обходной путь, описанный ниже, который не требует ни другого инструмента, ни отказа от текстового архива целиком.
Почему картинки в архиве не открываются?
Потому что в файле лежат ссылки на них, а не сами изображения: двоичных файлов расширение не скачивает. Пока сайт жив, ссылки работают; когда он закроется, они умрут вместе с ним.
Это и есть главная дыра текстового архива, и закрывать её надо руками: сохраняйте важные изображения отдельно, обычным «Сохранить изображение», в ту же папку рядом с клипом. Тогда связь между текстом и картинкой сохранится хотя бы физически.
Почему сохранённая страница выглядит не так, как в браузере?
Потому что сохраняется текст и его структура, а не вид страницы. Ни стилей, ни колонок, ни шрифтов, ни расположения блоков в файле нет. Если для вас важен именно вид – скажем, страница ценна вёрсткой, – этот инструмент не подходит: нужен снимок экрана или архивный сервис, который хранит именно картинку страницы, а не её текст.
Почему на новом компьютере всё пришлось настраивать заново?
Потому что настройки хранятся в браузере и никуда не отправляются – ни на чей сервер, включая наш. Разрешение на папку тоже живёт в браузере и между устройствами не переносится, даже если синхронизирован сам профиль. Это цена отсутствия учётной записи, и платится она один раз при переезде, а не при каждом клипе.
Почему некоторые страницы вообще не клипаются?
Потому что браузер их защищает. На служебных страницах вроде chrome:// и в магазине расширений расширения не запускаются вовсе – там вы увидите сообщение, что склипать страницу нельзя. Обойти это нечем: ограничение стоит на стороне браузера, а не расширения, и действует оно одинаково для всех расширений подряд, включая самые известные и популярные.
Чего Clean Web Clipper не сохраняет в личный архив?
Clean Web Clipper не сохраняет страницу в том виде, в каком она показана: ни вёрстки, ни стилей, ни скриншота, ни сопутствующих файлов. Он не скачивает двоичные файлы, поэтому картинки остаются ссылками на исходный сайт и могут умереть вместе с ним. Он не делает за вас резервных копий и ничего не синхронизирует между устройствами. И он не обходит сайт, чтобы сохранить все его страницы: клип всегда начинается с вашего клика.
Что именно попадает в файл, описано на странице об устройстве извлечения.
Насколько долговечен архив из клипов?
Что будет, если расширение перестанут развивать? С вашими файлами ничего. Это обычные файлы Markdown в вашей папке: после записи они не зависят от расширения никак.
Сохраняются ли картинки?
Есть ли предел числу клипов?
Будет ли формат читаться через десять лет?
.md открывается в любом редакторе – даже без единого инструмента для Markdown, потому что разметка читается глазами как есть.Можно ли архивировать страницу, которая требует входа?
Как архив хранится и переносится?
Сколько места занимает архив? Мало: это текст. Тысяча сохранённых страниц укладывается в объём, который на любом диске не заметен, – и целиком помещается в обычную резервную копию вместе с остальными документами.