Как устроено · ·
Как Clean Web Clipper извлекает статью в Markdown и где останавливается
Clean Web Clipper извлекает статью из открытой страницы и переводит её в Markdown целиком внутри браузера: конвейер извлечения к серверу не обращается, а единственный адрес, с которым связывается расширение, – наш сервер статистики. Ниже по четырём шагам – как Clean Web Clipper извлекает статью: поиск статьи, срез обвязки, конвертация и отказ «статьи нет» там, где её на странице нет.
Как расширение находит статью на странице?
Сначала расширение ищет привычные контейнеры, в которых обычно лежит статья. Если такого контейнера нет – а на множестве настоящих сайтов его нет, – в ход идёт замер плотности текста: в каком блоке больше всего абзацев, не спрятанных внутрь ссылок. Побеждает самый узкий блок, в котором всё ещё лежит почти весь этот текст.
Блок, где текст состоит в основном из подписей к ссылкам, – это меню или лента, а не статья, и он отбрасывается. Исключение – если в нём больше примерно 1200 символов настоящего текста: длинные статьи законно содержат много ссылок.
Срезать меню, баннеры и повторы строк
Дальше уходят известные не-содержательные элементы: навигация, баннеры, панели «поделиться», плашки про куки, пагинаторы, ленты «читайте также» и полосы логотипов. Повторяющиеся строки удаляются: навигация, продублированная в каждой секции, – главный источник шума в склипанной странице: в замере 30 августа 2026 года на 109 страницах у Clean Web Clipper 102 повтора строк меню против 282–491 у трёх других движков.
что оставляют другие
[К содержанию](#main) [Войти](/login) [Регистрация](/register)
[Главная](/) [Новости](/news) [Спорт](/sport) [Культура](/culture) [Ещё](/more)

Мы используем куки и похожие технологии, чтобы улучшить ваш опыт.
[Принять все] [Настроить]

# Статья, за которой вы пришли

Настоящий первый абзац текста.

<div class="promo-inline">

## Читайте также
[Другой заголовок](/a) [Ещё один заголовок](/b) [И третий](/c)
что попадает в заметку
# Статья, за которой вы пришли

Настоящий первый абзац текста.
Перевести таблицы, код и сноски в Markdown
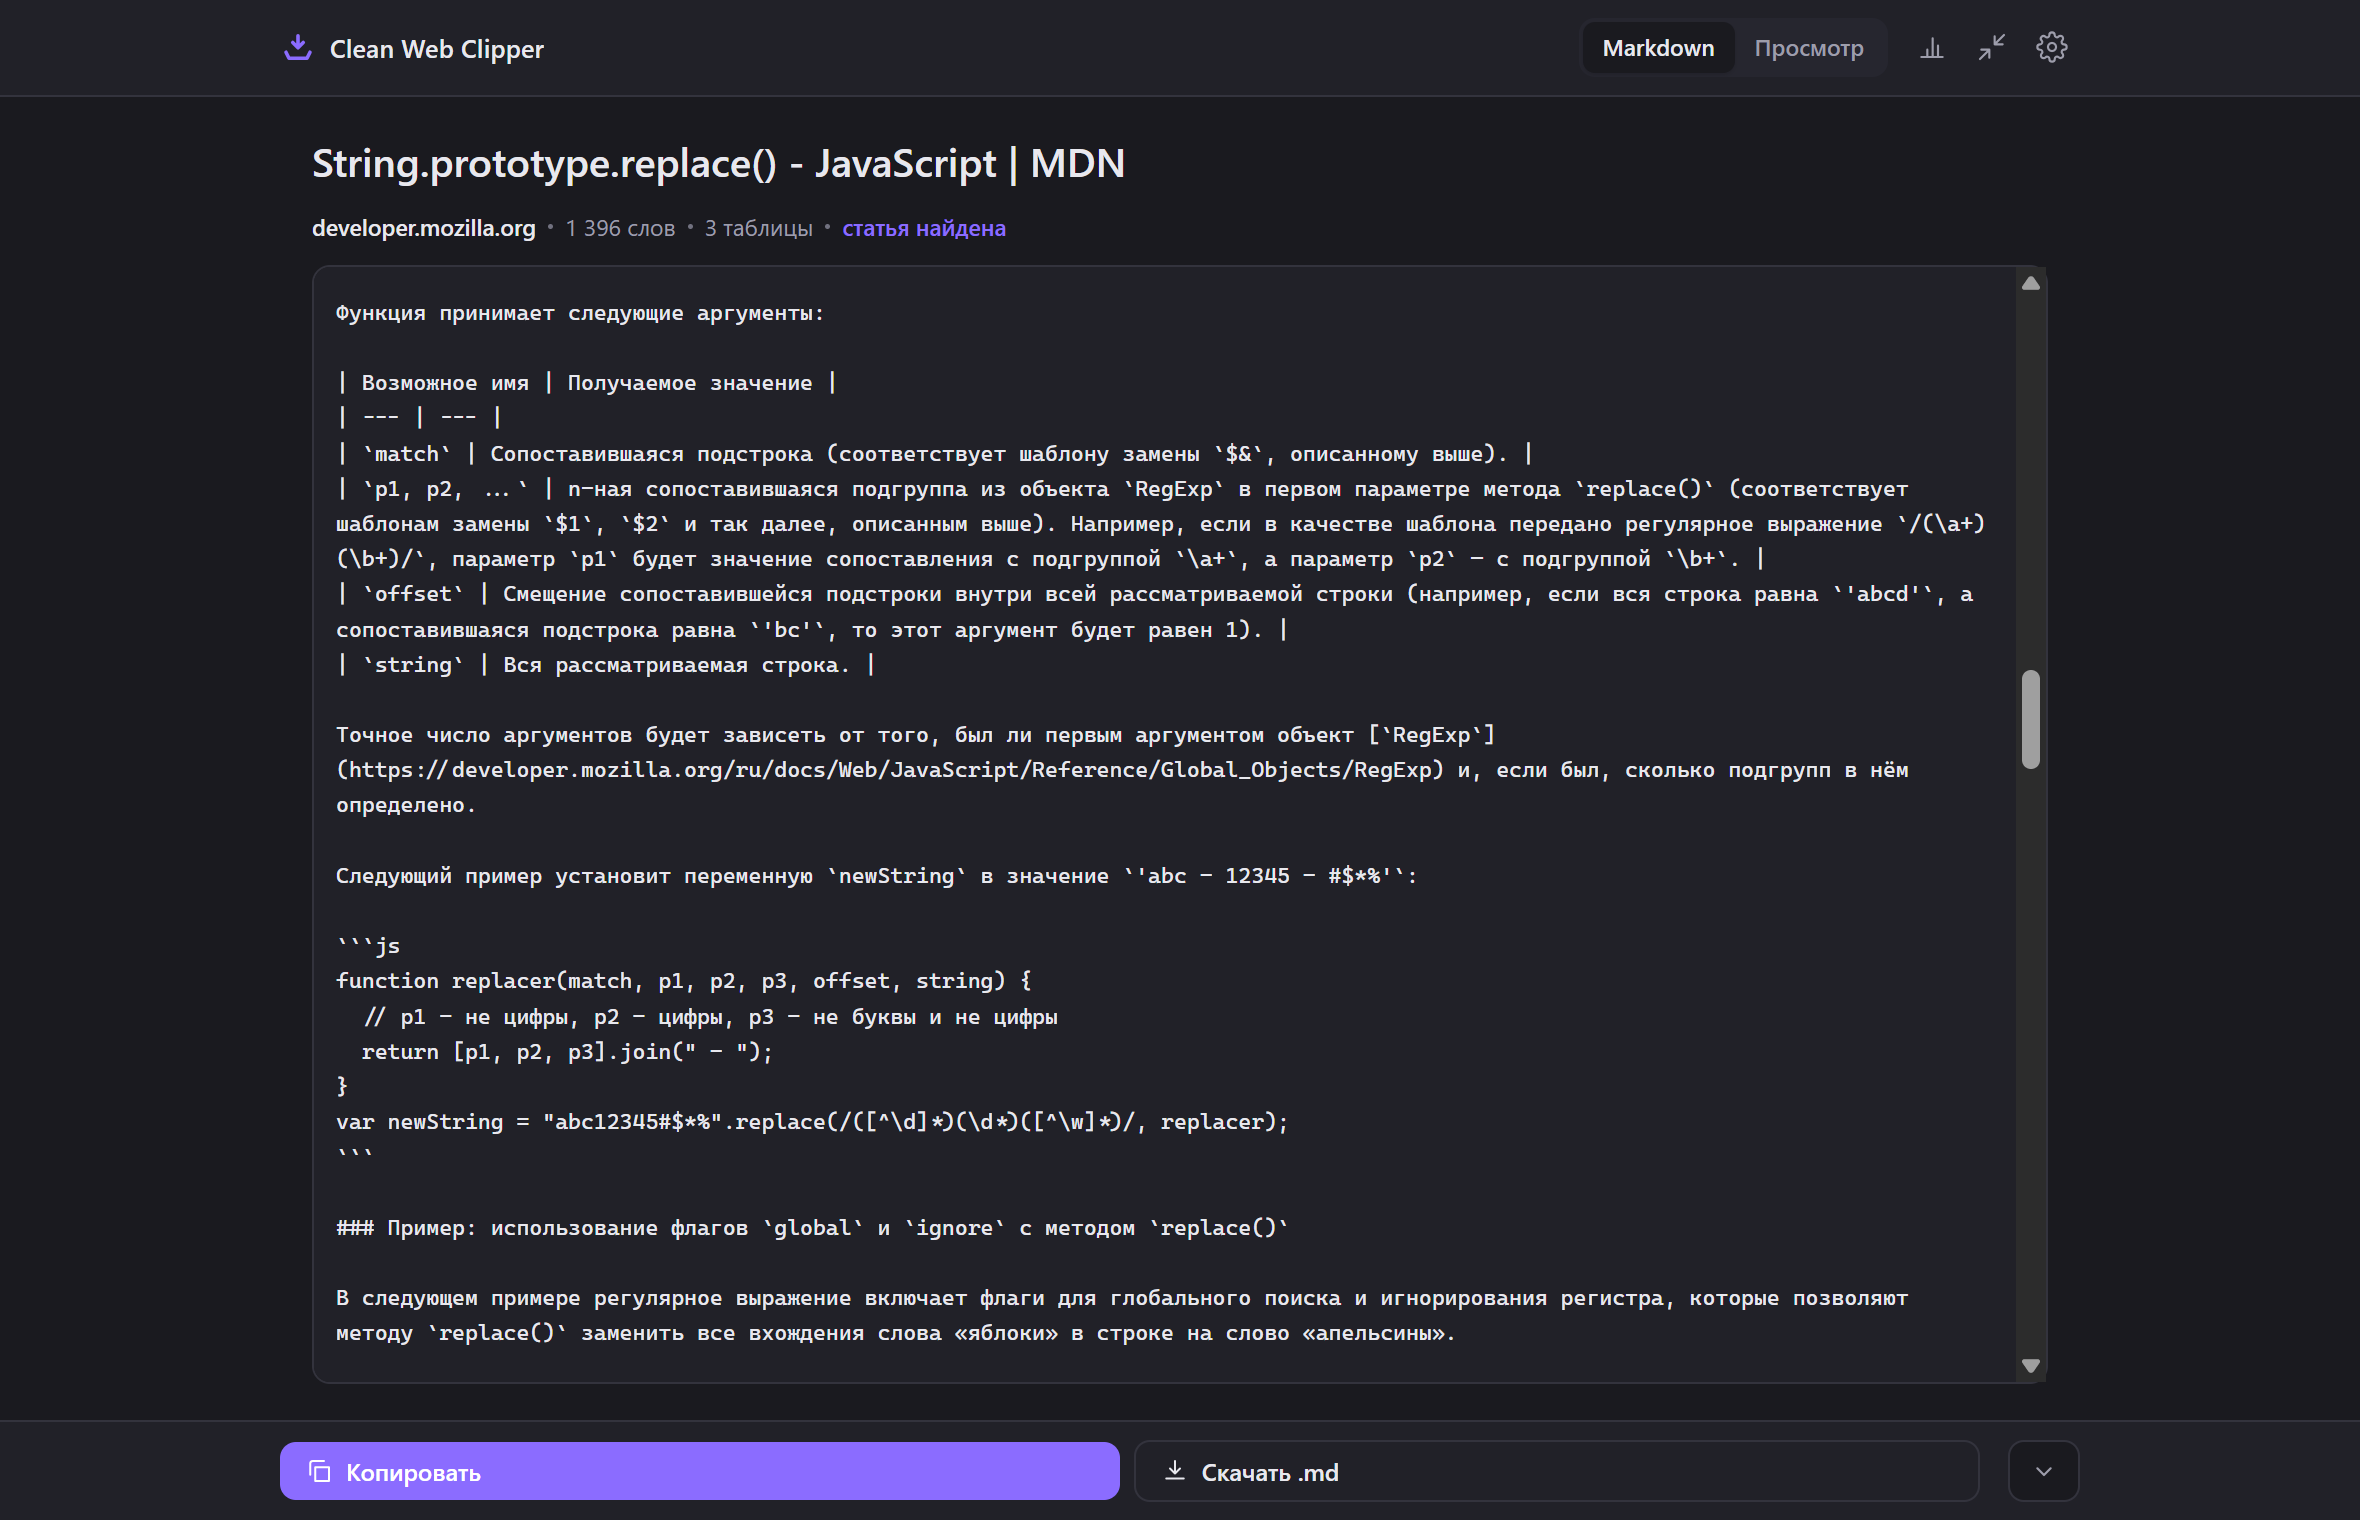
Таблицы расширение сериализует само, а не общим плагином: универсальные конвертеры ломаются на ячейке со списком или блоком кода. Заборы кода берут язык из разметки самой страницы. Ссылки-примечания собираются в сноски Markdown до того, как санитайзер срежет идентификаторы, на которые они опираются, – порядок здесь важен, и ошибка в нём молча теряет все сноски. Как это сказалось на таблицах, датах и повторах строк по четырём движкам, – на странице замера.
Где извлечение останавливается?
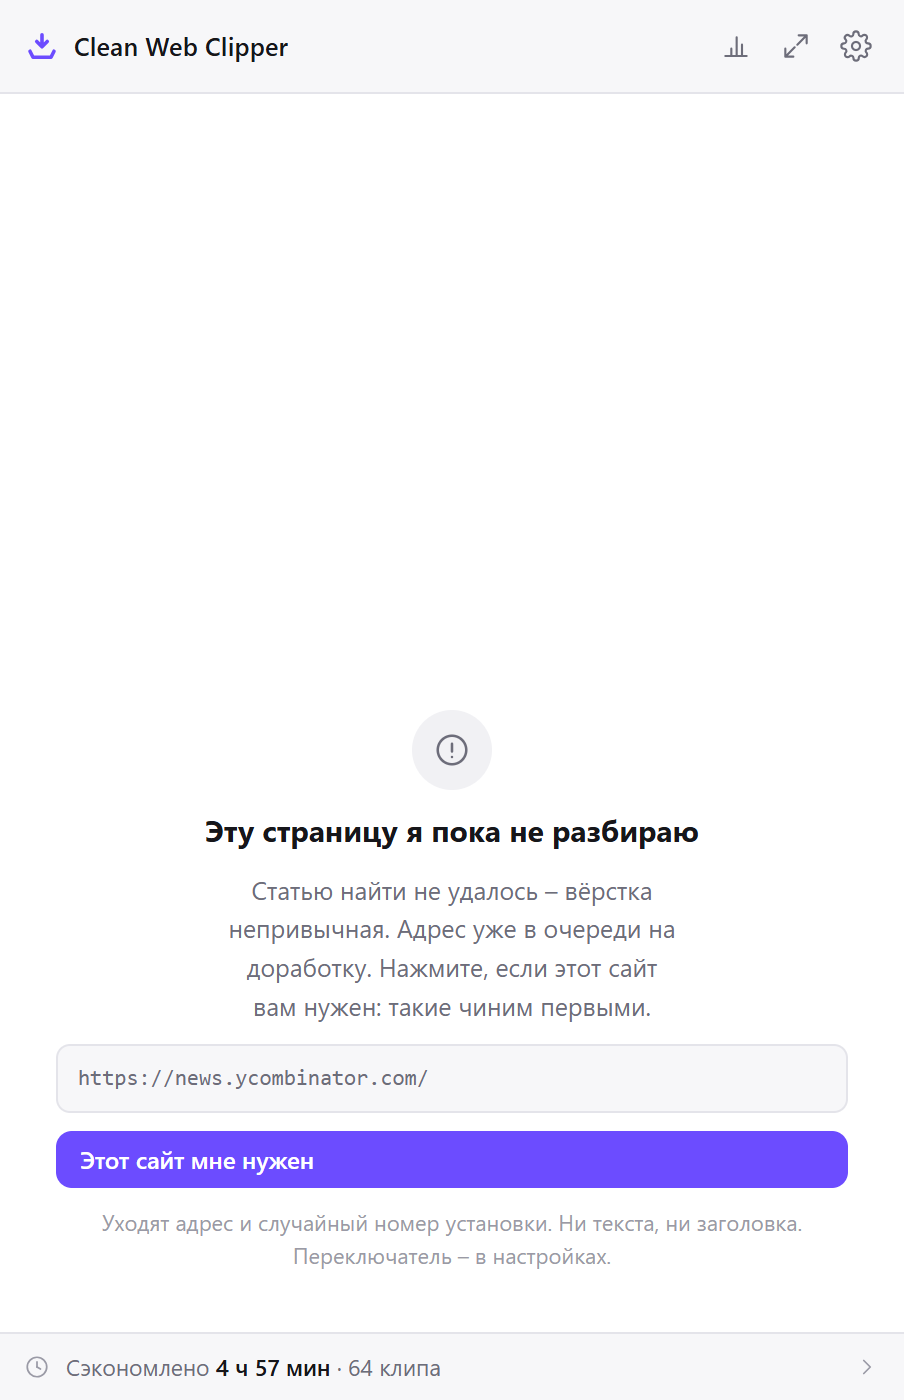
На витрине, в ленте или в результатах поиска статьи нет. Расширение проверяет готовый Markdown: если больше четверти его сидит внутри подписей к ссылкам, оно отвечает «статьи нет», а не выдаёт триста ссылок. Этот отказ сделан намеренно, и из-за него счётчики символов здесь ниже, чем у инструментов, которые всегда что-то возвращают.
Если отказ случился на настоящей статье, это ошибка: как прислать адрес такой страницы, и такие чинятся первыми.
Чего Clean Web Clipper не делает?
- Не скачивает картинки, видео и прочие двоичные файлы – ссылки на изображения ведут на исходный сайт
- Не обходит сайт: одна страница за раз, та, на которой вы стоите
- Не пересказывает и не переписывает: текст статьи конвертируется, а не редактируется
- Не работает на страницах, которые защищает браузер, –
chrome://, сам магазин расширений и открытые в браузере PDF