Кому это · ·
Статьи в Markdown с датой публикации, а не сохранения
Статья без даты публикации превращается в ссылку, которую потом придётся восстанавливать; Clean Web Clipper сохраняет статьи в Markdown с датой из метаданных страницы, а не выискивает её в тексте, и оставляет фронтматтер без строки date, когда страница даты не несёт. Ссылки-примечания становятся обычными сносками Markdown, собранными в конце файла.
Откуда эти цифры: страница замера с версиями движков и датами
Где теряется ссылка?
Момент, когда источник становится непригодным, почти всегда один и тот же: его надо атрибутировать. В клипе приблизительный заголовок, адреса нет, а дата – это день, когда вы читали страницу. Вы лезете обратно в браузер искать статью, а она уже переехала или ушла за доступ, которого у вас больше нет. Заметка есть, и она ничего не доказывает.
Второе место разрыва – сноски. Научная статья держится на примечаниях не меньше, чем на основном тексте, а большинство конвертеров превращает их в мёртвые якоря, ведущие на давно закрытую страницу. Номера в тексте остаются, определения пропадают, и понять, на что ссылалось третье примечание, уже нельзя.
Привычный обход – сохранять всё в PDF – переносит проблему на год вперёд. Папка из двухсот файлов ищется плохо: полнотекстовый поиск спотыкается о лигатуры и переносы, из двухколоночной вёрстки абзац копируется вперемешку с соседней колонкой, а метаданных внутри файла обычно нет вовсе. Вы получаете архив, из которого ничего нельзя достать быстрее, чем открыть заново и прочитать.
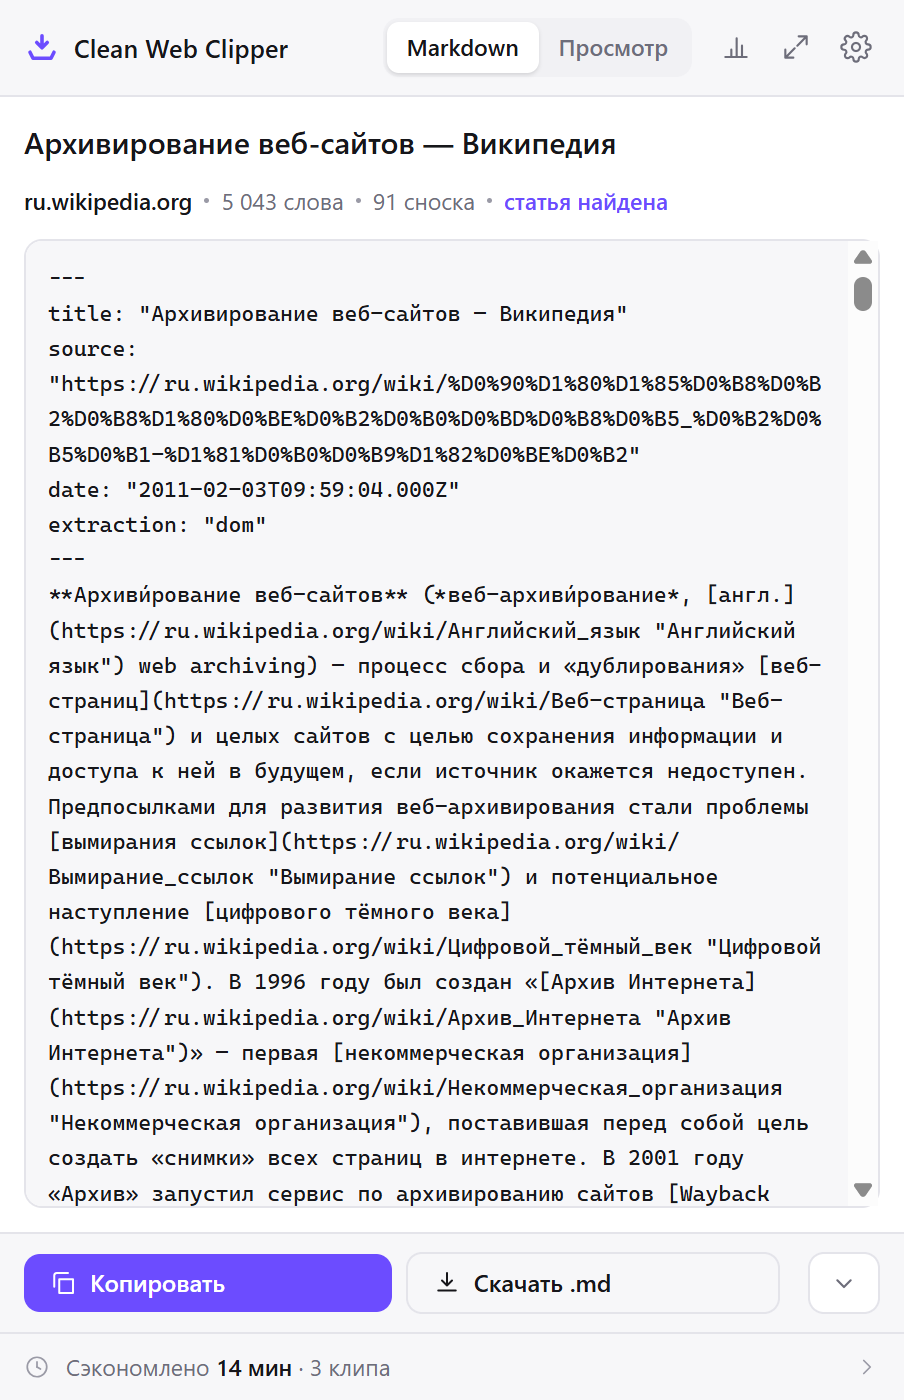
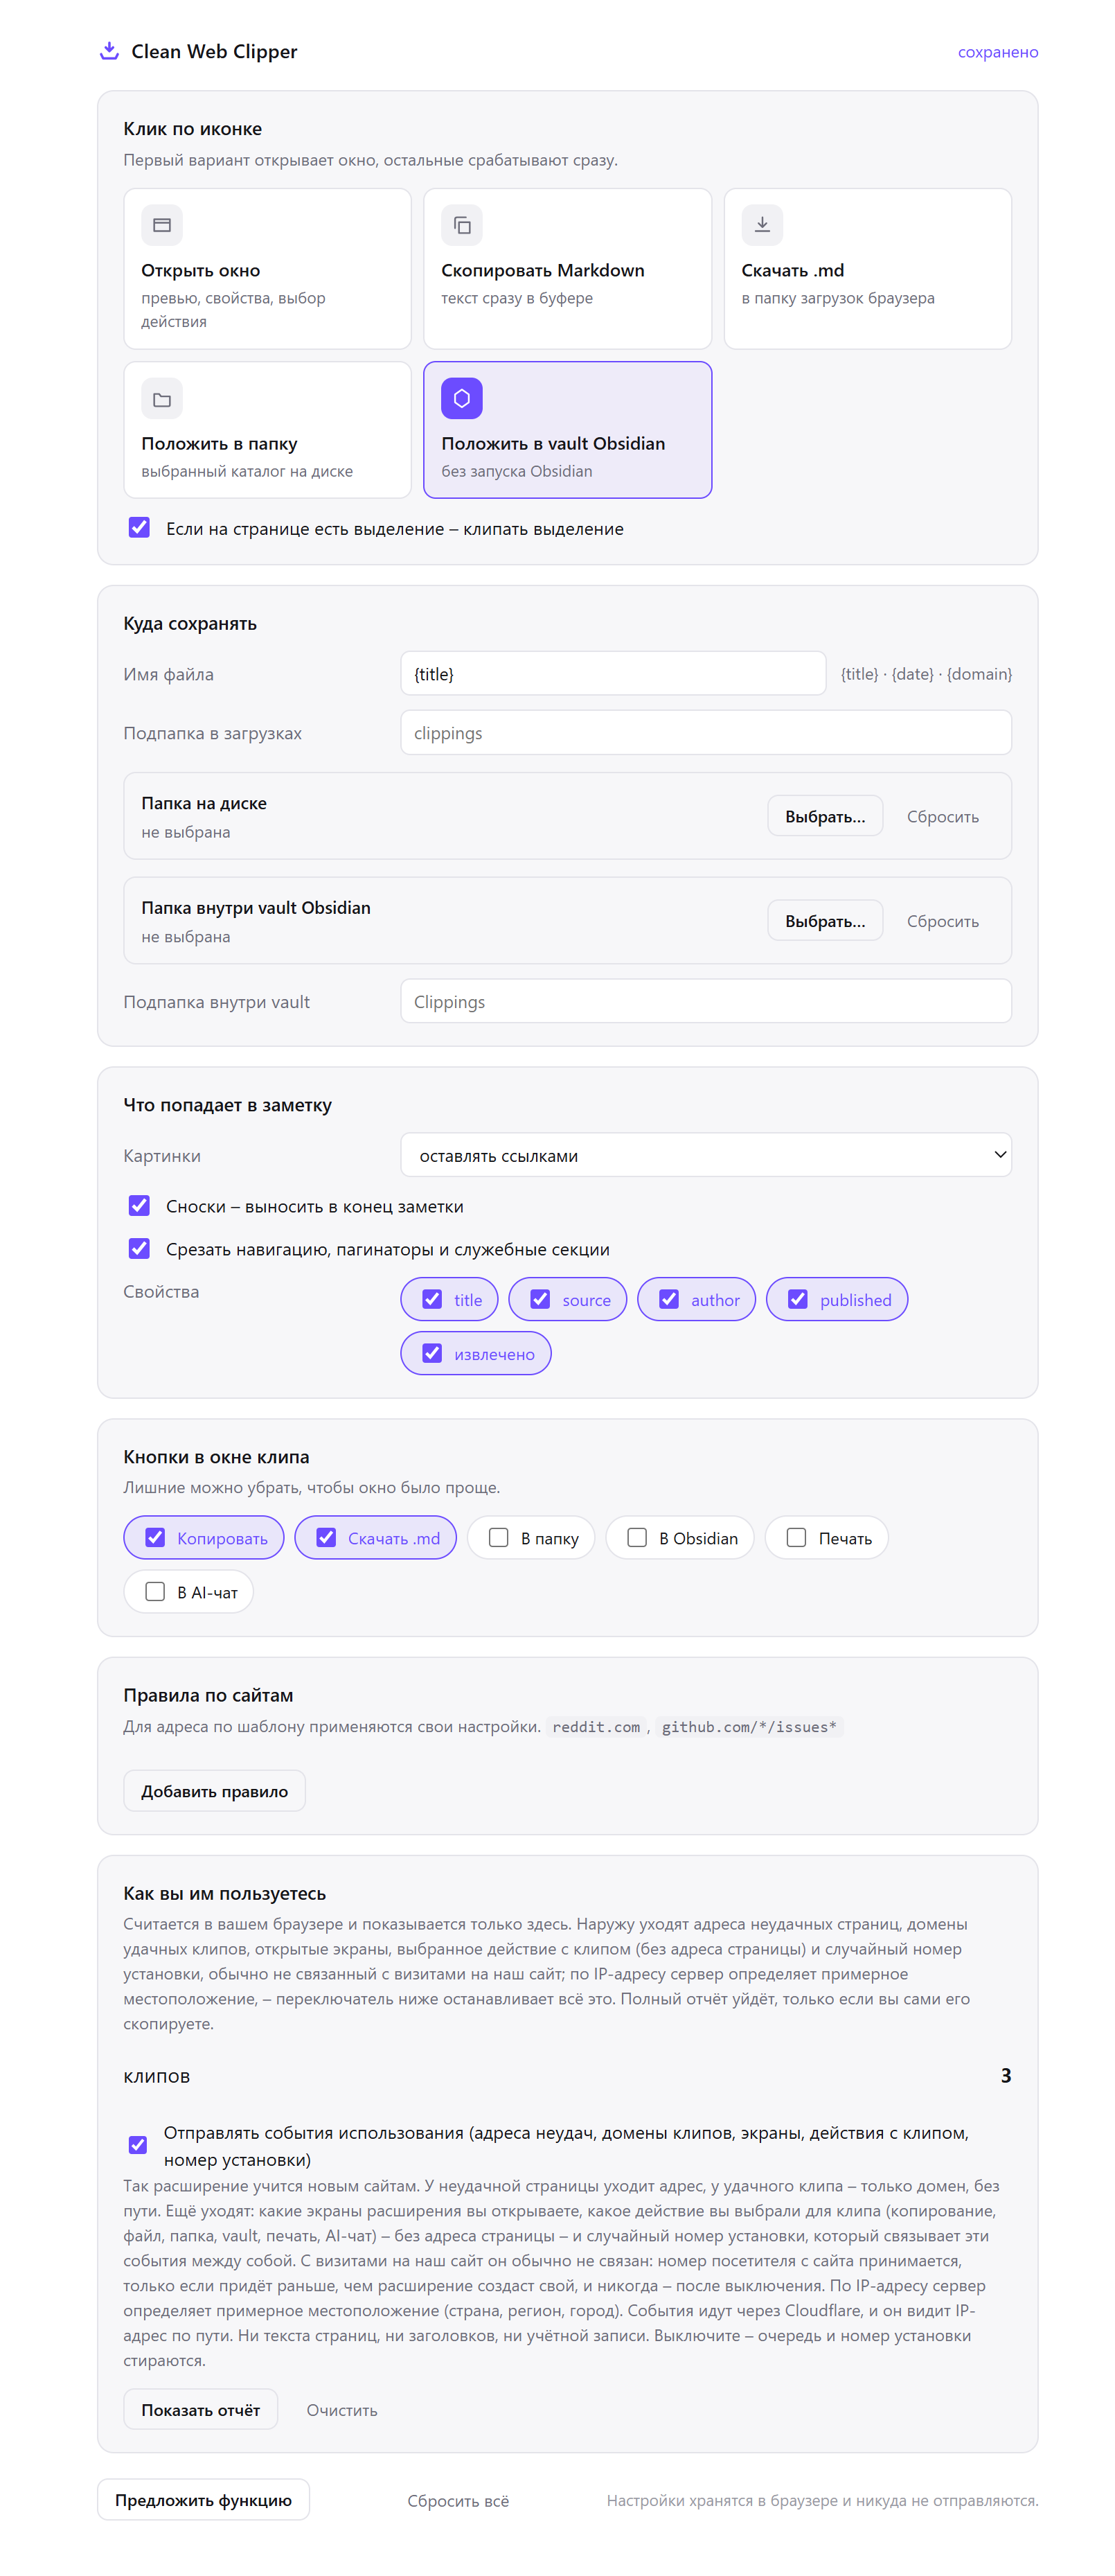
Что сохраняет заметка?
- Читает
citation_dateиcitation_publication_date– метатеги, которые отдают arXiv, PubMed, eLibrary и IEEE - Читает также
datePublishedиз JSON-LD,article:published_time,time[datetime]и Unix-метки - Нет даты на странице – строки
dateнет, а не сегодняшнее число; в отдельной проверке до выпуска на 9 технических страницах (август 2026) дата нашлась на 7 из 9 - Ссылки-примечания становятся сносками
[^1], определения собираются в конце файла - Автор фильтруется: заголовки рубрик и подписи кнопок в поле author не оказываются
- Адрес источника пишется во фронтматтер, поэтому на заметку можно сослаться саму по себе
- Разные записи даты приводятся к одному виду: Unix-метка,
2024/03/07и полный ISO становятся одной строкой - Неправдоподобная дата отбрасывается – год за пределами промежутка с 1990 по 2100 в поле не попадёт
---
title: "Attention Is All You Need"
source: "https://arxiv.org/abs/1706.03762"
author: "Vaswani, Ashish"
date: "2017-06-12T00:00:00.000Z"
extraction: "dom"
---
# Computer Science > Computation and Language

**arXiv:1706.03762** (cs)

\[Submitted on 12 Jun 2017 ([v1](https://arxiv.org/abs/1706.03762v1)), last revised 2 Aug 2023 (this version, v7)\]

# Title:Attention Is All You Need
…
Как собирать корпус для обзора
Порядок ниже рассчитан на обзор литературы, который вы ведёте не неделю, а полгода. Главное здесь не скорость клипа, а то, чтобы через полгода к каждой выписке нашёлся источник.
- В настройках, в разделе «Куда сохранять», выберите папку обзора на диске и впишите шаблон имени файла
{date}-{title}. Файлы тогда выстраиваются по дате публикации, и порядок в папке совпадает с хронологией темы, а не с порядком вашего чтения. - В разделе «Что попадает в заметку» откройте «Свойства» и оставьте все пять полей, включая
extraction. Когда через полгода возникнет спор о цитате, это первое, на что смотрят: значениеdomозначает отрисованную страницу,jsonld-articlebody– тело из структурированных данных. - Убедитесь, что «Сноски – выносить в конец заметки» включено. Маркеры в тексте превратятся в
[^1],[^2]со сквозной нумерацией с единицы, а определения соберутся под заголовком «Сноски» в конце файла – вместе со списком литературы, который из тела уедет туда же. - Открыв статью, нажмите иконку и посмотрите на строку
date. Если её нет, это значит, что даты не нашлось ни в JSON-LD, ни в метатегах вродеcitation_date, ни вtime[datetime], – и это сигнал искать дату у издателя, а не повод её выдумать. - Если нужен только раздел «Методы» или только выводы, выделите его до нажатия. Выделение приезжает целиком, без срезки, – но помните, что определения сносок остаются за его границей и такие маркеры из текста убираются.
- Сохраните файл и держите папку в обычной резервной копии. Дальше это простой текст: полнотекстовый поиск системы и редактора находит цитату по трём словам, а адрес источника лежит во второй строке файла.
Какие настройки подходят для обзора литературы?
Набор рассчитан на долгий проект, где выписка должна пережить смену темы, компьютера и научного руководителя. Всё, что помогает восстановить происхождение цитаты, здесь включено.
| Настройка | Значение | Почему именно так |
|---|---|---|
| Имя файла | {date}-{title} | корпус сам сортируется по хронологии темы, а не по порядку вашего чтения |
| Папка на диске | папка проекта, а не загрузки | выписки должны лежать рядом с текстом обзора и попадать в ту же резервную копию |
| Свойства | все пять полей | extraction объясняет, откуда взят текст, – при спорной цитате это первое, что проверяют |
| Сноски | выносить в конец заметки | научный текст держится на примечаниях; в конце они читаются, а посреди абзаца мешают |
| Картинки | оставлять ссылками | графики и формулы на страницах журналов нарисованы картинками, и ссылка хотя бы отмечает их место |
| Если на странице есть выделение – клипать выделение | включено | из обзорной статьи чаще нужен один раздел, а не сорок тысяч знаков целиком |
| Клик по иконке | Открыть окно | дату и автора имеет смысл проверять глазами до сохранения, а не после |
---
title: "The Many Lives of the Medieval Wound Man"
source: "https://publicdomainreview.org/essay/the-many-lives-of-the-medieval-wound-man/"
author: "Jack Hartnell"
extraction: "dom"
---
Sliced, stabbed, punctured, bleeding, harassed on all sides by various weaponry, the curious image of Wound Man is a rare yet intriguing presence in the world of medieval and early modern medical manuscripts. Jack Hartnell explores this enigmatic figure's journey through the centuries.

Published

December 7, 2016
…
Пройти три сценария целиком
Три сценария показывают, как датированный клип работает в реальной работе над обзором: сорок источников за неделю, статья, которая не назвала дату вовсе, и примечание, к которому вернулись через год после выписки. Каждый – типичный момент исследовательской работы, а не выдуманная иллюстрация, и в каждом решает не память о прочитанном, а строка во фронтматтере.
Обзор литературы на сорок источников
Вы собираете обзор и за неделю проходите сорок статей в разных базах. Каждую клипаете прямо со страницы, где читаете, – включая те, что открылись через институциональный доступ и по прямой ссылке не откроются ни у кого другого.
В папке проекта сорок файлов, названных по дате публикации и заголовку. Поиск по слову «гетероскедастичность» находит три из них за секунду, и в каждом во второй строке лежит адрес, по которому статья бралась. Библиографическую запись расширение не собирает: ни BibTeX, ни RIS, ни ГОСТ – оформление остаётся за вашим менеджером ссылок.
Статья с датой, которой нет
Страница журнала выглядит аккуратно, но строки date в окне клипа нет. Это значит, что дату не отдали ни JSON-LD, ни метатеги, ни элемент time – и расширение не стало подставлять сегодняшнее число, потому что молча заведённая неверная дата хуже отсутствующей.
Дальше это ваша развилка: посмотреть выходные данные выпуска, взять дату у издателя или оставить как есть и пометить в тексте обзора. Важно, что развилка видна сразу, а не всплывает на этапе оформления списка литературы, когда до сдачи два дня.
Сноски, понадобившиеся через год
Через год после выписки нужно понять, на что ссылалось третье примечание в статье, которую вы читали. В файле оно на месте: маркер [^3] стоит в тексте, а определение лежит в конце под заголовком «Сноски», уже без служебных стрелок обратных ссылок.
Нумерация в файле сквозная и начинается с единицы независимо от того, как нумеровала страница: сопоставление идёт по цели ссылки, а не по подписи. Если одно и то же примечание встречалось в статье трижды, определение в файле будет одно, а маркеров – три.
Чем это отличается от привычных способов?
Источник для обзора фиксируют пятью способами, и каждый ломается на своём этапе. Смотреть стоит не на удобство сохранения, а на то, что происходит через полгода.
| Способ | Что получается | Чего стоит |
|---|---|---|
| Сохранить страницу в PDF | вид страницы сохраняется полностью | поиск по папке спотыкается о переносы, а из двухколоночной вёрстки абзац копируется вперемешку с соседней колонкой |
| Закладка на статью | делается мгновенно | через год журнал сменил адреса, а институциональный доступ, под которым вы читали, кончился вместе с местом работы |
| Копировать абзацы в общий документ | нужное сразу под рукой | выписки быстро теряют происхождение: дата и адрес остаются в голове, а не в файле |
| Снимок экрана | ничего не съезжает и не меняется | текст не ищется, формулу не скопировать, и на каждую цитату приходится открывать картинку |
| Менеджер библиографии | ссылка оформится по нужному стилю | хранит запись о статье, а не её текст: перечитать выписку внутри него обычно нельзя |
| Clean Web Clipper | текст, дата из метаданных и рабочие сноски в одном файле | библиографию не оформляет и PDF не скачивает – снимает HTML-страницу, которая перед вами |
Что делать, если данные не сошлись?
При выписке источников в Clean Web Clipper чаще всего смущают четыре вещи: нет строки даты, автор, заполненный не именем, пропавшие номера сносок при клипе выделения и дата обновления вместо публикации. В каждом случае расширение предпочло отсутствие строки правдоподобному, но неверному значению, а не наоборот, и почти всегда причину можно проверить прямо на исходной странице.
Почему нет строки date?
Потому что страница не назвала дату там, где её ищут. Порядок такой: сначала datePublished в JSON-LD, затем метатеги – article:published_time, citation_date, citation_publication_date и несколько менее распространённых, – и только потом элемент time с атрибутом datetime.
Если ни один источник не сработал, строки date нет. Подставить день клипа было бы удобнее и хуже: неверная дата в обзоре не перепроверяется, потому что выглядит заполненной.
Почему в поле author оказалось не имя?
Такое бывает редко: имя проходит через фильтр по форме, а не по списку сайтов. Отсекаются подписи кнопок, названия площадок, строки, начинающиеся с даты, и служебные приписки вроде «[Submitted on …]», которыми препринты открывают блок автора. Хвост плашки режется по словам «фото», «источник», «опубликовано». Если поле всё-таки заполнено неверно, значит, страница называет так самого автора, – поправьте вручную, файл ваш.
Почему при клипе выделения пропали номера сносок?
Потому что определения остались за границей выделения. Маркер сопоставляется с целью по идентификатору ссылки, и когда цели в клипе нет, ссылка вела бы в пустоту – такой маркер убирается вместе с надстрочным знаком. Нужны сноски – клипайте страницу целиком, а лишнее уберёте потом в редакторе, где это займёт секунды и не тронет остальной текст.
Почему стоит дата обновления, а не публикации?
Дата обновления вместо даты публикации бывает на сайтах, которые не отдают дату публикации ни одним из основных способов, но объявляют og:updated_time. Он стоит последним в очереди и берётся, только когда всё остальное пусто. Отличить это можно по самой дате: если она подозрительно свежая для старой статьи, значит, взято именно обновление, а не первая публикация материала.
Чего Clean Web Clipper не делает за менеджер ссылок?
Clean Web Clipper не собирает библиографическую запись: ни BibTeX, ни RIS, ни ГОСТ – фронтматтер отдаёт сырые поля, а оформление остаётся делом вашего менеджера ссылок. Он не скачивает PDF статьи, а снимает ту HTML-страницу, что перед вами. Он не угадывает отсутствующую дату, а на части корпусов даты не бывает часто – это свойство сайтов, а не извлечения. Формулы, нарисованные картинками, картинками и остаются, то есть ссылками на исходный сайт.
Для учебных материалов, а не статей, есть страница для студентов.
Какие данные сохраняет заметка?
А если на странице нет даты публикации? Тогда строки date нет. Подставить день клипа было бы хуже: так в заметках молча заводится неверная дата, и ничто потом об этом не напомнит.
Работают ли сноски после клипа?
Можно ли снять статью, закрытую институциональным доступом?
Заменяет ли это Zotero?
Можно ли взять только нужный раздел?
Что с датами, сносками, PDF и формулами?
Откуда берётся дата, если метатегов несколько? Из первого сработавшего источника в фиксированном порядке: JSON-LD, затем метатеги во главе с article:published_time и citation_date, затем time[datetime]. Эвристик по тексту страницы нет – дату из абзаца расширение не вычитывает.
Что происходит с датой в виде числа?
2024/03/07 и полный ISO приводятся к одному виду; значение с годом за пределами промежутка с 1990 по 2100 отбрасывается как заведомо неверное.