Кому это · ·
Страница в Markdown для ChatGPT без меню и подвала сайта
Страница в Markdown для ChatGPT приходит без меню и подвала: Clean Web Clipper снимает обвязку сайта до того, как текст попадёт в чат, и контекст не тратится на навигацию. На корпусе из 109 страниц расширение оставило 102 повтора навигации против 282, 478 и 491 у трёх сравниваемых движков. Фронтматтер называет адрес источника и дату публикации.
Откуда эти цифры: страница замера с версиями движков и датами
Во что обходится вставленная страница?
Страница, вставленная в чат целиком, приносит с собой всё, что её окружало. Главное меню, повторённое в каждой секции, плашка про куки, список «Читайте также», подвал с тридцатью юридическими ссылками – это контекст, за который вы платите и который модель обязана разобрать прежде, чем взяться за дело. На длинном документе этой доли хватает, чтобы вытолкнуть за окно половину текста, который был важен.
Дальше это видно по ответам. Модель цитирует пункт меню так, будто это заголовок раздела, путает две статьи, потому что «Читайте также» приклеил чужие заголовки к тексту, или ставит документу дату из подвала. Дать вместо текста ссылку не спасает: многие модели до страницы не достучатся, а те, что достучатся, часто получат версию для бота, а не ту, что читали вы.
Отдельная история начинается, когда в один разговор кладут не одну страницу, а пять. Обычное копирование из браузера сплющивает документ: уровни заголовков пропадают, и пять источников сливаются в одну простыню без швов. Модель перестаёт отличать, где кончился первый документ и начался третий, и в ответе появляются утверждения, собранные из двух разных статей.
Что получает модель?
- Вчетверо меньше повторов навигации, чем в среднем у сравниваемых движков
- Ни одного остатка HTML на 512 замеренных страницах – модели не приходится обходить случайную разметку
- Фронтматтер прямо называет адрес источника и дату публикации, вместо того чтобы оставлять их на угадывание
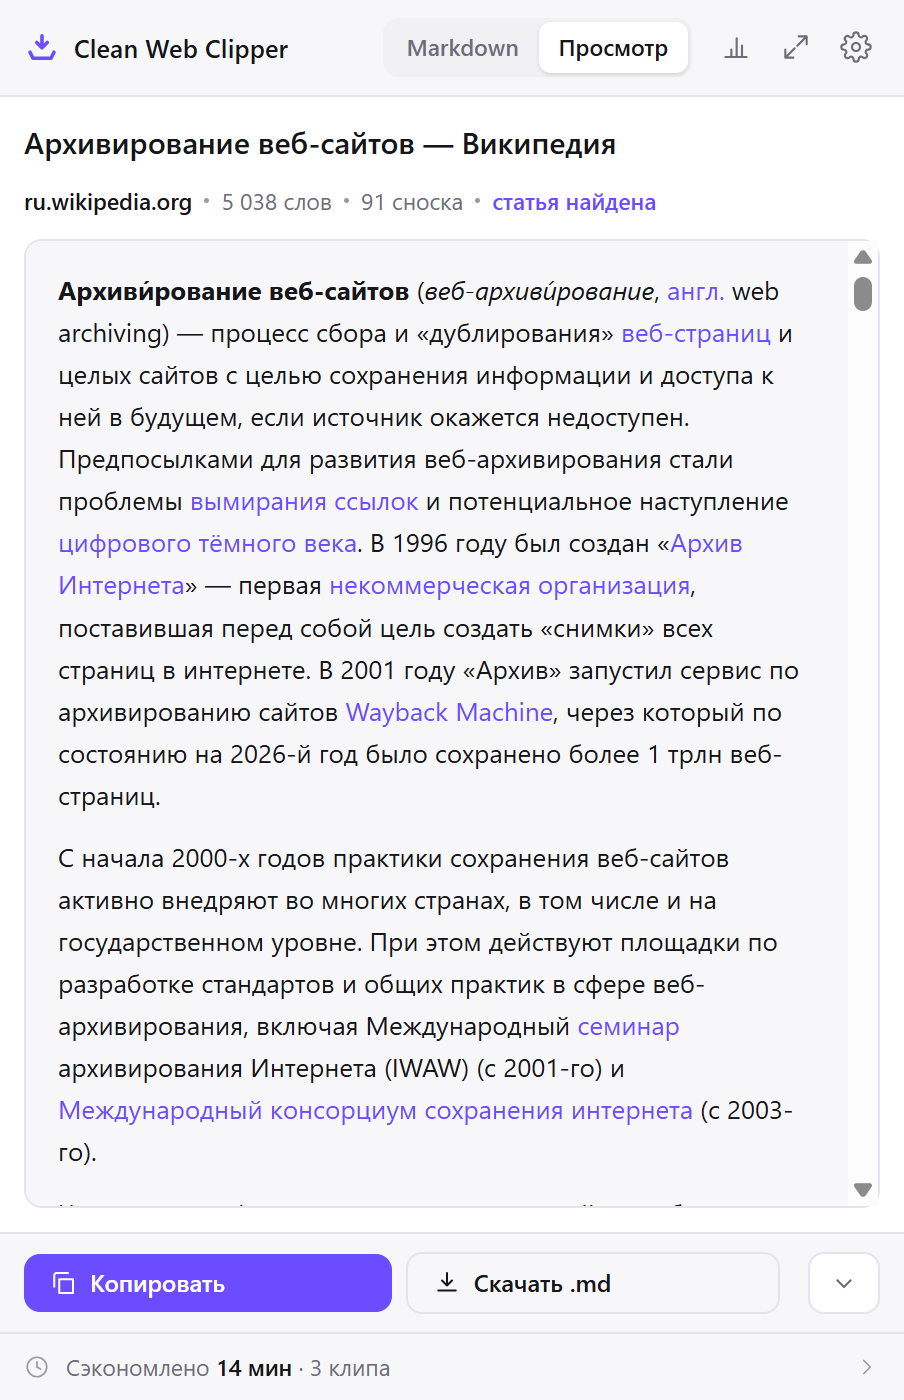
- Одна горячая клавиша копирует страницу в Markdown, готовый к вставке в любой чат
- Картинки отключаются настройкой – из текста уходит ещё пачка бесполезных ссылок
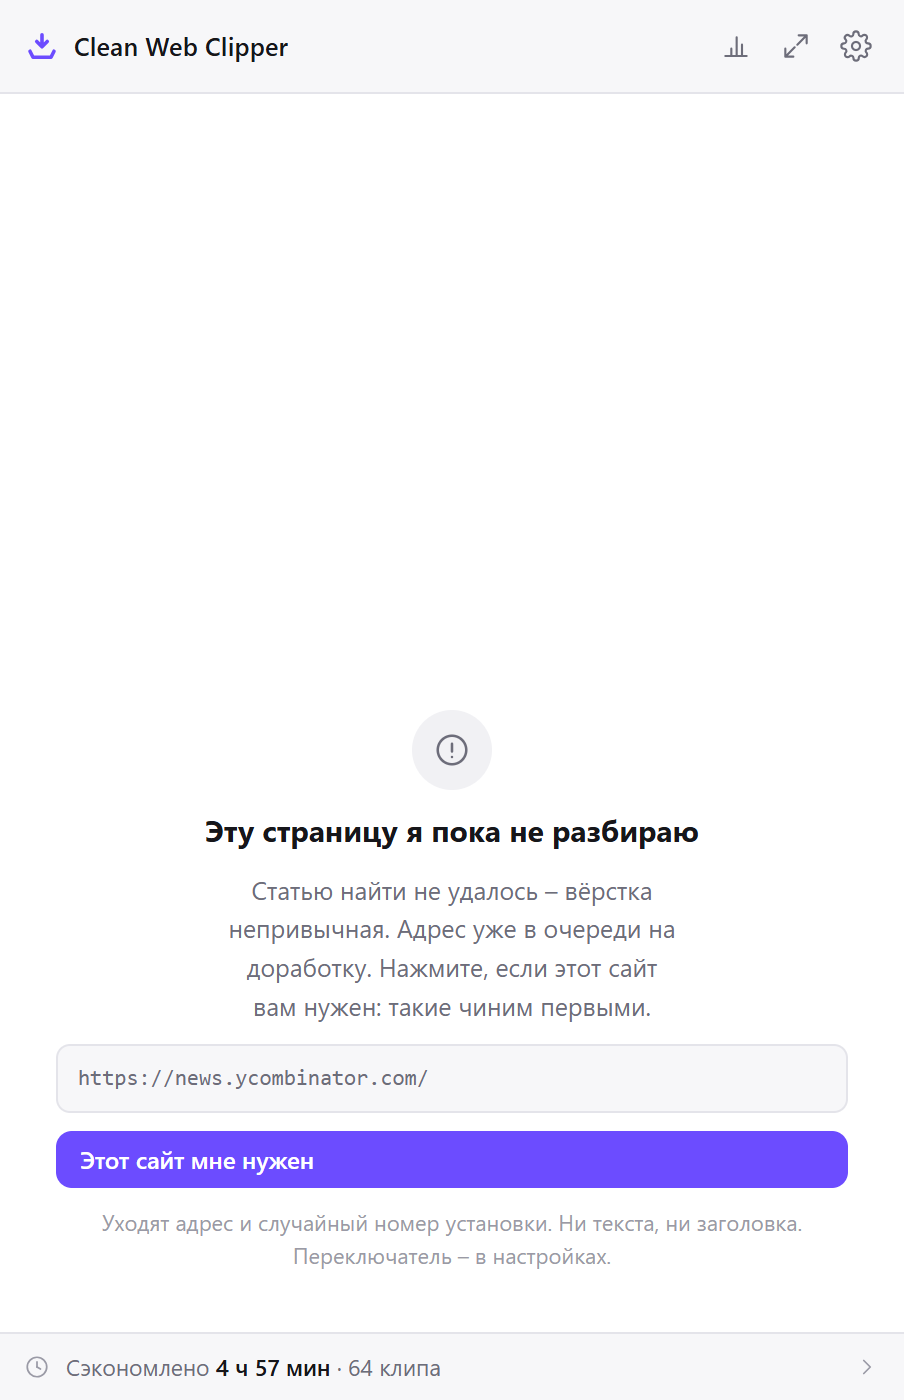
- На странице без статьи – витрина, лента, поиск – расширение так и скажет вместо трёхсот ссылок
- Заголовки приходят уровнями
#,##,###– модель видит структуру документа, а не плоский текст - Строки, повторяющиеся по странице, схлопываются: одно и то же меню не приезжает по разу на каждую секцию
---
title: "Налоговый вычет за обучение"
source: "https://www.gosuslugi.ru/help/faq/nalogovye_vychety"
extraction: "dom"
---

Вычет можно заявить и за своё обучение, и за обучение детей до 24 лет,
если они учатся очно.

## Какие документы понадобятся
Как готовить страницу для модели
Настройка занимает минуту и после неё повторяется одно движение: горячая клавиша, потом вставка в чат. Смысл в том, чтобы решение «что выкинуть» принималось один раз в настройках, а не на каждой странице.
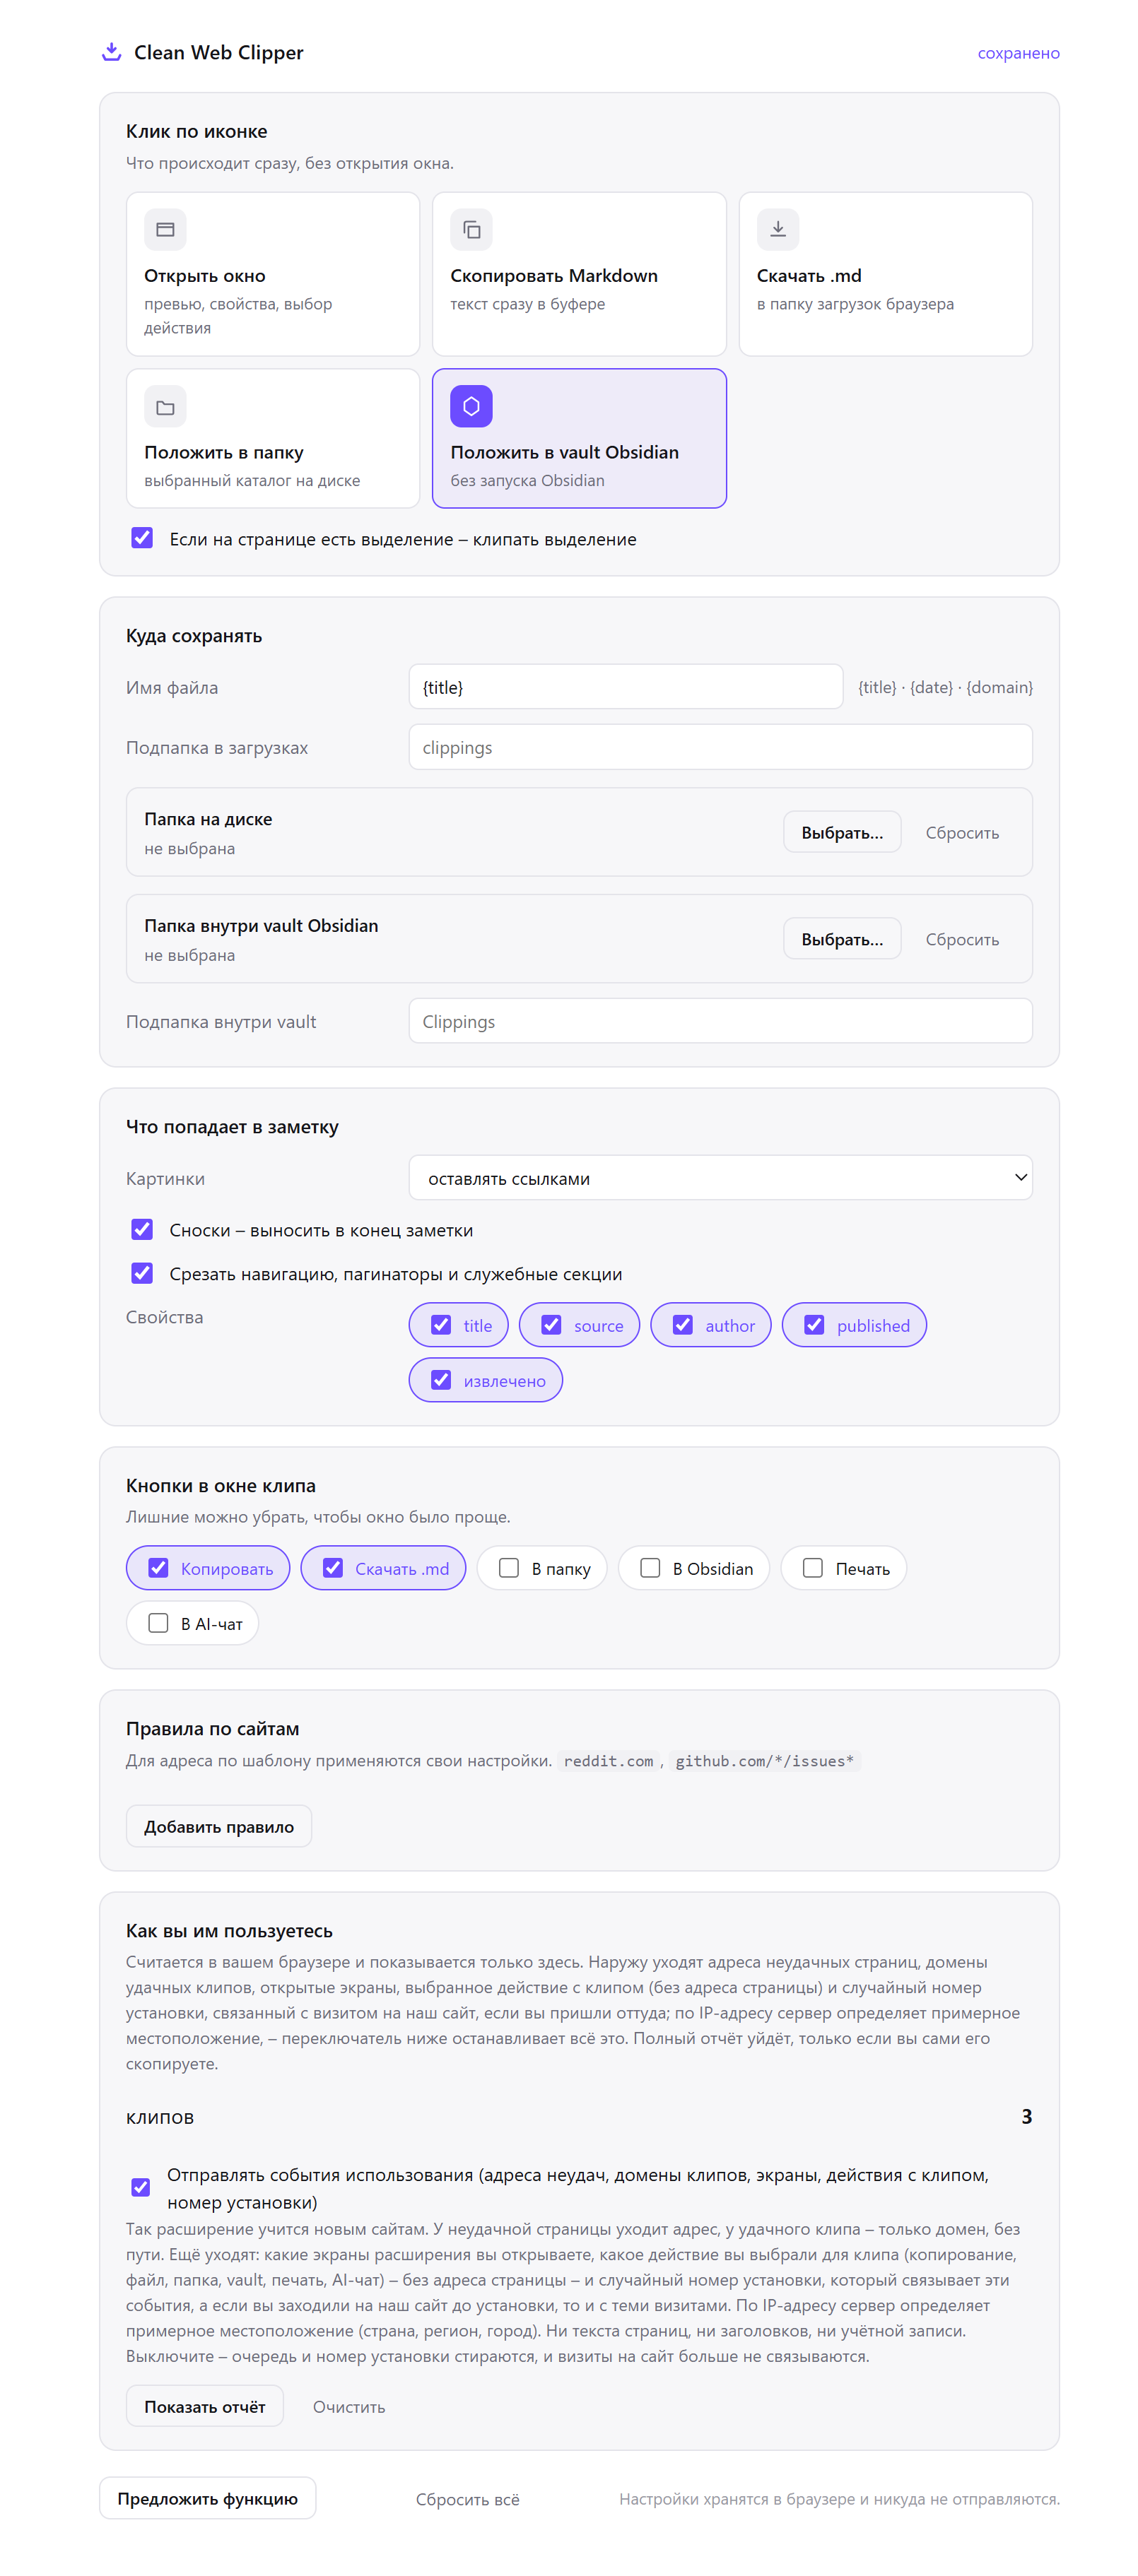
- В настройках, в разделе «Клик по иконке», выберите «Скопировать Markdown». Дальше Alt+Shift+M кладёт готовый текст в буфер, а окно не открывается вовсе – на длинной статье это заметная разница по времени.
- В разделе «Что попадает в заметку» переключите картинки в режим «пропускать». Модель по ссылке изображение всё равно не откроет, а каждая такая ссылка занимает место в контексте наравне с текстом.
- Там же откройте «Свойства» и оставьте
title,sourceиpublished. Три строки в начале файла дают модели атрибуцию сразу и снимают вопрос «откуда это» – гадать по домену в середине текста ей не придётся. - Если чат у вас всегда один и тот же, включите кнопку «В AI-чат» в разделе «Кнопки в окне клипа». Она копирует текст и открывает вкладку чата одним движением; сам текст расширение никуда не отправляет.
- На статье нажмите Alt+Shift+M и вставьте текст в чат. Первые строки вставленного – фронтматтер с адресом и датой: по ним сразу видно, что уехало не полстраницы и не витрина вместо статьи.
- Когда источников в разговоре несколько, сохраняйте их в папку и прикладывайте файлами, а не вставляйте подряд. Имя файла тогда работает границей между документами, и модель не склеивает два источника в один.
Какие настройки экономят контекст модели?
Настройки ниже оптимизируют одно – долю полезного текста в том, что уходит в контекст. Всё, что нельзя ни прочитать, ни процитировать, здесь выключено.
| Настройка | Значение | Почему именно так |
|---|---|---|
| Клик по иконке | Скопировать Markdown | путь до чата и так короткий, окно превью на нём лишний шаг |
| Картинки | пропускать | ссылку на изображение модель не откроет, а место в контексте она занимает как обычный текст |
| Свойства | title, source, published | атрибуция в первых строках стоит десяток токенов и снимает целый класс ошибок в ответах |
| Сноски | выносить в конец заметки | номер посреди фразы разрывает предложение, на котором модель строит ответ; в конце они ей не мешают |
| Срезать навигацию | включено | это и есть тот самый выигрыш: 102 повтора строк меню против 282, 478 и 491 у сравниваемых движков |
| Кнопка «В AI-чат» | включена | копирование и открытие вкладки одним нажатием – когда чат всегда один и тот же |
| Имя файла | {domain}-{title} | если источники прикладываются файлами, имя становится границей между документами |
---
title: "Жизненные ситуации – Госуслуги"
source: "https://www.gosuslugi.ru/situation"
extraction: "no-article"
---
Пройти три сценария целиком
Три сценария показывают, что уходит в модель на практике: разбор длинного регламента без обвязки вокруг нужного пункта, пять источников файлами в одном разговоре и страница за вашим собственным логином, до которой модель сама не дотянется. В каждом – реальная задача, а не иллюстрация возможностей расширения, и в каждом важно не то, что текст доехал, а сколько лишнего контекста при этом не приехало вместе с ним.
Разбор длинного регламента
Перед вами страница на сорок тысяч знаков, и нужен ответ на один вопрос: попадает ли ваш случай под исключение из пункта 12. Вставлять её целиком вместе с меню, подвалом и лентой «Читайте также» – значит потратить контекст на то, что к вопросу не относится.
Alt+Shift+M даёт тот же документ без обвязки, с сохранёнными уровнями заголовков. Модель видит, что пункт 12 – это ### внутри раздела ##, и отвечает про него, а не про соседний. Если регламент понадобится ещё раз, тот же файл лежит в папке: переклипать страницу второй раз не нужно.
Пять источников в одном разговоре
Вы собираете сравнение и хотите, чтобы модель работала по пяти конкретным страницам, а не по своим воспоминаниям. Каждую клипаете и сохраняете в папку с именем по шаблону {domain}-{title}, после чего прикладываете пять файлов разом.
У каждого файла в первых строках свой адрес и своя дата публикации, поэтому на просьбу «скажи, где это написано» приходит ссылка на конкретный источник, а не усреднённый пересказ. Пересказывать и сокращать расширение при этом ничего не стало: в файле лежит текст статьи, а выжимка осталась работой модели.
Вопрос по странице, которая открыта под вашим логином
Внутренняя вики, личный кабинет, статья по подписке – до всего этого модель по ссылке не доберётся, а если доберётся, увидит страницу входа. Клип снимает то, что браузер отрисовал уже после вашей авторизации.
Дальше текст идёт в чат через ваш буфер обмена: склипанный текст расширение никуда не загружает. На наш сервер статистики уходят только события – голый домен удачного клипа, адрес страницы, где статья не нашлась, открытый экран, выбранное действие без адреса и случайный номер установки, – и один переключатель в настройках их останавливает. Решение, что именно показывать модели, остаётся вашим и принимается на каждой странице отдельно.
Чем это отличается от привычных способов?
Страницу в чат затаскивают пятью способами. Разница между ними – не в удобстве, а в том, сколько мусора приезжает вместе с текстом и что с ним делает модель.
| Способ | Что получается | Чего стоит |
|---|---|---|
| Выделить всё и вставить в чат | быстро, ничего не надо ставить | меню, плашки и подвал уезжают в контекст, уровни заголовков теряются |
| Дать модели ссылку | один короткий запрос | многие модели до страницы не дойдут, остальные часто получат версию для бота, а страницу за логином – никто |
| Печать в PDF и приложить файлом | страница целиком, как на экране | колонтитулы и разрывы страниц попадают в текст, а таблица разъезжается по двум листам |
| Другое расширение-клиппер | текст без части обвязки | на том же корпусе из 109 страниц у сравниваемых движков осталось 282, 478 и 491 повторённых строк меню против наших 102 |
| Пересказать своими словами | коротко и по делу | модель работает с вашим пересказом, а не с источником, – и цитировать ей нечего |
| Clean Web Clipper | текст статьи в Markdown, с адресом и датой в первых строках | одна страница за раз; выжимку и подсчёт токенов он на себя не берёт |
Что делать, если модель отвечает не о том?
Здесь – ответы на случаи, когда контекст модели пришёл не таким, как ожидалось: меню, принятое за заголовок, шапка вместо статьи, недогруженный текст и уцелевшие ссылки на картинки. Почти все они решаются одной настройкой или повторным клипом, а не переустановкой расширения или сменой модели, и почти всегда причина видна прямо в начале вставленного текста.
Почему модель цитирует пункт меню как заголовок раздела?
Значит, меню доехало до контекста. Проверьте, что в настройках включено «Срезать навигацию, пагинаторы и служебные секции», и посмотрите на начало вставленного текста: если там «Главная», «Войти», «Все разделы», в чат уехала не та часть страницы.
Обратите внимание и на выделение: то, что вы выделили сами, срезке не подвергается вовсе – расширение считает, что человек выбрал осознанно. Выделяйте текст статьи, а не всё подряд с шапкой.
Почему вместо статьи пришла одна шапка с адресом?
Шапка с адресом вместо статьи – это честный отказ. Если тела статьи на странице не нашлось или больше четверти текста приходится на подписи ссылок, расширение отдаёт фронтматтер и ставит в поле extraction значение no-article. Витрины, ленты и страницы поиска попадают под это правило постоянно – и отдать вместо них триста ссылок было бы хуже. Клипайте страницу самого материала.
Почему текста меньше, чем на странице?
Чаще всего страница догружает текст по мере прокрутки, а склипано то, что было отрисовано в момент нажатия. Долистайте до конца и склипайте заново – кнопка «Склипать заново» есть прямо в окне.
Второй случай – поле extraction со значением jsonld-articlebody. Это означает, что в структурированных данных страницы лежало тело статьи заметно длиннее видимого, и взято было оно. Тогда текста, наоборот, обычно больше, а не меньше.
Почему в тексте остались ссылки на картинки?
Потому что режим картинок по умолчанию – «оставлять ссылками». Переключите его на «пропускать»: тогда из вывода убираются и сами изображения, и разметка вида , которая приезжает из вложенных примеров кода на странице. В контексте после этого не остаётся ни одной ссылки на изображение, и модель не тратит внимание на то, что не может открыть.
Чего Clean Web Clipper не делает за модель?
Clean Web Clipper не пересказывает и не переписывает: текст статьи конвертируется, а не правится, – выжимка остаётся работой модели. Он ничего не отправляет в сервисы ИИ сам: текст идёт через ваш буфер обмена, а сам текст никуда не загружается. Он не считает токены и не режет текст на фрагменты за вас. И он не достаёт страницу, которую вы не открыли: краулера и пакетной обработки здесь нет.
Что именно срезается до вставки, показано на странице об устройстве извлечения.
Зачем клипать, а не давать модели ссылку?
Почему не вставить просто адрес и не дать модели открыть его самой? Потому что многие модели до страницы не достучатся, а те, что достучатся, часто получат версию для бота. Клип фиксирует ровно то, что было на экране, включая страницу за логином, под которым вы уже сидели.
Отправляет ли расширение что-нибудь в сервис ИИ?
Сколько контекста это экономит?
Можно ли выкинуть картинки, чтобы сэкономить контекст?
Поймёт ли модель, откуда взят текст?
Что доезжает до модели, а что нет?
Что делать со страницей, которая догружает текст при прокрутке? Долистайте её до конца и только потом клипайте. Берётся то, что отрисовано в момент нажатия: недогруженных абзацев в буфере не окажется, и заметить это по вставленному тексту трудно.
Как отдать модели только один раздел длинной страницы?
Сохраняется ли структура заголовков?
#, ## и ###, как они стоят в теле статьи. Пустые заголовки – частый след навигационных блоков – при этом удаляются, чтобы модель не принимала их за начало нового раздела.