Кому это · ·
Документация в Markdown без доводки
Перенос документации обычно состоит из конвертации HTML, а потом из ещё более долгой уборки того, что конвертер оставил; Clean Web Clipper делает эту уборку сразу, и получается документация в Markdown без доводки: ноль остатков HTML на 512 проверенных страницах и 102 повтора строк меню на 109 из них – против 282, 478 и 491 у сравниваемых движков.
Откуда эти цифры: страница замера с версиями движков и датами
Почему конвертация – ещё не вся работа?
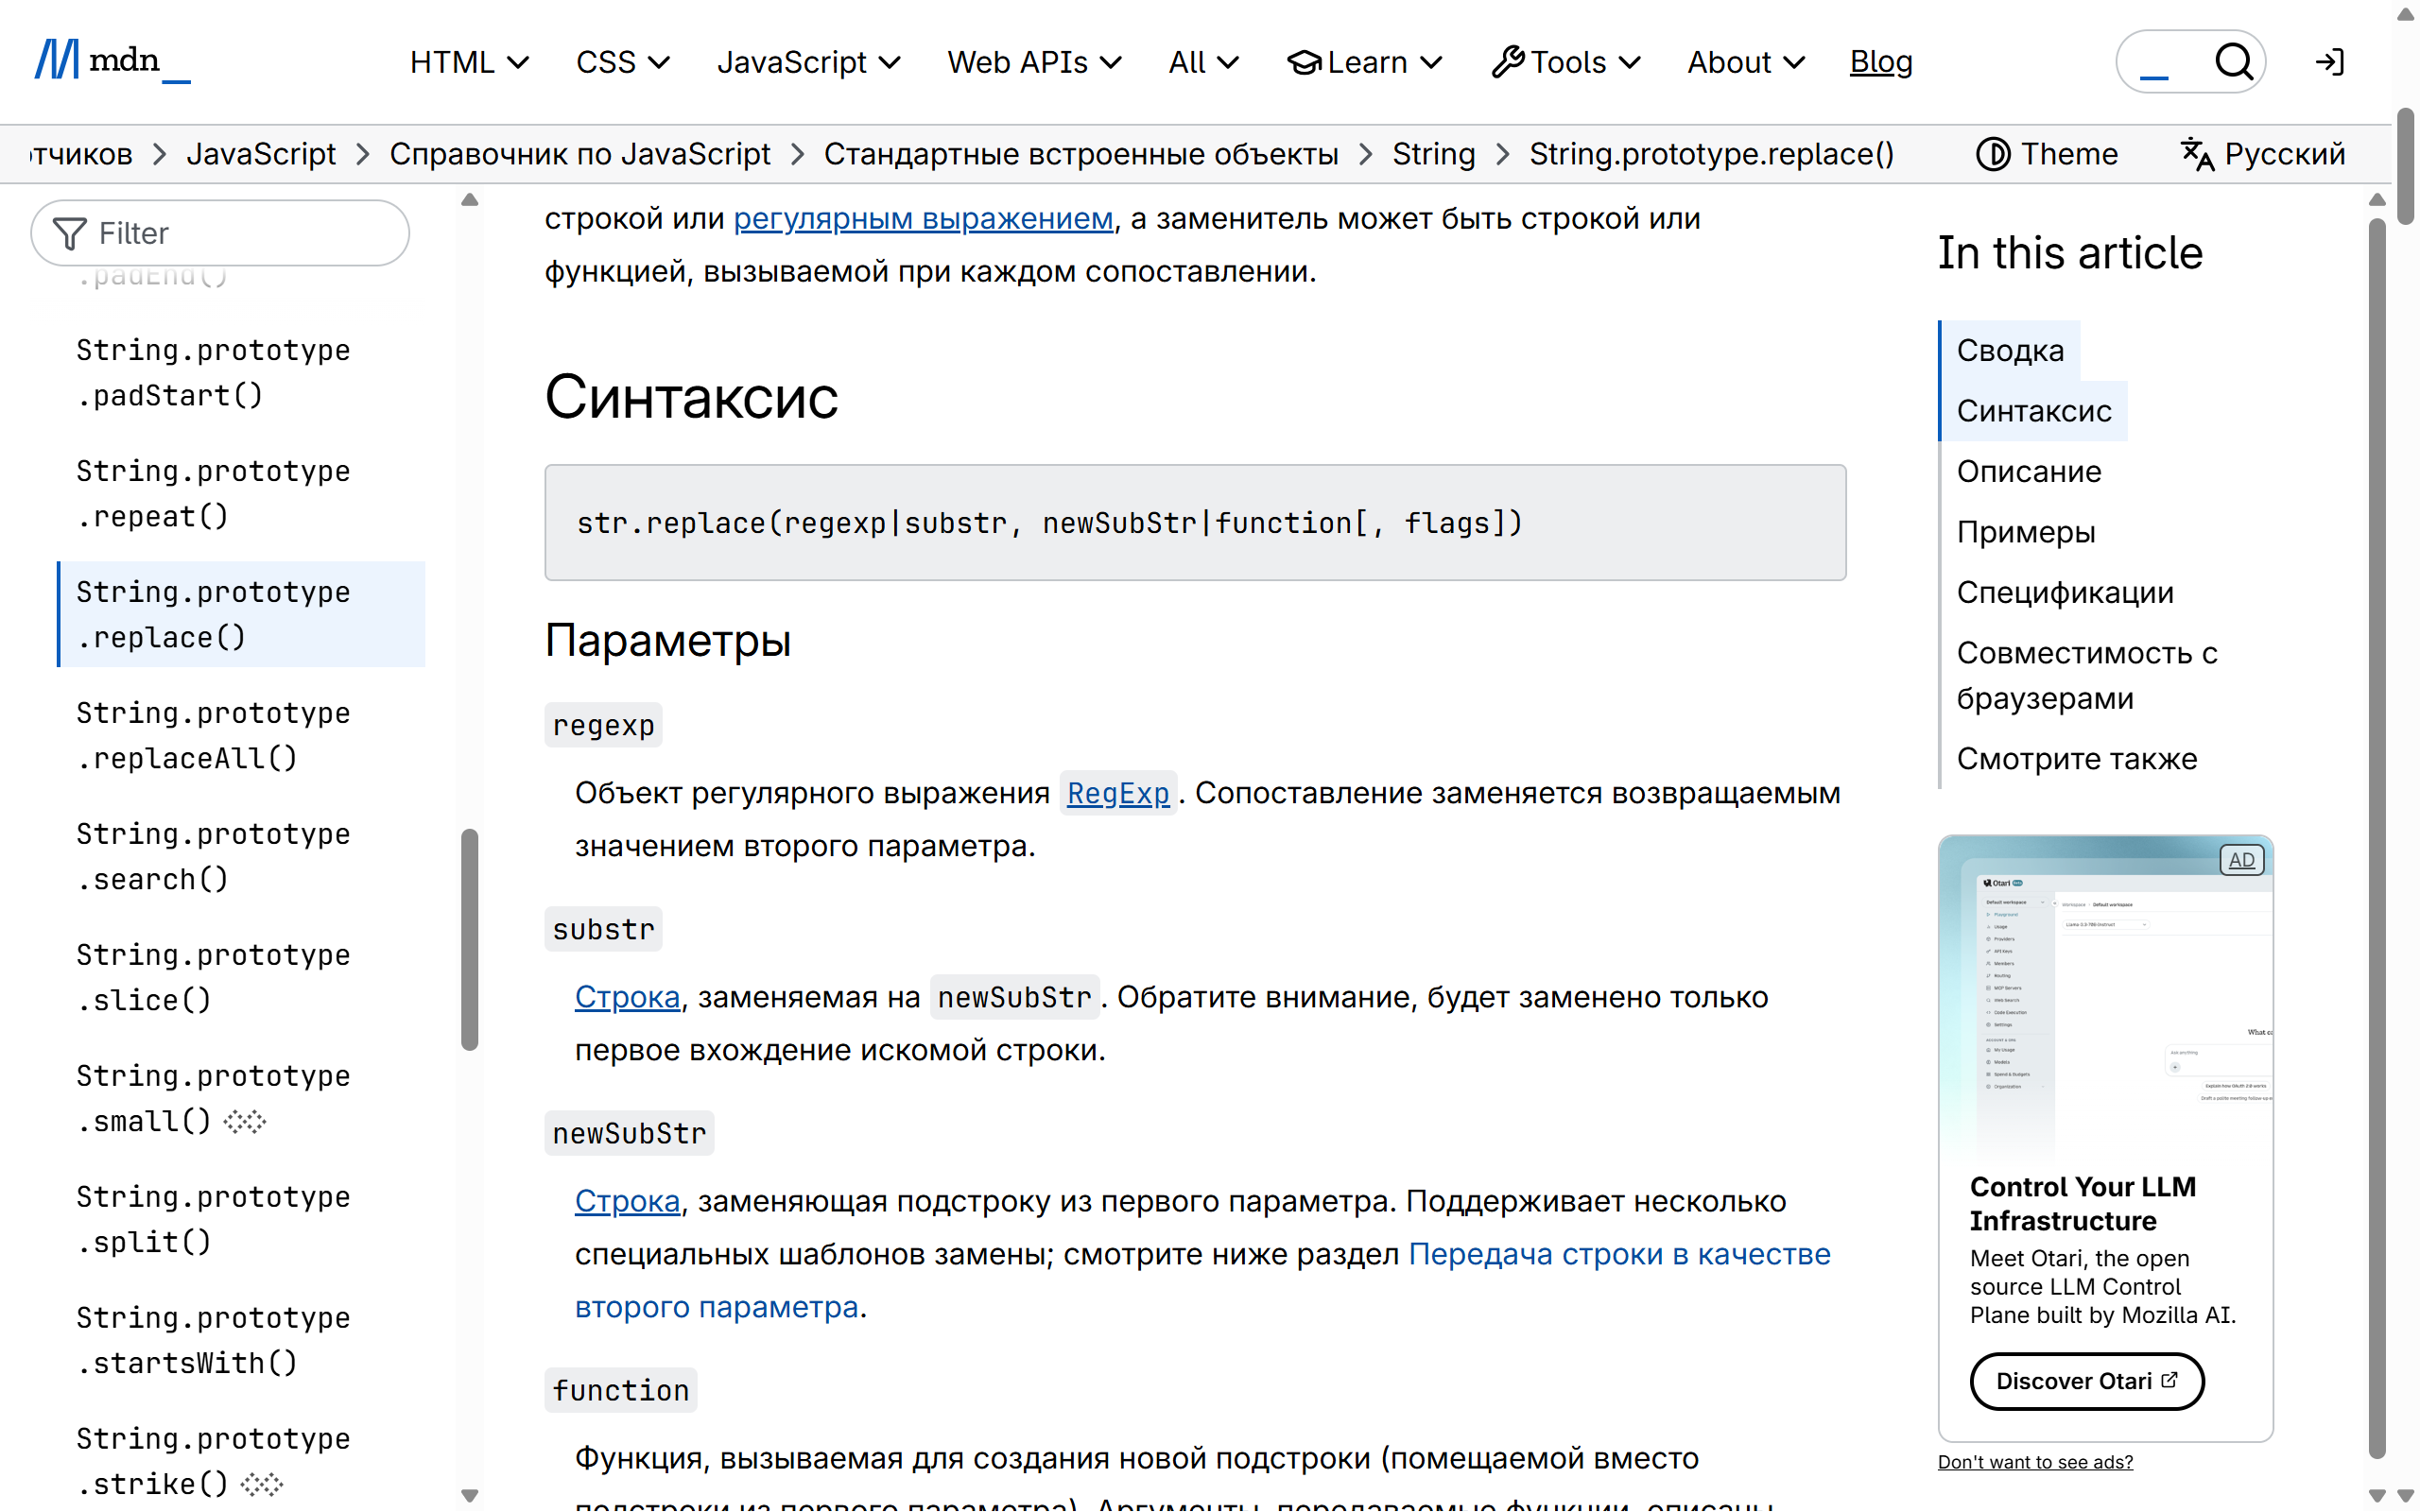
Лёгкая часть переноса – та, на которую все смотрят. Конвертер выдаёт Markdown за несколько секунд, а настоящая работа начинается после: убрать боковое меню, скопированное в каждый файл, переключатель версий, колонку «На этой странице», подвал с юридическими ссылками. На двухстах страницах это не делается ни руками, ни одними регулярками.
Структура тоже не выходит невредимой. Пустые заголовки, оставленные навигационными блоками, создают в оглавлении разделы-призраки, врезки теряют смысл, заборы теряют язык, а таблицы параметров складываются. Импортированная документация вроде бы есть, но перед употреблением её надо перечитать страницу за страницей.
Отдельная потеря – врезки. В исходной документации у них есть тип: примечание, совет, предупреждение, «не делайте так никогда». В Markdown стандартного синтаксиса для них нет, поэтому все они становятся одинаковыми цитатами, и после переноса предупреждение о потере данных выглядит ровно так же, как совет про удобное сочетание клавиш. Восстанавливать тип приходится глазами, по тексту, – на двухстах страницах это отдельная работа, которую никто не закладывает в срок.
Что переносится без потерь?
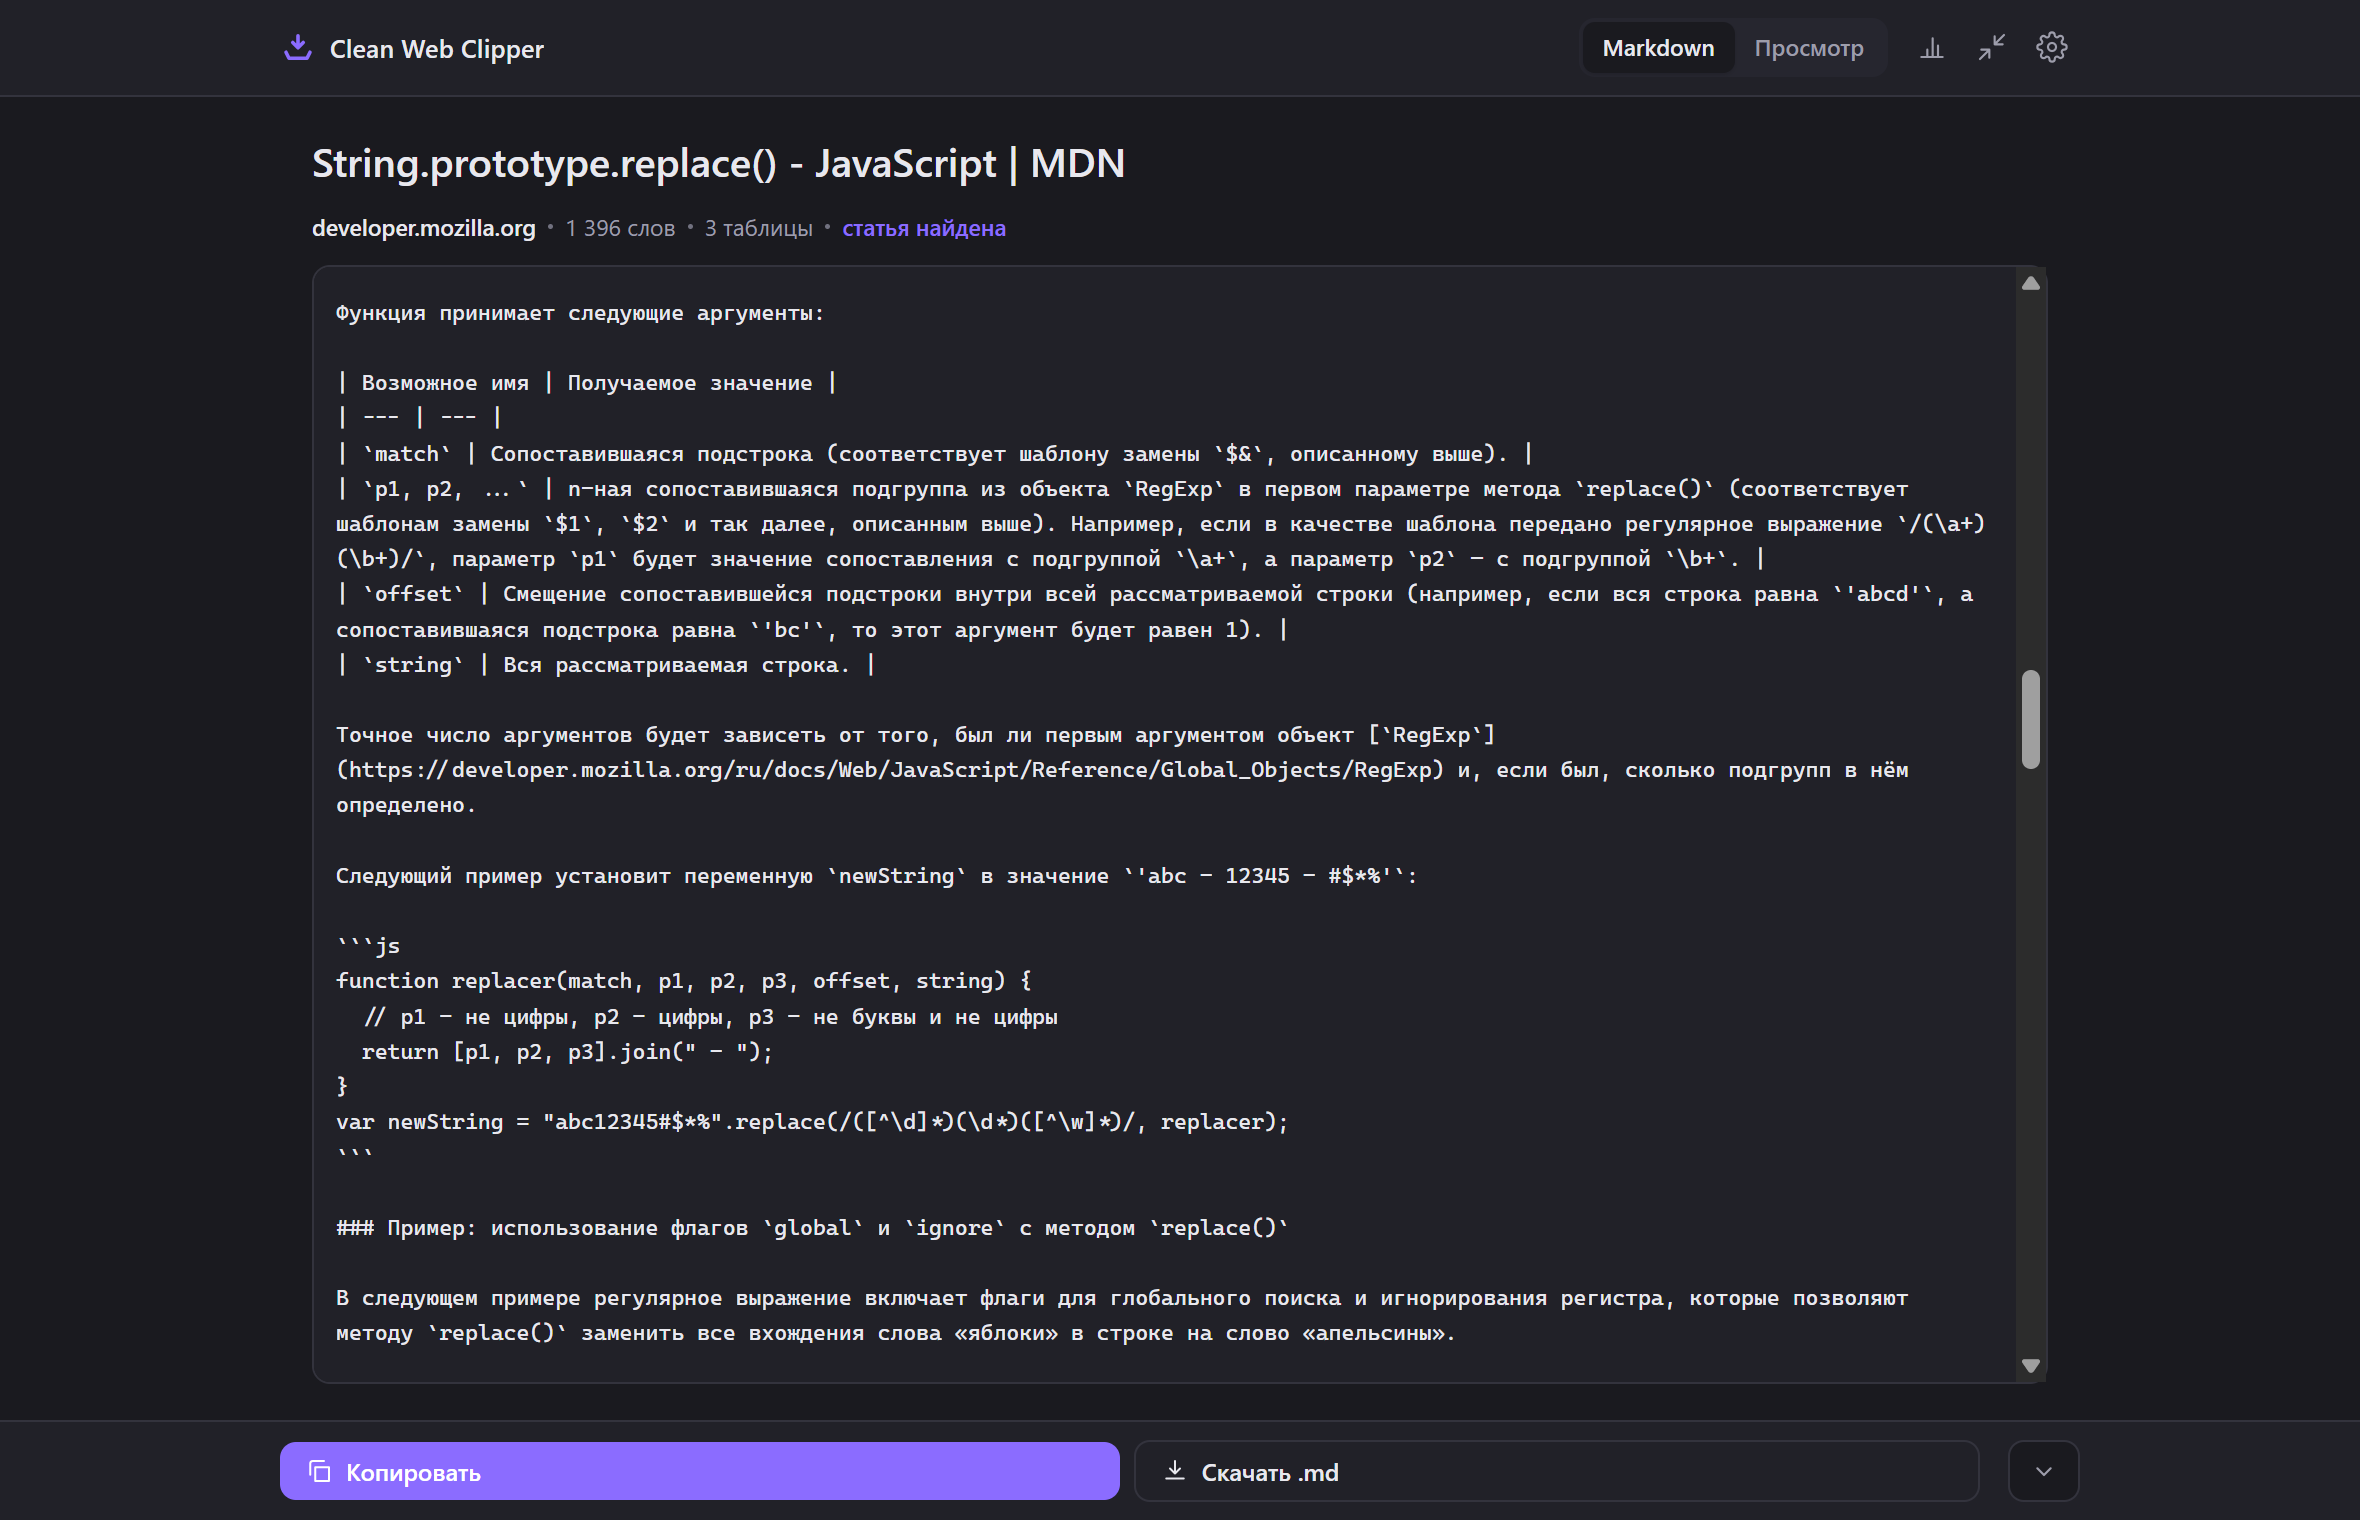
- Заголовки, списки, таблицы, заборы кода и сноски становятся стандартным Markdown
- Метки языка на заборах сохраняются – 73 забора из 156 против 20 из 104 и 0 из 24 у сравниваемых движков
- Ноль остатков HTML на 512 замеренных страницах
- Панели навигации, переключатели версий и колонки «На этой странице» срезаются, а не конвертируются
- Пустые заголовки – частый след навигационных блоков – удаляются
- Шаблон имени файла и подпапка держат перенесённый набор в порядке
- Ссылки достраиваются до абсолютных, а якоря внутри страницы остаются якорями –
#parametersне превращается в чужой адрес - Колонка «На этой странице» и хлебные крошки уходят как идущие подряд строки-ссылки, а одиночная ссылка в абзаце остаётся
---
title: "pathlib – пути файловой системы в объектном стиле"
source: "https://docs.python.org/ru/3/library/pathlib.html"
extraction: "dom"
---

## Основное использование

```python
from pathlib import Path

for file in Path(".").glob("**/*.md"):
    print(file)
```

> Примечание: класс `Path` сам выбирает реализацию под текущую систему.
Как переносить документацию страницами
Перенос – это не одно действие, а двести одинаковых. Настройка ниже нужна затем, чтобы каждое из них состояло из одного нажатия и не требовало решений.
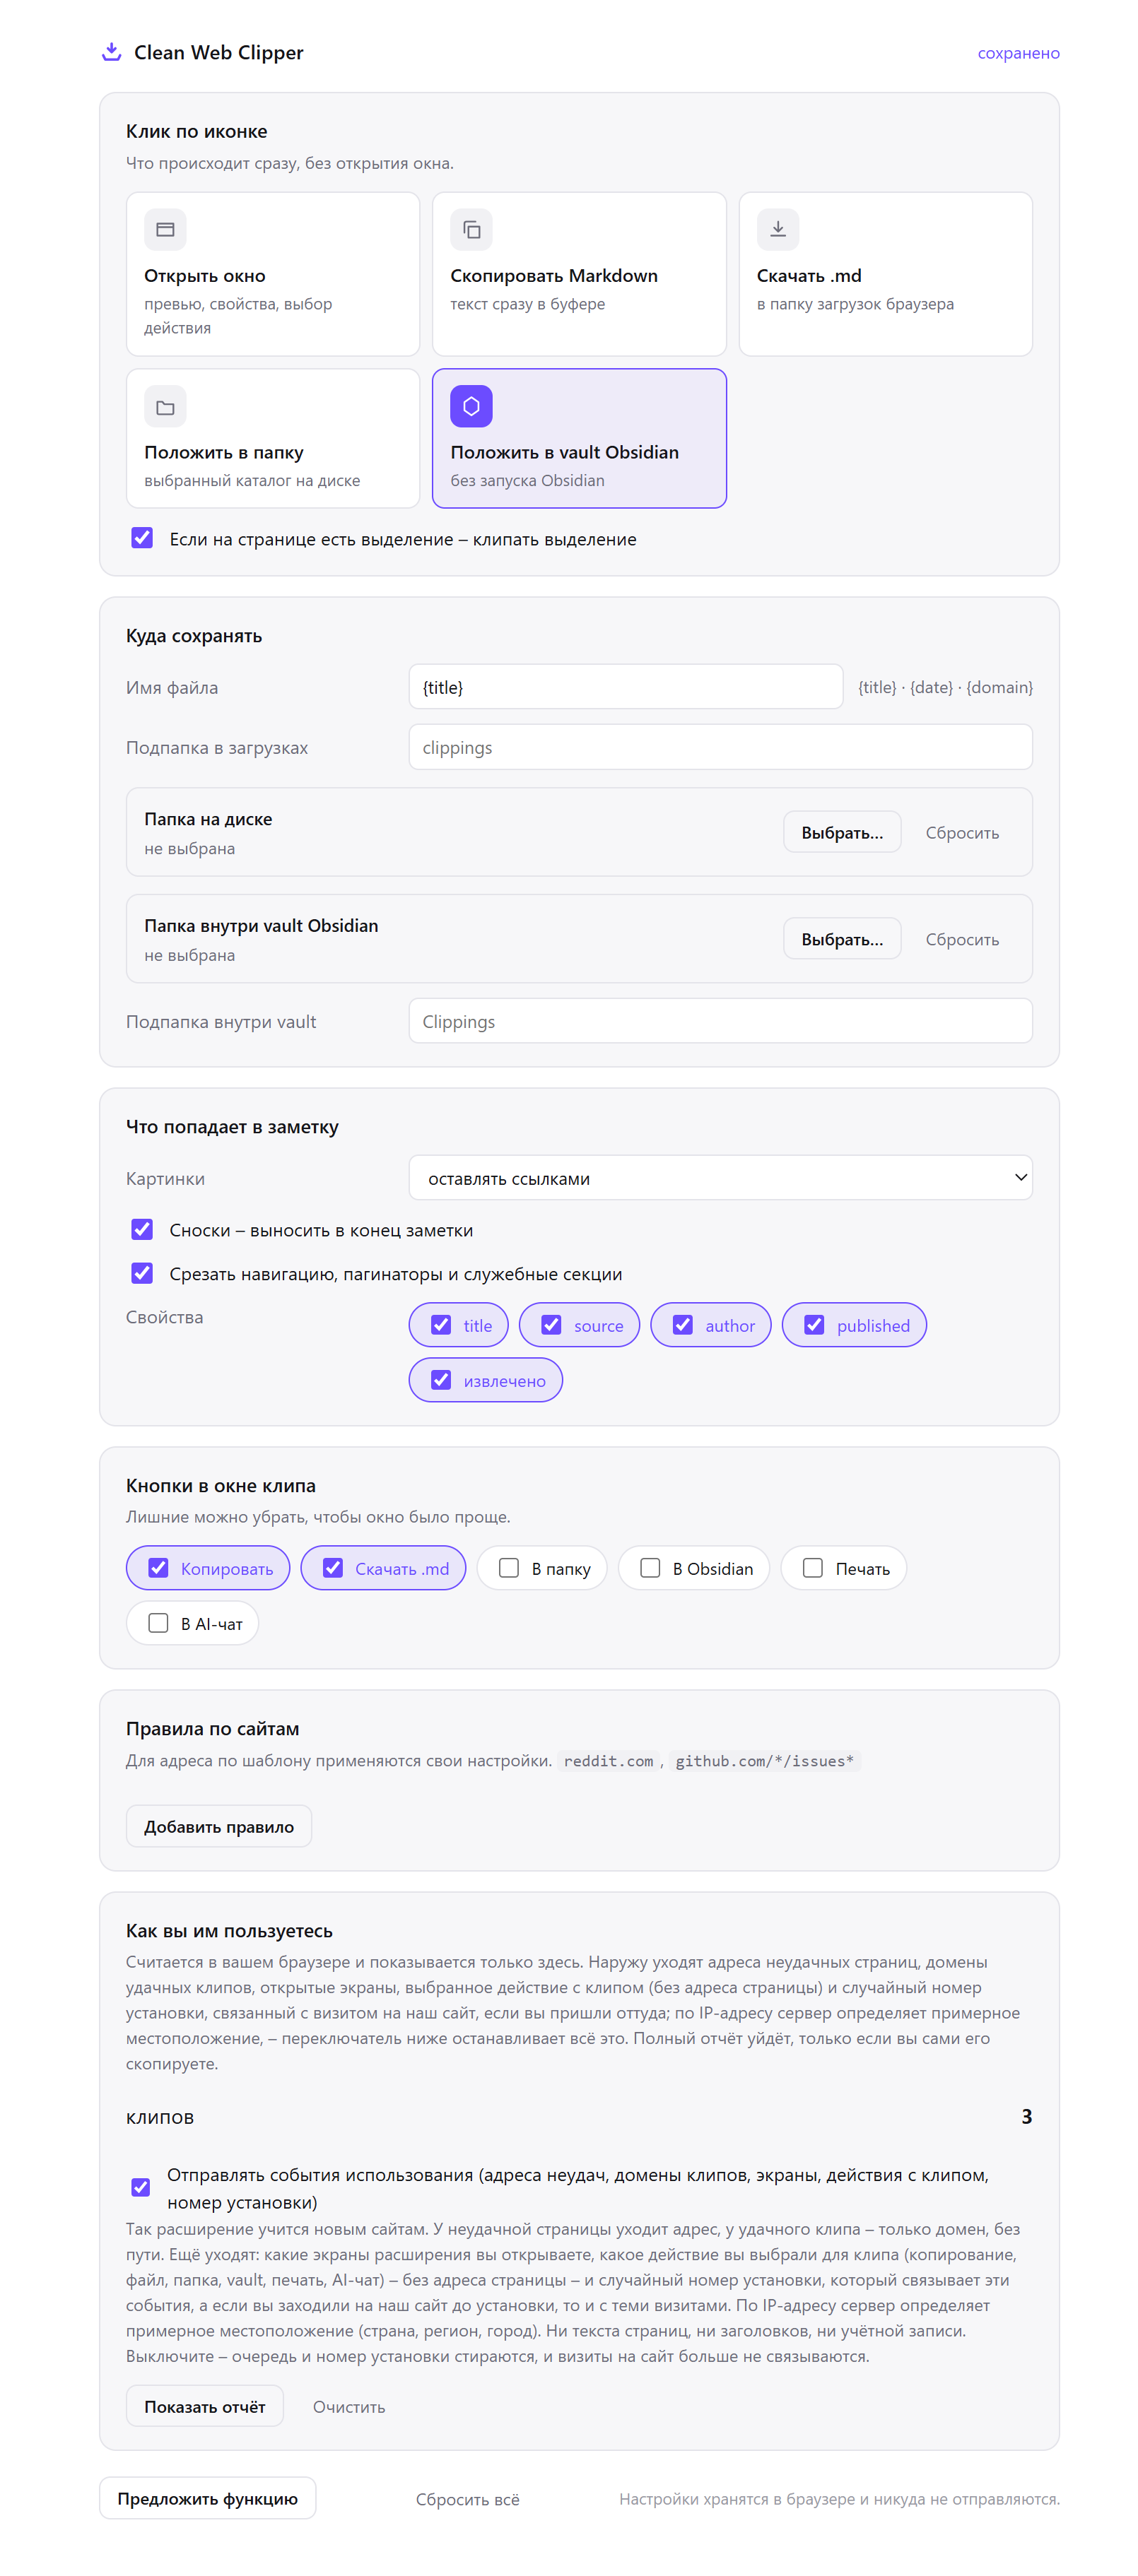
- В настройках, в разделе «Куда сохранять», выберите папку назначения на диске и оставьте шаблон имени
{title}. Имена файлов должны повторять названия разделов – по ним потом собирается оглавление в репозитории. - Переключите «Клик по иконке» на «Положить в папку». На двухстах страницах разница между одним нажатием и тремя – это разница между работой на два дня и работой на неделю.
- Заведите в разделе «Правила по сайтам» правило на домен документации со своей подпапкой. Если разделов несколько, меняйте подпапку по ходу: одна подпапка на раздел избавляет от разбора кучи в конце.
- Идите по оглавлению исходной документации сверху вниз и на каждой странице жмите Alt+Shift+M. Краулера здесь нет: двести страниц – это двести нажатий, зато каждая снимается такой, какой её отрисовал браузер, включая внутреннюю документацию за входом.
- Раз в двадцать страниц открывайте последний файл и смотрите на заборы кода и таблицы. Метки языка стоят там, где их объявила исходная страница: на замеренном корпусе метка пережила клип в 73 заборах из 156 против 20 из 104 и 0 из 24 у двух сравниваемых движков.
- После переноса пройдитесь по набору поиском по
](http, чтобы найти ссылки на исходный сайт. Они остались абсолютными намеренно – переписывать их под структуру вашего репозитория расширение не берётся, и это единственный шаг, который придётся делать отдельно.
Какие настройки подходят для переноса документации?
Набор рассчитан на однообразную работу в один заход. Всё, что требует решения на каждой странице, из него убрано заранее.
| Настройка | Значение | Почему именно так |
|---|---|---|
| Клик по иконке | Положить в папку | двести страниц – двести нажатий; окно превью умножает работу втрое |
| Имя файла | {title} | имена файлов повторяют названия разделов, и оглавление в репозитории собирается по ним |
| Правила по сайтам | по правилу на раздел документации | раскладка по подпапкам в момент сохранения дешевле разбора общей кучи в конце |
| Картинки | оставлять ссылками | ссылка отмечает место схемы в тексте; сами файлы всё равно придётся собрать отдельно |
| Сноски | выносить в конец заметки | в спецификациях примечаний много, и в конце файла они не рвут абзац |
| Свойства | title, source | source – единственный способ через месяц найти исходную страницу для сверки |
| Срезать навигацию | включено | на сайтах документации навигация занимает больше места, чем сам раздел |
---
title: "shutil – операции с файлами высокого уровня"
source: "https://docs.python.org/ru/3/library/shutil.html"
extraction: "dom"
---

## shutil.copytree

> Предупреждение: даже высокоуровневые функции копирования не переносят
> все метаданные файла.

| Аргумент | По умолчанию | Что делает |
| --- | --- | --- |
| `symlinks` | `False` | копирует цель ссылки, а не саму ссылку |
| `dirs_exist_ok` | `False` | разрешает писать в существующий каталог |
Пройти три сценария целиком
Три сценария показывают перенос документации на разном масштабе: двести страниц с закрывающейся платформы за два дня, сверка терминов с документацией смежной команды за корпоративным входом и черновик по чужому руководству поставщика. В каждом важна не скорость конвертации, а то, что остаётся читаемым после неё, без ручной доводки каждого файла и без потери структуры документа, которую видел исходный сайт.
Двести страниц за два дня
Документация переезжает с закрывающейся платформы, экспорта нет, доступ к базе никто не даст. Вы настраиваете папку, шаблон имени и правило на домен, а дальше идёте по оглавлению сверху вниз, нажимая одну и ту же клавишу.
На выходе двести файлов с одинаковой схемой имён, сохранёнными уровнями заголовков и таблицами параметров. Пустые заголовки, которые оставляют навигационные блоки, удалены – разделов-призраков в оглавлении не появится. Остаётся ручная работа: переписать внутренние ссылки и разобраться, какие врезки были предупреждениями.
Сверка терминов с документацией смежной команды
Вам нужно понять, как соседний отдел называет те же сущности, но их документация живёт за корпоративным входом. Клип снимает страницу, которую браузер отрисовал после вашей авторизации, – внутренние страницы клипаются так же, как публичные.
Двадцать файлов в папке ищутся полнотекстовым поиском, и расхождение в терминах видно за один запрос. Сам текст при этом никуда не уходит: внутренние документы остаются на вашем диске, и их содержимое браузер не покидает.
Черновик своей страницы по чужому руководству
Вы пишете раздел про интеграцию и опираетесь на официальное руководство поставщика. Выделяете нужный кусок с примерами, клипаете выделение – к нему не применяется ни срезка, ни отказ «статьи нет» – и вставляете в черновик.
Заборы приезжают с метками, поэтому подсветка в вашем движке документации включается сразу. Текст при этом не переписан и не пересказан: конвертация структурная, и что из чужого руководства можно использовать, а что нельзя, решаете вы.
Чем это отличается от привычных способов?
Перенос делают пятью способами, и выбор между ними – это выбор между масштабом и качеством. Строчка про скрипт честно признаёт, где он сильнее.
| Способ | Что получается | Чего стоит |
|---|---|---|
| Скрипт-краулер плюс конвертер | обходит сайт целиком и без вашего участия | страницу за логином и сайт на JavaScript он обычно не возьмёт, а обвязку срезает общими правилами |
| Универсальный конвертер HTML в Markdown | быстро и на любом объёме | меню, переключатель версий и колонка «На этой странице» копируются в каждый файл, а заборы теряют язык |
| Экспорт из исходной системы | самый точный результат из возможных | бывает не у всех платформ, а на закрывающейся – как раз обычно и не бывает |
| Копировать в редактор вручную | полный контроль над каждой страницей | на двухстах страницах это недели, и структура всё равно расползается от файла к файлу |
| Печать страниц в PDF | сохраняется вид документации | в репозиторий такое не положишь, и ни поиск, ни сравнение версий по нему не работают |
| Clean Web Clipper | ноль остатков HTML на 512 замеренных страницах, заборы с метками, 12 из 15 таблиц целыми | одна страница за раз; внутренние ссылки и оглавление не пересобираются, врезки становятся цитатами |
Что мешает при переносе?
Ниже – ответы на то, что чаще всего требует ручной доводки после переноса: врезки, ставшие одинаковыми цитатами, забор без метки языка, внутренние ссылки на старый сайт и обзорная страница без тела статьи. Каждый случай – известное ограничение конвертации, а не повод переделывать перенос заново, и структура документа при этом, как правило, остаётся целой, а поправить нужно только то, что и правда требует внимания человека.
Почему все врезки стали одинаковыми цитатами?
Потому что в Markdown нет стандартного синтаксиса для врезок. Примечание, совет и предупреждение выражаются одним и тем же блоком цитаты: содержимое сохраняется, тип – нет.
Восстанавливать тип придётся по тексту. Если ваш движок документации поддерживает свой синтаксис врезок, самый быстрый путь – пройти набор поиском по первому слову внутри цитаты: «Примечание», «Внимание», «Предупреждение».
Почему у части заборов нет метки языка?
Потому что исходная страница её не объявила. Язык читается из атрибутов и классов на самом блоке кода и на двух родителях выше – угадывать по содержимому расширение не станет. На замеренном корпусе метка пережила клип в 73 заборах из 156, против 20 из 104 и 0 из 24 у двух сравниваемых движков: это заметно больше, но не все.
Почему внутренние ссылки ведут на старый сайт?
Потому что они достроены до абсолютных – намеренно. Так ссылка из перенесённого файла открывается, а не ломается. Якоря внутри страницы при этом остаются якорями: #parameters не превращается в чужой адрес. Переписать ссылки под структуру репозитория – отдельный шаг, и расширение за него не берётся, потому что не знает, как устроен именно ваш репозиторий.
Почему на обзорной странице раздела написано, что статьи нет?
Потому что обзорная страница состоит из ссылок: указатель методов, список компонентов, карта раздела. Когда тела статьи не находится или больше четверти текста приходится на подписи ссылок, расширение отдаёт шапку с адресом. Такие страницы в переносе всё равно обычно пересобирают заново – оглавление проще написать, чем чинить его по кускам чужой навигации.
Чего Clean Web Clipper не делает при переносе документации?
Clean Web Clipper не обходит сайт: одна страница за раз, та, что перед вами, без краулера и пакетной обработки – на документацию в двести страниц придётся двести клипов. Он не скачивает картинки и схемы, они остаются ссылками на исходный сайт. Врезки и предупреждения становятся цитатами, потому что стандартного синтаксиса для них в Markdown нет: содержимое сохраняется, оформление нет. И он не пересобирает ни внутренние ссылки документации, ни её оглавление.
Как срезается навигация, описано на странице об устройстве извлечения.
Что переживает перенос?
Точно ли сохраняется структура заголовков? Да. Уровни заголовков переносятся такими, какими они стоят в теле статьи, а пустые заголовки – частый след навигационных блоков – удаляются.
А врезки и предупреждения?
Можно ли обработать весь сайт документации?
Переписываются ли внутренние ссылки документации?
Работает ли на документации, которая рисуется на JavaScript?
Что придётся доделать руками?
Что происходит с пустыми заголовками? Пустые заголовки удаляются. Пустой заголовок – частый след навигационного блока, и в перенесённой документации он превращается в раздел-призрак: в оглавлении есть, содержимого нет.
Переносится ли оглавление документации?
Что делать с картинками и схемами?
Сохраняются ли ссылки внутри страницы?
#parameters остаётся такой же и работает внутри перенесённого файла, а вот ссылки на другие страницы достраиваются до абсолютных адресов исходного сайта.