Кому это · ·
Сохранить источник для цитирования с автором и датой
Чтобы сохранить источник для цитирования, закладки или скриншота мало: когда дойдёт до ссылки, автора и дату по ним уже не восстановить. Clean Web Clipper записывает заголовок, автора, дату публикации и адрес источника во фронтматтер каждого файла Markdown. Такой файл читается и находится через годы и не зависит ни от какого сервиса.
Откуда эти цифры: страница замера с версиями движков и датами
Что делать в день, когда надо сослаться?
Материал к тексту набирается быстро, а проверяется медленно. Вы прочли сорок страниц, из каждой взяли по фразе, а на вычитке выясняется, что к каждому утверждению нужен источник. У закладок нет даты, скриншоты не ищутся, а в файле с выписками лежат фразы без происхождения. Найти источник заново оказывается дольше, чем было прочитать его в первый раз.
Вторая беда – подпись. Многие инструменты заполняют поле автора первой правдоподобной строкой со страницы: названием рубрики, названием издания, подписью кнопки «поделиться». Неверная атрибуция дороже отсутствующей, потому что её не перепроверяют: поле выглядит заполненным, значит, ему верят.
Третий раз это возвращается уже после сдачи. Редактор или фактчекер просит показать источник, вы отправляете ссылку – а у него она открывается страницей входа, потому что подписка ваша, а не его. Или страницу успели переписать, и абзаца, на который вы опирались, там больше нет. Разговор из «вот источник» превращается в «поверьте, я читал», и весит он ровно столько же, сколько любое другое воспоминание.
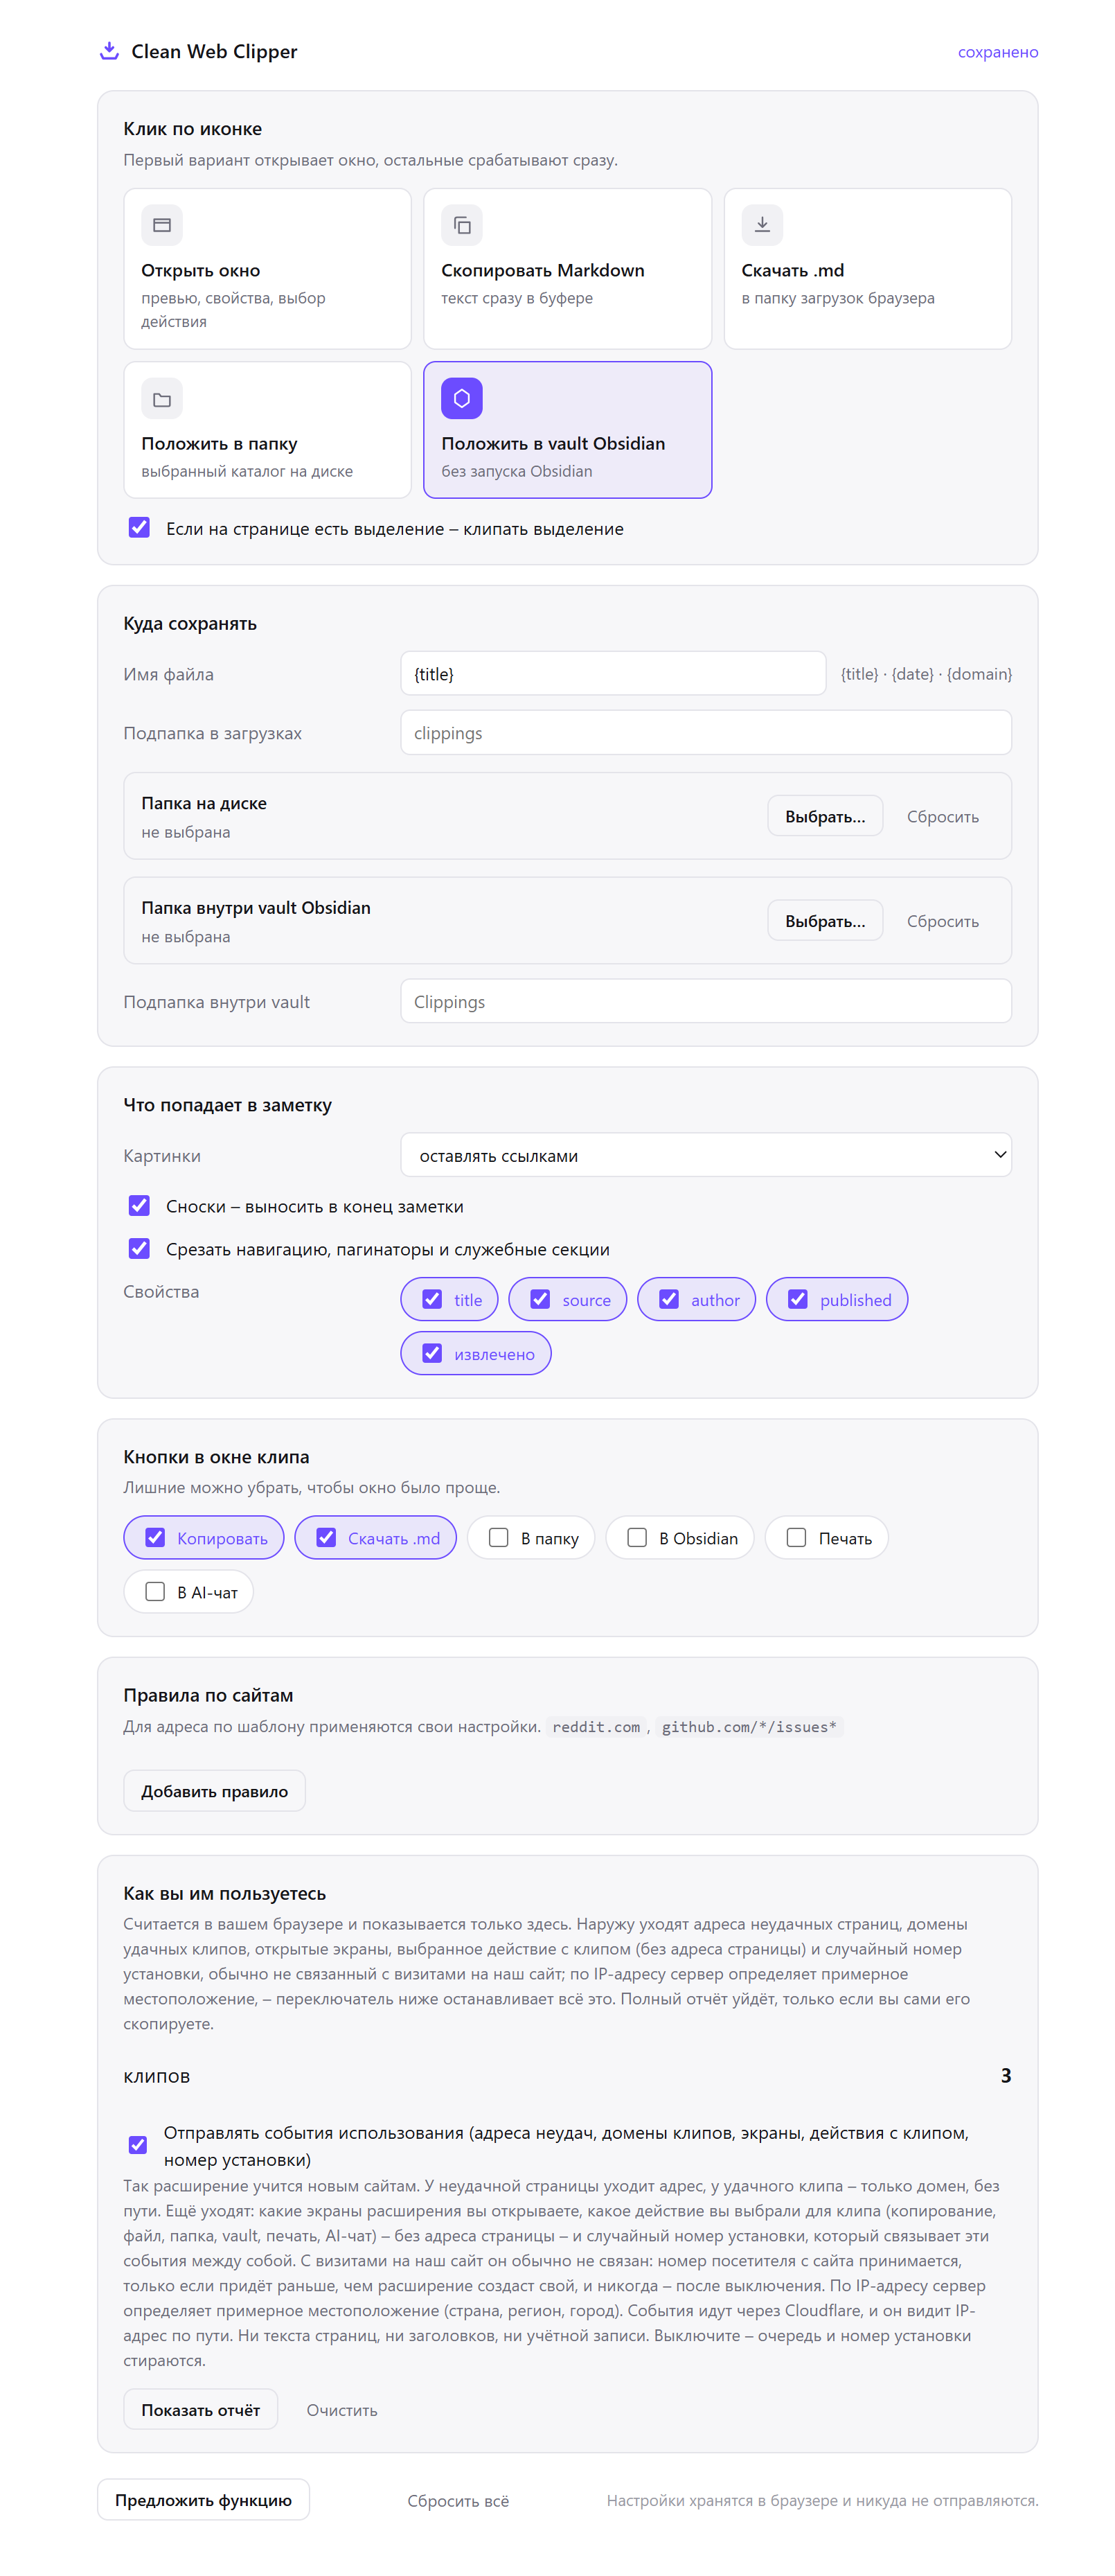
Что несёт каждая заметка?
- Заголовок, автор, дата публикации и адрес источника – во фронтматтере каждого файла
- Автор ищется в структурированных данных и подписях, ложные срабатывания отсеиваются
- Тело статьи без навигации и рекламных блоков – готовое к цитированию: на 512 замеренных страницах ни одного остатка HTML
- Клип выделения оставляет один абзац и его контекст, если больше не нужно
- Вид «Просмотр» позволяет проверить клип до того, как он ляжет в папку
- Файлы попадают в вашу папку, в формате, который не контролирует ни один сервис
- Хвост подписи режется по стоп-словам: всё после «фото», «источник» или «опубликовано» в поле author не попадает
- Строка длиннее восьми слов автором не считается – целый абзац в это поле не приедет
---
title: "Faster! Louder! Brighter! How the attention economy overwhelmed children’s TV"
source: "https://www.theguardian.com/news/2026/sep/17/faster-louder-brighter-how-the-attention-economy-overwhelmed-childrens-tv"
author: "Natalia Kucirkova"
date: "2026-09-17T04:00:39.000Z"
extraction: "dom"
---
Photograph: Guardian Design/Getty Images/Netflix/Fantorangen/Ludo Studio/Zach Hyman/ ZUMA Press, Inc./Apple TV

Does your child’s favourite show give them a chance to reflect, or does it move too quickly for its lessons to sink in?

-   A version of this piece was originally published on [Aeon](https://aeon.co/) as [The bombarding of childhood](https://aeon.co/essays/its-not-just-screen-time-kids-are-bombarded-by-hectic-media)


By [Natalia Kucirkova](https://www.theguardian.com/profile/natalia-kucirkova)
…
Как собирать материал к тексту
Порядок рассчитан на текст, который пишется неделями, а вычитывается за один вечер. Всё, что делается здесь, делается ради того вечера.
- Заведите на диске папку под текст и подпапки по главам, а в настройках, в разделе «Куда сохранять», укажите эту папку и шаблон имени
{date}-{domain}-{title}. Три текста в одной подборке легко называются одинаково; домен и дата различают их сразу. - В разделе «Что попадает в заметку» откройте «Свойства» и оставьте все пять полей. На вычитке первыми смотрят
authorиdate, аsource– то, что вы отправите редактору вместо пересказа. - Оставьте «Клик по иконке» на «Открыть окно». Поле автора стоит проверять глазами: расширение скорее оставит его пустым, чем впишет туда название рубрики, и заметить этот пропуск надо до того, как файл ляжет в папку.
- Читая, клипайте не всю страницу, а тот абзац, который пойдёт в дело: выделите его до нажатия. Фронтматтер у выделения тот же самый, так что происхождение цитаты сохраняется, а лишних сорока тысяч знаков в подборке не заводится.
- В окне сверьте заголовок и дату с тем, что видите на странице: из них складывается имя файла. Если они неверны, поправьте имя уже сохранённого файла сразу – потом это делать некогда, а искать по неверному имени вы будете дольше, чем правили бы его сейчас.
- Перед сдачей пройдитесь поиском по папке главы. Каждая цитата ищется по трём словам, а рядом с ней в том же файле лежит адрес – на вопрос «откуда» ответ занимает секунду, а не полчаса.
Какие настройки подходят для сбора материала?
Для сбора материала настройки Clean Web Clipper оптимизируют один момент – тот, когда к утверждению нужен источник. Всё остальное в них подчинено ему.
| Настройка | Значение | Почему именно так |
|---|---|---|
| Имя файла | {date}-{domain}-{title} | в подборке к главе три материала часто называются похоже; домен и дата разводят их сразу |
| Папка на диске | подпапка на главу | поиск по главе точнее поиска по всему архиву, а глав в книге обычно не больше двадцати |
| Свойства | все пять полей | на вычитке первыми смотрят author и date; extraction объясняет спорный случай |
| Клик по иконке | Открыть окно | нет строки author – нормальный результат, но увидеть его надо до сохранения, а не на вычитке |
| Если на странице есть выделение – клипать выделение | включено | в дело идёт один абзац, а не вся статья, и подборка не разбухает |
| Картинки | оставлять ссылками | подпись под фотографией нередко и есть источник факта, который вы берёте |
| Срезать навигацию | включено | списки «Читайте также» приклеивают к тексту чужие заголовки, и цитата потом ищется не в той статье |
…
But the more Carson studied and wrote about nature, the more cautious she became of humanity’s rampant quest to dominate it. Witnessing the devastation of the atomic bomb awakened her to the unintended consequences of science unmoored from morality, of a hysterical enthusiasm for technology that deafened humanity to the inner voice of ethics. In her 1952 acceptance speech for the John Burroughs Medal, she concretized her credo:

> It seems reasonable to believe — and I do believe — that the more clearly we can focus our attention on the wonders and realities of the universe about us the less taste we shall have for the destruction of our race. Wonder and humility are wholesome emotions, and they do not exist side by side with a lust for destruction.
…
Пройти три сценария целиком
Три сценария показывают, зачем нужна атрибуция во фронтматтере: вычитка, где к каждому факту требуют источник, цитата из статьи, недоступной редактору, и подборка материала, которая собирается месяцами. В каждом решает не память о том, что было прочитано, а строка в файле, и в каждом расширение находит эту строку раньше, чем вы вспомните адрес сами.
Вычитка, на которой к каждому факту нужен источник
Текст написан, и редактор прислал сорок вопросов вида «откуда это». Раньше на такое уходил день: закладки без дат, файл с выписками без происхождения, память о том, что «это была статья с синим сайтом».
Теперь на каждый вопрос отвечает поиск по папке главы. Файл находится по фразе, в его второй строке адрес, в третьей – автор, в четвёртой – дата публикации. Проверять сам факт расширение, разумеется, не помогает: сомнительный источник, аккуратно склипанный, остаётся сомнительным источником.
Цитата из статьи, до которой у редактора нет доступа
Ключевой абзац лежит в материале по подписке. Ссылка редактору не поможет – у него откроется страница входа. Вы клипаете статью в тот момент, когда читаете её под своим логином: расширение снимает то, что браузер отрисовал для вас.
В папку ложится файл с полным текстом, автором и датой. Его можно приложить к правкам целиком – это обычный текст, а не запись в чьём-то сервисе. Заверенной силы у такой копии нет и быть не может, но для разговора с редактором её достаточно.
Подборка к главе, которая пишется полгода
Глава книги собирается медленно, и материал к ней приходит с интервалом в недели. Каждая находка едет в свою подпапку с датой в имени, поэтому подборка сама выстраивается в хронологию темы, а не в порядок вашего чтения.
Через полгода вы открываете папку и видите двадцать файлов, у каждого из которых происхождение написано в первых строках. Часть источников к этому времени уже переехала или закрылась – но текст остался у вас, а не на чужом сервере.
Чем это отличается от привычных способов?
Материал к тексту собирают пятью способами. Ни один из них не плох сам по себе – просто ломаются они в разных местах, и обычно в самый неудобный момент.
| Способ | Что получается | Чего стоит |
|---|---|---|
| Закладки в браузере | быстро и бесплатно | нет ни даты, ни автора, ни текста; страница за подписку у второго человека не откроется |
| Копировать в общий файл выписок | всё в одном месте | происхождение куска теряется на второй неделе, и на вычитке восстанавливать его дольше, чем читать заново |
| Снимок экрана статьи | фиксирует ровно то, что было на экране | не ищется, не цитируется, и подпись автора на нём приходится разбирать глазами |
| Сервис отложенного чтения | текст без обвязки и с синхронизацией | формат чужой, экспорт бывает не всегда, а библиотека живёт по правилам сервиса |
| Сохранить в приложение заметок | удобно и привычно | поле автора обычно заполняется первой правдоподобной строкой со страницы, и это заметно не сразу |
| Clean Web Clipper | текст, автор, дата и адрес в одном файле у вас на диске | библиографию не оформляет, факты не проверяет и ненайденного автора не додумывает |
Что делать, если атрибуция не сошлась?
В авторе и тексте клипа Clean Web Clipper чаще всего смущают четыре вещи: нет строки author, название издания вместо имени человека, оборванный на середине текст и дата, которая не совпадает с напечатанной на странице. Каждый случай объясняется устройством расширения, а не сбоем в конкретном клипе, и в большинстве случаев поле можно поправить руками, если это нужно.
Почему нет строки author?
Потому что имя не нашлось там, где его ищут: сначала в структурированных данных, затем в метатегах author, article:author и citation_author, затем в подписях с атрибутами rel="author" и itemprop, в блоках с классами byline и author.
Отсутствие строки – это результат, а не сбой. Выбор здесь сделан осознанно: неверная подпись дороже отсутствующей, потому что её никто не перепроверяет. Впишите имя руками – файл ваш.
Почему в поле автора оказалось название издания?
Значит, страница объявила его автором сама – например, в структурированных данных. Расширение отсеивает по форме строки: имена крупных площадок, слова «admin», «staff», «team», строки без букв и начинающиеся с даты в поле не попадают. Но если сайт честно подписывает материал названием редакции, это и есть его подпись, и расширение её не оспаривает.
Почему текст обрывается на середине?
Текст, оборванный на середине, – обычно пейволл. Расширение снимает то, что браузер отрисовал: если под катом лежит призыв подписаться, а не текст, в клип попадёт ровно видимая часть. Войдите под своей подпиской, дождитесь полной отрисовки и нажмите на значок расширения ещё раз – окно соберёт клип заново с той же вкладки.
Почему дата не совпадает с той, что напечатана на странице?
Дата берётся из метаданных, а не из текста. Расхождение почти всегда означает, что на странице напечатана дата обновления, а в разметке лежит дата первой публикации – или наоборот. Поле extraction подскажет, откуда взят сам текст, а какая дата вам нужна, решаете вы: обе честные, но отвечают на разные вопросы о жизни страницы.
Чего Clean Web Clipper не допишет в источник для цитаты?
Clean Web Clipper не дописывает автора, если страница его не даёт: строки author тогда нет: пустое поле лучше выдуманного имени. Он не сохраняет ни вёрстку, ни скриншоты – только текст и его структуру. Он не ведёт библиографию и не оформляет ссылки по стилям. И он ничего не проверяет за вас: сомнительный источник, аккуратно склипанный, остаётся сомнительным источником.
Как зафиксировать страницу до правки, разобрано на странице для журналистов.
Что клип сохраняет без искажений?
Сохраняется ли автор? Когда страница его называет. Расширение читает структурированные данные и подписи и отсеивает ложные срабатывания – названия рубрик, имена изданий, подписи кнопок, – вместо того чтобы класть в поле первую правдоподобную строку.
Можно ли оставить картинки?
А статьи по подписке?
Меняется ли текст?
Найду ли я цитату через полгода?
Что с соавторами, врезками и фронтматтером?
А если у материала несколько авторов? В поле попадёт один – тот, что нашёлся первым в порядке проверки источников. Соавторов расширение не собирает в список: гадать, где кончается имя и начинается должность, оно не берётся. Допишите остальных руками.
Что происходит с врезками и выделенными цитатами?
>. Для врезок отдельного правила нет: собранная из обычных блоков приходит простыми абзацами, короткая врезка в боковом элементе (aside) может быть срезана. Оформление теряется, а содержимое остаётся на своём месте в тексте.Можно ли поправить фронтматтер после сохранения?
Клипается ли материал, который раскрывается по кнопке «читать дальше»?
Что означает поле extraction в моих файлах?
dom – из того, что браузер отрисовал; jsonld-articlebody – из структурированных данных, когда там лежало тело статьи длиннее видимого; no-article – статьи на странице не нашлось вовсе.